Die Entwickler von Immich haben nach der Kritik bzgl. der „Unlicensed“ Meldung nachgebessert und die Meldung heißt nun „Buy Immich“. Wie zuvor wird diese Meldung unten links angezeigt. Nach einem Klick auf die Meldung...
In diesem Überblick beschreibe ich am Beispiel der Proxmox inventory source, wie eine eigene Inventory Source im Ansible Automation Controller hinzugefügt werden kann.
Die folgenden Schritte wurden mit der Ansible Automation Platform 2.4 getestet. Die einzelnen Schritte sollten in gleicher Weise auch in Ansible AWX ausgeführt werden können.
Um diesem Text folgen zu können, werden Kenntnisse im Umgang mit Ansible und Git auf der Kommandozeile vorausgesetzt.
Der Text verweist, wo möglich, auf bestehende Dokumentation. Es handelt sich bei diesem Text nicht um ein klassisches Tutorial. Er dient mir als Gedächtnisstütze und mag euch eine Anregung sein, bzw. im besten Fall die Wissenslücken schließen, die sich mit der Dokumentation allein nicht schließen lassen.
Für das Beispiel in diesem Text werden Hosts aus der Bestandsliste eines PVE als Inventory Source hinzugefügt. Die dabei verwendete Vorgehensweise kann auch für andere Inventory Plugins verwendet werden. Die Entwicklung von Inventory Plugins ist jedoch nicht Gegenstand dieses Textes. Hierzu wird auf die Dokumentation unter „Developing dynamic inventory“ verwiesen.
Mein Kollege Steffen Scheib hat mir geholfen, das Proxmox-Plugin zu konfigurieren, wofür ich ihm an dieser Stelle nochmal ganz herzlich danke. Es liegt auf meiner Arbeitsstation als Ansible Project in folgender Verzeichnisstruktur vor:
Mit Ausnahme der Datei vault_password_file wurden alle Dateien und Verzeichnisse in Git aufgenommen. Ich verwende einen einfachen Git-Server in meiner Laborumgebung, auf welchen ich meine lokalen Repositorys pushe. Der Automation Controller synchronisiert das Projekt aus dem Git-Repo, um es als Inventory Source verfügbar zu machen.
Das Proxmox Inventory Plugin befindet sich in einem Git-Repository, auf welches mit SSH-Key-Authentifizierung zugegriffen werden kann. Damit auch der Automation Controller auf dieses Repository zugreifen kann, wird ein Credential vom Typ Source Control erstellt.
Beipsiel für einen Source Control Credential Typ im Ansible Automation Controller
Der SSH-Private-Key wurde von meinem Host hochgeladen und verschlüsselt im Automation Controller gespeichert. Der Key lässt sich in der GUI nicht wieder sichtbar machen, lediglich ersetzen.
Die Datei vault_password_file befindet sich jedoch nicht im Git, da sie das Passwort im Klartext enthält. Aus diesem Grund möchte ich die Datei auch nicht auf dem Automation Controller ablegen. Irgendwie müssen auf dem Automation Controller jedoch Credentials hinterlegt werden, um die Ansible Vault encrypted_strings zu entschlüsseln. Die Lösung steckt in diesem Kommentar auf Github. Im Automation Controller User Guide gibt es dazu Chapter 11. Custom credential types.
Das Schlüssel-Wert-Paar secret: true stellt sicher, dass das Passwort verschlüsselt gespeichert wird. Es kann danach im Automation Controller nicht mehr im Klartext angezeigt werden. Nachdem der neue Credential Typ erstellt ist, kann dieser instanziiert werden:
Beispiel des neuen Custom Credential Typs ‚encrypted_vault_password‘
Das Vault Passwort wird in das entsprechende Formularfeld kopiert. Es ist standardmäßig nicht sichtbar und wird wie oben bereits erwähnt, verschlüsselt gespeichert. Mit diesem Credential verfügt der Automation Controller nun über die notwendigen Informationen, um das Proxmox Inventory auszulesen.
Mit der Veröffentlichung von Immich v1.109.0 haben die Entwickler optionale Lizenzen angekündigt. Man bekommt nun unten links angezeigt, dass man eine unlizenzierte Version einsetzt, sofern man keine Lizenz gekauft hat. Nachfolgend beide Lizenzoptionen und...
Das mit Firefox 128 und der „Privacy Preserving Attribution“ (PPA) Funktion dürften die meisten mitbekommen haben. Ich zeige euch in diesen Beitrag, wie ihr die PPA Funktion unter Linux, Windows, macOS und Android deaktivieren...
🚀 Schnell: geschrieben in Rust für blitzschnelle Geschwindigkeit und Speichersicherheit ☁️ Leicht: kein JavaScript, keine Werbung, kein Tracking, keine Aufblähung 🕵 Privat: alle Anfragen werden über den Server geleitet, einschließlich Medien 🔒 Sicher: starke Content Security Policy verhindert Browser-Anfragen an Reddit
Browser Addons:
Mit dieser Erweiterung könnt ihr sämtlichen Reddit Traffic in eurem Browser auf eine Redlib Instanz umleiten.
Das Betreiben der Dienste, Webseite und Server machen wir gerne, kostet aber leider auch Geld.
Unterstütze unsere Arbeit mit einer Spende und diskutiere in unserem Chat mit.
Seit Firefox 127 kann man sich das Wetter auf der Startseite anzeigen lassen. Startet euren Firefox, gebt in der Adresszeile about:config ein und bestätigt die Warnung. Sucht nach browser.newtabpage.activity-stream.system.showWeather und stellt den Wert mit...
In diesem Beitrag gebe ich einige Beispiele mit Erklärungen zu Ansible Conditionals, welche mir in der Dokumentation fehlen. Dieser Artikel dient mir zur Erinnerung und mag Einsteigern helfen, ein besseres Verständnis der Bedingung is defined zu gewinnen.
Wird in einem Task eine Variable verwendet, welche nicht definiert ist, bricht Ansible die Verarbeitung eines Playbooks mit einem Fehler ab. Der folgende Code-Block zeigt ein einfaches Playbook mit anschließender Ausgabe des Playbooklaufs, um dies zu verdeutlichen. Der Task beinhaltet dabei bereits eine Bedingung. Er soll nur dann ausgeführt werden, wenn die Variable my_var den Wert Hello world! enthält.
]$ cat test_conditionals.yml
---
- name: Play around with conditionals
  hosts: localhost
  gather_facts: false

  tasks:
    - name: >-
        When all conditionals are met, print the variable value using
        ansible.builtin.debug
      when:
        - my_var == "Hello world!"
      ansible.builtin.debug:
        var: my_var

]$ ansible-playbook -i hosts test_conditionals.yml

PLAY [Play around with conditionals] *******************************************

TASK [When all conditionals are met, print the variable value using ansible.builtin.debug] ***
fatal: [localhost]: FAILED! => {"msg": "The conditional check 'my_var == \"Hello world!\"' failed. The error was: error while evaluating conditional (my_var == \"Hello world!\"): 'my_var' is undefined. 'my_var' is undefined\n\nThe error appears to be in '/home/tronde/ansible/test_conditionals.yml': line 7, column 7, but may\nbe elsewhere in the file depending on the exact syntax problem.\n\nThe offending line appears to be:\n\n  tasks:\n    - name: >-\n      ^ here\n"}

PLAY RECAP *********************************************************************
localhost                  : ok=0    changed=0    unreachable=0    failed=1    skipped=0    rescued=0    ignored=0
Der Text 'my_var' is undefined in obiger Fehlerausgabe benennt den Grund des Scheiterns.
Nun gibt es Fälle, in denen Tasks, welche undefinierte Variablen enthalten, nicht zum Abbruch des gesamten Playbooks führen sollen. Stattdessen soll der betroffene Task einfach übersprungen werden. Dies erreicht man mit der Bedingung `is defined`. Der nächste Code-Block liefert wieder ein Beispiel dazu.
]$ cat test_conditionals.yml
---
- name: Play around with conditionals
  hosts: localhost
  gather_facts: false

  tasks:
    - name: >-
        When all conditionals are met, print the variable value using
        ansible.builtin.debug
      when:
        - my_var is defined
        - my_var == "Hello world!"
      ansible.builtin.debug:
        var: my_var

]$ ansible-playbook -i hosts test_conditionals.yml

PLAY [Play around with conditionals] *******************************************

TASK [When all conditionals are met, print the variable value using ansible.builtin.debug] ***
skipping: [localhost]

PLAY RECAP *********************************************************************
localhost                  : ok=0    changed=0    unreachable=0    failed=0    skipped=1    rescued=0    ignored=0
Der Task mit der undefinierten Variable wurde übersprungen (skipped) und das Playbook erfolgreich beendet.
Im nächsten Beispiel habe ich die Variable my_var im Playbook definiert und den passenden Wert zugewiesen.
]$ cat test_conditionals.yml
---
- name: Play around with conditionals
  hosts: localhost
  gather_facts: false
  vars:
    my_var: Hello world!

  tasks:
    - name: >-
        When all conditionals are met, print the variable value using
        ansible.builtin.debug
      when:
        - my_var is defined
        - my_var == "Hello world!"
      ansible.builtin.debug:
        var: my_var

]$ ansible-playbook -i hosts test_conditionals.yml

PLAY [Play around with conditionals] *******************************************

TASK [When all conditionals are met, print the variable value using ansible.builtin.debug] ***
ok: [localhost] => {
    "my_var": "Hello world!"
}

PLAY RECAP *********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=0    rescued=0    ignored=0
Das war auch schon alles für heute. Ihr seht, es ist keine Hexerei. Mir hilft es, die Bedeutung von is defined zu erinnern, wenn ich es einmal aufgeschrieben habe.
Zum Ende gibt es noch einen Code-Block, der zeigt, dass dies auch mit Dictionaries funktioniert:
]$ cat test_conditionals.yml
---
- name: Play around with conditionals
  hosts: localhost
  gather_facts: false
  vars:
    my_dict:
      my_var: Hello world!

  tasks:
    - name: >-
        When all conditionals are met, print the variable value using
        ansible.builtin.debug
      when:
        - my_dict.my_var is defined
        - my_dict.my_var == "Hello world!"
      ansible.builtin.debug:
        var: my_dict.my_var

]$ ansible-playbook -i hosts test_conditionals.yml

PLAY [Play around with conditionals] *******************************************

TASK [When all conditionals are met, print the variable value using ansible.builtin.debug] ***
ok: [localhost] => {
    "my_dict.my_var": "Hello world!"
}

PLAY RECAP *********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=0    rescued=0    ignored=0
In der Kategorie Ansible findet ihr weitere Artikel rund um Ansible. Viel Spaß beim Stöbern.
Das Betreiben der Dienste, Webseite und Server machen wir gerne, kostet aber leider auch Geld.
Unterstütze unsere Arbeit mit einer Spende und diskutiere in unserem Chat mit.
Das Betreiben der Dienste, Webseite und Server machen wir gerne, kostet aber leider auch Geld.
Unterstütze unsere Arbeit mit einer Spende und diskutiere in unserem Chat mit.
Dem Forscherteam von Qualys ist es gelungen, eine ältere Sicherheitslücke in OpenSSH, die schon eigentlich längst geschlossen war, erneut auszunutzen. Die neue Lücke wird als CVE-2024-6387 geführt und ist deswegen brisant, weil Sie bei Erfolg dem Angreifer Root-Rechte ohne vorherige Authentifizierung ermöglicht. Die nötigen Bedingungen für ein Ausnutzen der Lücke sind allerdings nicht ganz trivial.
Die gesamte Erläuterung der Sicherheitslücke ist im Bericht von Qualys umfangreich erläutert wollen. Wenn wir es schaffen, werden wir diesen schon Mittwoch im Risikozone-Podcast detaillierter erläutern.
So viel sei gesagt: die Lücke existierte schon mal als CVE-2006-5051, wurde dann gefixt und konnte jetzt (erstmals) ausgenutzt werden, da der eigentlich kritische Teil 2020 wieder versehentlich eingebaut wurde.
Der Fehler selber baut darauf, dass syslog() zur Protokollierung asynchron aufgerufen wird, obwohl die Funktion nicht "async-signal-safe" ist. Kann ein Angreifer Timingeigenschaften ausnutzen, wird er in die Lage versetzt, Code einzuschleusen, der in einem privilegierten Teil von OpenSSH ausgeführt wird. Der Zeitaufwand ist allerdings hierfür nicht zu unterschätzen, da das Codefragment nur bei einem Verbindungstimeout aufgerufen wird.
Es ist gemäß des Qualys-Berichtes hervorzuheben:
Die OpenSSH-Versionen vor 4.4p1 (2006) sind angreifbar, sofern sie nicht explizit gepatcht wurden.
Die OpenSSH-Versionen zwischen 4.4p1 und 8.5p1 (2021) hatten nicht den besagten Code drin.
Die OpenSSH-Versionen ab 8.5p1 hatten den Code wieder drin.
Mit OpenSSH 9.8p1 wurde die Lücke gepatcht.
Mit anderen Worten: abhängig von eurem System ist die Schwachstelle vorhanden, weswegen ihr in eure Distribution schauen solltet, ob es Updates gibt.
OpenSSH ist nichtsdestotrotz im Hinblick auf seine Rolle und Exposition eines der sichersten Programme der Welt. Die Software ist ein sehr stringent abgesicherter Dienst, der u. a. auf Sandboxing-Mechansimen setzt, um den Umfang der Codesegmente, die als root ausgeführt werden, gering zu halten. Diese Lücke ist eine der seltenen Situationen, in der trotzdem ein Security-Bug vorhanden ist. Dabei ist eine Ausnutzung vergleichsweise aufwändig.
Kurz notiert: Debian 10 mit dem Codenamen "buster" erreicht heute das End of Life. Die Unterstützung wurde bis 2022 vom Debian-Team bereitgestellt und dann bis zum heutigen Tage durch das LTS-Team sichergestellt. Damit wurde Debian 10 knapp fünf Jahre durchgängig unterstützt.
Debian 10 wurde am 6. Juli 2019 und somit vor knapp fünf Jahren veröffentlicht. Ausgeliefert wurde das Betriebssystem mit dem Linux-Kernel 4.19. Der letzte Point-Release erfolgte am 10. September 2022, damit endete auch der klassische Security-Support.
Anschließend hat das LTS-Team die Unterstützung am 1. August 2022 mit einer Teilmenge von Architekturen (amd64, i386, amd64, armhf) übernommen, damit Nutzer wichtige Sicherheitsupdates noch erhalten und die Gelegenheit haben, auf den Folge-Release umzustellen. Diese Unterstützung läuft am heutigen Tage aus.
Es ist somit an der Zeit, auf Debian 11 mit dem Codenamen "bullseye" umzustellen. Die Migrationsanleitung ist in den Release Notes für Debian 11 zu finden. Hier wird auch erläutert, mit welchen Breaking Changes zu rechnen ist. Wie üblich, lässt sich der Release über die APT-Konfiguration anheben, gefolgt von einem Upgrade über APT. Die wichtigste Änderung dabei ist, dass das Security-Archiv ein neues Layout hat. Ich habe einige Systeme schon aktualisiert, dabei gab es bei mir keine Probleme. Das sollte auch bei anderen Systemen keine Schwierigkeiten bereiten, wenn sich an den offiziellen Debian-Paketquellen orientiert wird. Die Backports sollte man aber kontrollieren, wenn z. B. ein Backports-Kernel genutzt wurde, um WireGuard schon mit Debian 10 nutzen zu können (erst Debian 11 hat eine Kernelversion, in der WireGuard integriert ist).
Aktuell werden vom Debian-Team die Versionen 11 (bullseye) und 12 (bookworm) als Hauptversionen gepflegt. Das LTS-Team ist eine Gruppe von Freiwilligen, die sich zum Ziel gesetzt hat, eine fünfjährige Unterstützung für Debian-Versionen sicherzustellen. Wer eine zehnjährige Unterstützung benötigt, kann auf entgeltliche ELTS-Angebote wie z. B. von Freexian zurückgreifen.
Soeben ist die dritte Auflage meines Python-Bestsellers erschienen:
Für die 3. Auflage habe ich das Buch im Hinblick auf die Python-Version 3.12 aktualisiert. Neu hinzugekommen ist das Kapitel »Python lernen mit KI-Unterstützung«. Es zeigt, wie Ihnen ChatGPT oder ein vergleichbares KI-Tool beim Erlernen von Python helfen kann. Ebenfalls neu ist ein Abschnitt zur Nutzung von Python direkt in Excel.
Viele Beispiele aus der Praxis sowie Übungsaufgaben helfen dabei, Python ohne allzu viel Theorie kennenzulernen. Im handlichen Taschenbuchformat ist das Buch auch unterwegs ein idealer Begleiter. Mehr Details zum Buch gibt es hier:
Das Buch „Nextcloud Schnelleinstieg“ von Herbert Hertramph ist in der 1. Auflage 2023 im mitp-Verlag erschienen. Es trägt den Untertitel „Der leichte Weg zur eigenen Cloud – Daten sicher speichern und teilen“. Das Buch hat insgesamt 224 Seiten und ist für Nutzer konzipiert, die sich für die Verwendung von Nextcloud entschieden haben oder dies planen. Es bietet einen umfassenden Einblick in die Funktionalitäten und die Handhabung dieser besonderen Open-Source-Cloud.
Dieses Buch geht weniger auf Installationsmöglichkeiten der Nextcloud ein, gibt aber wertvolle Tipps, wie der Nutzer an eine eigene Nextcloud gelangt, ob als selbst installiertes Filesharing-System auf einem Einplatinencomputer, wie dem Raspberry Pi, einem angemieteten vServer oder als gemanagte Cloud bei einem Nextcloud-Spezialisten.
In seinem Buch konzentriert sich der Autor ausschließlich auf die Benutzung der Nextcloud. Er erklärt den Aufbau und die Funktionen auf eine klare und verständliche Art. Der Einsatz vieler Grafiken und Screenshots unterstützt diese Erklärungen und macht sie leicht nachvollziehbar.
Im Buch von Herbert Hertramph wird keine spezifische Nextcloud-Version genannt, was aufgrund der häufigen Veröffentlichung neuer Hauptversionen des Open-Source-Projekts in etwa alle sechs Monate auch kaum möglich ist.
Herbert Hertramph zeigt anschaulich die vielfältigen Möglichkeiten, die sich durch die Anwendungen Dateien zur Dateiverwaltung, Kalender und Kontakte ergeben. Er erläutert, wie Daten einfach geteilt werden können und wie kollaboratives Arbeiten in der Cloud funktioniert. Zudem werden spannende Apps wie Aufgaben und Deck genauer betrachtet. Deck ist ein nützliches Kanban System zur Planung und Umsetzung eigener Projekte. Mail und Talk werden ebenfalls ausführlich erklärt: Mail ist ein in die Cloud integrierter eMail-Client und Talk eine eigenständige Anwendung für Videokonferenzen.
Außerdem wird detailliert besprochen, wie arbeitserleichternde Clients für PC und Mobiltelefone genutzt werden können und wie Daten, Kontakte und Kalender mit diesen Geräten synchronisiert werden können.
Nextcloud ist ein hochwertiges, ausgereiftes und kostenfreies System, das in zahlreichen Unternehmen und Bildungseinrichtungen eingesetzt wird. Es wurde in Deutschland entwickelt, ist Open Source und bietet eine transparente Plattform. Anders als herkömmliche Cloud-Lösungen umfasst Nextcloud neben den Grundfunktionen wie Filesharing auch einen E-Mail-Client, Video-Konferenzmöglichkeiten und die Integration eines Online-Office, was es zu einem umfassenden Enterprise-Produkt macht.
Das Buch gliedert sich in folgende Kapitel:
Die Grundlagen
Anmeldung und Rundgang
Dateimanagement
Einstellungssache: Nextcloud anpassen
Geteilte Cloud ist doppelte Cloud: (Mit-)Benutzer einrichten
Terminmanagement: Vom Kalender bis zur Buchungsverwaltung
Ich kann dieses Buch jedem empfehlen, der bereits über die Verwendung von Nextcloud nachdenkt oder bereits ein solches System nutzt. Selbst erfahrene Nutzer werden wahrscheinlich noch nützliche Hinweise darin finden. Insgesamt bin ich der Meinung, dass es sich lohnt, das Buch anzuschaffen.
Und in diesem Text möchte ich euch mitteilen, welche Faktoren zu meiner Zufriedenheit beitragen.
Seit März 2023 arbeite ich als Senior Technical Account Manager (TAM) bei Red Hat. In diesem Artikel habe ich beschrieben, wie eine Arbeitswoche für mich aussehen kann.
Doch was gefällt mir nun so sehr an diesem Job?
Ich arbeite full remote. Dies passt aktuell am besten zu meinen Lebensumständen. Hier findet sich ein Erfahrungsbericht dazu.
Dass ich nicht mehr pendeln muss, gibt mir mehr Zeit für die Familie und schont die Umwelt.
Unser gesamtes Team arbeitet full remote und alle beherrschen unsere Tools, sodass die Zusammenarbeit reibungslos klappt.
Wir haben eine tolle Unternehmenskultur und ich fühlte mich selten von so hilfsbereiten Menschen umgeben.
Diese Kultur motiviert mich, mich selbst stets einzubringen und zu unterstützen, wo ich kann.
Wir haben anspruchsvolle Ziele und stets mehr als genug zu tun. Dennoch nehmen wir uns stets die Zeit einander zu helfen, unser Wissen zu teilen.
Wenn jemand mal nicht direkt helfen kann, wird man nicht mit Sätzen wie: „Dafür bin ich nicht zuständig.“ oder „Da kenne ich mich selbst nicht mit aus.“ abgespeist. Bei uns hört man dann eher:
„Da kann ich dir leider nicht direkt helfen, aber versuch es mal bei XY, die haben mir schonmal in einer ähnlichen Angelegenheit geholfen.“
Oder die Anfrage wird direkt an das richtige Team weitergeleitet
Wir sind in unserer Arbeitsweise sehr frei. Es gibt kein Mikromanagement. Unser aller Ziel ist, unseren Enterprise-Kunden eine gute Erfahrung zu bescheren. Natürlich gibt es Leitlinien, die einen Rahmen vorgeben. Diese empfinde ich nicht als Einschränkung, sondern als richtungsweisend.
Im Zweifel haben wir das gemeinschaftlich gepflegte TAM Manual, das uns erklärt, wie was gemacht wird.
Wir ziehen Besprechungen nicht in die Länge. Wenn wir fertig sind, hören wir einfach auf. Selbst dann, wenn die Zeit noch nicht vorbei ist.
Natürlich gibt es auch bei Red Hat genug Dinge, die verbessert werden können bzw. sollten. Doch konzentriere ich mich hier bewusst auf die Punkte, die zu meiner Zufriedenheit führen, um mich daran zu erfreuen.
Die obigen Punkte beziehen sich nicht ausschließlich auf mein eigenes Team. Ich erlebe dies regelmäßig auch teamübergreifend. Das ist eine tolle Erfahrung.
Mein Tipp für euch: Denkt nicht immer nur an Dinge, die euch nicht gefallen. Macht euch aktiv der Dinge bewusst, die euch gefallen und motivieren. Ihr werdet evtl. erstaunt sein, wie viel Energie ihr draus schöpfen könnt. Mich hat bspw. die Methode Journaling dabei unterstützt, zu einem positiven Mindset zu finden.
Was gefällt euch besonders an eurem Job? Teilt eure Gedanken und Erfahrungen gerne mit uns.
Liebe Leser*innen, heute seid ihr gefragt. Denn ich möchte von euch wissen, welchen Laptop und welche Linux-Distribution, ihr für ältere, nicht EDV-affine Menschen und Windows-Umsteiger empfehlen könnt.
Hardware
Der Laptop soll über folgende Merkmale verfügen:
Größe: 15-17 Zoll
Webcam
Mikrofon und Lautsprecher
für Videokonferenzen
zum Schauen von Videos in sozialen Netzwerken
Linux- und Windows-Unterstützung
Die Unterstützung von Linux und Windows ist sehr wichtig. Sollte der Feldversuch mit Linux scheitern, möchte auf der gleichen Hardware ein aktuelles Windows-Betriebssystem installieren können.
Mir schwebt etwas in der Richtung der Lenovo IdeaPad oder ein ThinkPad der L-Serie vor, ich bin jedoch auf eure Empfehlungen gespannt.
Desktop-Umgebung
Ich suche nach einer Desktop-Umgebung, die folgende Merkmale bietet:
Ein Startmenü, welches sich in der unteren linken Ecke befindet
Erstellungen von Anwendungsstartern und Verknüpfungen auf der Desktopoberfläche
Dies sind Muss-Kriterien, die unbedingt erfüllt sein müssen. Ich möchte, dass die Desktopoberfläche diese Eigenschaften in der Standardkonfiguration erfüllt und ich diese nicht erst konfigurieren oder drölfzig Plug-ins installieren muss, um diesen Zustand zu erreichen.
Software
Die wichtigsten Anwendungen sind:
Thunderbird für E-Mail
Aktuelle Webbrowser (Chrome/Firefox) für den Rest
Facebook
YouTube
Zoom, MS Teams, Webex und wie sie alle heißen
Ein PDF-Anzeigeprogramm
Libre/Open Office zum Lesen von MS Office-Dokumenten
Linux-Distribution
Die Linux-Distribution muss die oben genannten Anforderungen an die Desktop-Umgebung und die Software erfüllen und dabei stabil allerdings nicht steinalt sein.
Ich möchte nicht vor jeder Videokonferenz mit den Audio-Einstellungen kämpfen müssen, um deutlich zu machen, wo meine Priorität liegt.
Linux und Open Source Anwendungen für Autoren - Schriftsteller benutzen für die Erstellung von Romanen Autorenpgrogramme. Autorenprogramme sind spezielle Schreibprogramme für Autoren und Schriftsteller. Für Linux ist die Auswahl derartiger Anwendungen leider begrenzt. Bibisco läuft unter Linux (Debian, Ubunrtu, Fedora, Snap, Flatpak), Windows und auch MacOS. Da es zudem eine kostenfreie Version gibt, stellt es eine Alternative für angehende Autoren dar , die auch einmal ein Autorenpgrogramm ausprobierten möchten und keine herkömmliche Textverarbeitung wie Libre Office oder Word nutzen wollen.
Im Video zeige ich die wesentlichen Funktionsmerkmale von Bibisco.
🖋️ Zu meinem Gruselroman "Die Rache des Legionärs"
▶️ https://www.amazon.de/dp/B0CWTPBKW2?asin=B0CWTPBKW2&revisionId=c1fbf2dd&format=1&depth=1
Linux Bücher für Einsteiger von mir (Ebook und Taschenbuch):
▶️ https://www.amazon.de/~/e/B001K73R84
Brandneu: Linux Mint 21 - Schnellanleitung für Einsteiger
▶️ https://www.amazon.de/dp/B0BB9LGMPG
Weitere Videos zu Linux Distributionen findet Ihr in dieser Playlist:
▶️ https://www.youtube.com/watch?v=sdYcdG4mn98&list=PLl0zRfPkQ7Xu86XQgKbUhVRSBbHpUzxxM
Andere Kanäle von mir:
Joe loves Linux ▶️ https://www.youtube.com/channel/UCdI8plWGpNHwN1oswHi3iWA
Raketenheftleser ▶️ https://www.youtube.com/channel/UCyPNZr7yK8278QXQDMFnQag
Joe's Musik Check ▶️ https://www.youtube.com/channel/UCuB7gdAs73msDRUnlRRKv5Q
JJ Fotoshow ▶️ https://www.youtube.com/c/JoeTravels
Das Training auf einer virtuellen Maschine mit Fedora 40 Server, 10 CPU-Threads und 32 GB RAM dauerte 180 Std. 44 Min. 7 Sek. Ich halte an dieser Stelle fest, ohne GPU-Beschleunigung fehlt es mir persönlich an Geduld. So macht das Training keinen Spaß.
Nach dem Training mit ilab train findet man ein brandneues LLM auf dem eigenen System:
(venv) tronde@instructlab:~/src/instructlab$ ls -ltrh models
total 18G
-rw-r--r--. 1 tronde tronde 4.1G May 28 20:34 merlinite-7b-lab-Q4_K_M.gguf
-rw-r--r--. 1 tronde tronde  14G Jun  6 12:07 ggml-model-f16.gguf
Test des neuen Modells
Den Chat mit dem LLM starte ich mit dem Befehl ilab chat -m models/ggml-model-f16.gguf. Das folgende Bild zeigt zwei Chats mit jeweils unterschiedlichem Ergebnis:
Zwei Chats mit dem frisch trainierten LLM. Beide Male erhalte ich nicht die erhoffte Antwort.
Fazit
Schade, das hat nicht so funktioniert, wie ich mir das vorgestellt habe. Es kommt weiterhin zu KI-Halluzinationen und nur gelegentlich gesteht das LLM seine Unkenntnis bzw. seine Unsicherheit ein.
Für mich sind damit 180 Stunden Rechenzeit verschwendet. Ich werde bis auf Weiteres keine Trainings ohne Beschleuniger-Karten mehr durchführen. Jedoch werde ich mir von Zeit zu Zeit aktualisierte Releases der verfügbaren Modelle herunterladen und diesen Fragen stellen, deren Antworten ich bereits kenne.
Wenn sich mir die Gelegenheit bietet, diesen Versuch auf einem Rechner mit entsprechender GPU-Hardware zu wiederholen, werde ich die Erkenntnisse hier im Blog teilen.
Wer bist du, wie kommst du zur Stadt Dortmund und was tust du?
Ich bin Katharina Flisikowski und seit Kurzem im CIIO – Chief Information/Innovation Office der Stadt Dortmund für Digitale Souveränität und Open Source zuständig. Meinen Background habe ich in den Medien- und Sozialwissenschaften.
In der Vergangenheit habe ich im Projektmanagement gearbeitet sowie im Bereich Kommunikation und Transfer. Mehrere Jahre lang besetzte ich die Stabsstelle Qualität und Kommunikation eines interkulturellen Trägers der Sozialen Arbeit, wo ich viel über Organisationsstrukturen sowie die Optimierung von Prozessen gelernt habe.
Meine letzte Station war ein Leibniz-Projekt am Deutschen Bergbau-Museum Bochum. Dort entwickelte ich Konzepte für den Transfer von Wissen zwischen Forschung und Bürger*innen. Mit dem Ende des Projekts wollte ich mich weiterhin für einen offenen Zugang zu Wissen einsetzen. Passenderweise fiel das in die Zeit, in der die Stelle der Stadt Dortmund ausgeschrieben war – und hier bin ich nun!
Was begeistert dich am Thema Open Source?
Mich motiviert der Gedanke an eine starke, gleichberechtigte und selbstbestimmte Gesellschaft.
Aktuelle Entwicklungen, wie etwa Angriffe auf Infrastrukturen oder aber auch das Schüren von Ängsten durch Fake News und Verschwörungserzählungen, stellen dabei reale Gefährdungen dar, denen eine Demokratie wehrhaft begegnen muss.
Daher ist es für uns unerlässlich, die Fragen zu stellen: Wie wird Wissen hergestellt und verbreitet? Wie transparent sind Strukturen? Haben wir als Gesellschaft die Handlungsfähigkeit, die wir brauchen, um uns sicher und stark im physischen und digitalen Raum zu bewegen? Und wie schaffen wir es, uns technologisch und gesellschaftlich weiter- und nicht zurückzuentwickeln?
Als ein Teil Digitaler Souveränität bietet Open Source hierbei einen Ansatz, der in eben diese Richtung geht: Durch das Teilen von Wissen (über den Code hinaus) entsteht eine Transparenz, die Vertrauen schafft. Der multiple Blick auf Lösungen gibt einerseits Sicherheit, andererseits macht er Innovation und somit Fortschritt möglich. So werden wir als Gesellschaft zur selbstbestimmten Gestalterin unserer Zukunft – was will man mehr!
Einen weiteren Aspekt, den ich an Open Source sehr schätze, ist der Community-Gedanke: Ich finde es erstrebenswert, gemeinsam an Lösungen zu wirken, anstatt im Alleingang oder gar in Rivalität zu tüfteln und dann doch das Rad immer wieder neu zu erfinden. Kooperation und Kollaboration bringen uns hier viel weiter.
Was sind deine ersten Schritte als Koordinatorin für Digitale Souveränität und Open Source bei der Stadt Dortmund?
Da ich selbst nicht aus Dortmund komme, nutzte ich die erste Zeit dafür, die Stadt und die Menschen, die sie ausmachen, kennenzulernen. Dazu gehört auch, die Entwicklungen der Stadt Dortmund im Hinblick auf Digitale Souveränität zu betrachten, schließlich gibt es schon einige Ansätze und politische Beschlüsse in diese Richtung.
Als Nächstes geht es darum, aus dieser Bestandsaufnahme einen Fahrplan zu entwickeln. Hier freue ich mich darauf, in den Austausch mit einzelnen Akteur*innen zu treten, sowohl inner- als auch außerhalb der Dortmunder Stadtverwaltung. Die ersten Gespräche fanden bereits statt, nun gilt es, diese Kontakte zu vertiefen und weitere zu knüpfen.
Angesichts der ständigen Weiterentwicklung von Technologie und Gesetzgebung, wie hast du vor auf dem neuesten Stand zu bleiben und wie beeinflusst dies deine Herangehensweise an deine Projektplanung und -umsetzung im Bereich Digitaler Souveränität und Open Source?
Hier ist Netzwerk das Stichwort – Open Source lebt vom Community-Gedanken und genau hierin sehe ich auch die Stärke: Mit einem Pool an unterschiedlichen Expertisen, Erfahrungen und Blickwinkeln ist es möglich, verschiedene Aspekte zu durchleuchten und so zu neuen Erkenntnissen zu gelangen. Ich bin ein großer Fan des interdisziplinären Austauschs, weil man so voneinander lernen und sich weiterentwickeln kann. Wissen und Erfahrung sind wertvolle Ressourcen – diese zu teilen wiederum macht uns als Gesellschaft stark.
Was ist deine Hoffnung an deine neue Stelle für dich selbst, aber auch für die Aufgabe?
Ich hoffe, dass wir gemeinsam mit den vielen Beteiligten, Interessierten ebenso wie den noch nicht ganz Überzeugten einen Weg finden, das Thema Digitale Souveränität in unsere Alltagspraxis fest zu verankern. Für die Stadt Dortmund sind die ersten Weichen ja bereits gestellt, nun gilt es, das Triebwerk zu befeuern und Fahrt aufzunehmen.
Dabei geht es nicht darum, so schnell wie möglich und um jeden Preis sämtliche Strukturen abzulösen. Vielmehr geht es darum, Wahlmöglichkeiten und Handlungsspielräume zu erweitern, die Menschen mitzunehmen und ein Bewusstsein für Abhängigkeiten zu schaffen.
Persönlich erhoffe ich mir, dass wir mit unserer Arbeit einen Beitrag für eine sichere, wehrhafte und selbstbestimmte Gesellschaft leisten. Ich bin mir sicher, dass wir dem gemeinsam in einem großen Netzwerk, dem Ökosystem der Digitalen Souveränität, einen Schritt näherkommen.
Ich freue mich darauf, daran mitzuwirken!
Wir wünschen uns allen viel Erfolg bei der Umsetzung von Open-Source-first und freuen uns auf die konkrete Zusammenarbeit!
Soweit im gesetzlichen Rahmen möglich verzichtet der Autor auf alle Urheber- und damit verwandten Rechte an diesem Werk.
Es kann beliebig genutzt, kopiert, verändert und veröffentlicht werden.
Für weitere Informationen zur Lizenz, siehe hier.
In den vergangengenen Wochen habe ich die erste »echte« Ubuntu-Server-Installation durchgeführt. Abgesehen von aktuelleren Versionsnummern (siehe auch meinen Artikel zu Ubuntu 24.04) sind mir nicht allzu viele Unterschiede im Vergleich zu Ubuntu Server 22.04 aufgefallen. Bis jetzt läuft alles stabil und unkompliziert. Erfreulich für den Server-Einsatz ist die Verlängerung des LTS-Supports auf 12 Jahre (erfordert aber Ubuntu Pro); eine derart lange Laufzeit wird aber wohl nur in Ausnahmefällen sinnvoll sein.
Update 1 am 25.6.2024: Es gibt immer noch keinen finalen Fix für fail2ban, aber immerhin einen guter Workaround (Installation des proposed-Fix).
Update 2 am 29.6.2024: Es gibt jetzt einen regulären Fix.
fail2ban-Ärger
Recht befremdlich ist, dass fail2ban sechs Wochen nach dem Release immer noch nicht funktioniert. Der Fehler ist bekannt und wird verursacht, weil das Python-Modul asynchat mit Python 3.12 nicht mehr ausgeliefert wird. Für die Testversion von Ubuntu 24.10 gibt es auch schon einen Fix, aber Ubuntu 24.04-Anwender stehen diesbezüglich im Regen.
Persönlich betrachte ich fail2ban als essentiell zur Absicherung des SSH-Servers, sofern dort Login per Passwort erlaubt ist.
Update 1:
Mittlerweile gibt es einen proposed-Fix, der wie folgt installiert werden kann (Quelle: [Launchpad](https://bugs.launchpad.net/ubuntu/+source/fail2ban/+bug/2055114)):
* In `/etc/apt/sources.list.d/ubuntu.sources` einen Eintrag für `noble-proposed` hinzufügen, z.B. so:
„`
# zusätzliche Zeilen in `/etc/apt/sources.list.d/ubuntu.sources
Types: deb
URIs: http://archive.ubuntu.com/ubuntu/
Suites: noble-proposed
Components: main universe restricted multiverse
Signed-By: /usr/share/keyrings/ubuntu-archive-keyring.gpg
„`
Beachten Sie, dass sich Ort und Syntax für die Angabe der Paketquellen geändert haben.
* `apt update`
* `apt-get install -t noble-proposed fail2ban`
* in `/etc/apt/sources.list.d/ubuntu.sources` den Eintrag für `noble-proposed` wieder entfernen (damit es nicht weitere Updates aus dieser Quelle gibt)
* `apt update`
Update 2: Der Fix ist endlich offiziell freigegeben. apt update und apt full-upgrade, fertig.
/tmp mit tmpfs im RAM
Das Verzeichnis /tmp wird unter Ubuntu nach wie vor physikalisch auf dem Datenträger gespeichert. Auf einem Server mit viel RAM kann es eine Option sein, /tmp mit dem Dateisystemtyp tmpfs im RAM abzubilden. Der Hauptvorteil besteht darin, dass I/O-Operationen in /tmp dann viel effizienter ausgeführt werden. Dagegen spricht, dass die exzessive Nutzung von /tmp zu Speicherproblemen führen kann.
Auf meinem Server mit 64 GiB RAM habe ich beschlossen, max. 4 GiB für /tmp zu reservieren. Die Konfiguration ist einfach, weil der Umstieg auf tmpfs im systemd bereits vorgesehen ist:
systemctl enable /usr/share/systemd/tmp.mount
Mit systemctl edit tmp.mount bearbeiten Sie die neue Setup-Datei /etc/systemd/system/tmp.mount.d/override.conf, die nur Änderungen im Vergleich zur schon vorhandenen Datei /etc/systemd/system/tmp.mount bzw. /usr/share/systemd/tmp.mount enthält.
# wer keinen vi mag, zuerst: export EDITOR=/usr/bin/nano
systemctl edit tmp.mount
Wer ein GitHub Account hat, kann sich sehr einfach über neue Releases (Veröffentlichungen) von Projekten per E-Mail informieren lassen. Es benutzen aber nicht alle Projekte das „Releases“ Feature, sondern setzen stattdessen auf Git Tags....
Ich hatte es geahnt, aber dann ging es doch schneller als gedacht. Mit der Entscheidung des Europäischen Gerichtshofes Ende April wurde in einem Fall in Frankreich die Speicherung von IP-Adressen seitens des ISPs auf Vorrat nicht nur für den Bereich schwerer Straftaten, sondern auch für Urheberrechtsverstöße für zulässig erachtet. Damit ist eine Diskussion wieder auf dem Tisch, die seit 20 Jahren regelmäßig aufflammt, aber bisher durch Urteile gegen die erlassenen Gesetze eingefangen wurde.
Mit diesem Thema haben wir uns vergangene Woche mit Professor Dr. Stephan G. Humer in der 48. Episode des Risikozone-Podcasts beschäftigt, den ich euch wärmstens empfehlen kann.
Die klassische VDS in Deutschland wird momentan nicht praktiziert, da sie nach einem älteren Urteil des EuGH, das konkret das deutsche Gesetz betraf, als rechtswidrig eingestuft wurde. Nichtsdestotrotz ist die Diskussion wieder eröffnet und alle Möglichkeiten für Vorhaben zur Wiedereinführung werden wieder eingebracht. Das Thema wird uns also weiterhin noch eine ganze Weile verfolgen.
Klar, im Urteil des EuGH wird als Bedingung gestellt, dass Maßnahmen getroffen werden müssen, damit die Privatsphäre der einzelnen Nutzer gewahrt bleibt, aber das ändert nichts daran, dass die Daten grundsätzlich erstmal erhoben werden. Die "Neuerung" in diesem Urteil zu der Thematik ist, dass IP-Adressen und Identitäten getrennt gespeichert werden müssen. Mir ist allerdings noch nicht einleuchtend, was im Urteil mit der "Verknüpfung nur unter Verwendung eines leistungsfähigen technischen Verfahrens [...], das die Wirksamkeit der strikten Trennung dieser Datenkategorien nicht in Frage stellt" gemeint ist. Sollen die Datenbanken mit einem anschließend zu verwerfenden Schlüssel verschlüsselt werden, der bei der Verknüpfung erst geknackt werden muss? Am Ende kann ein technisches Verfahren doch gar nicht feststellen, ob ein Gesuch den formellen juristischen Anforderungen genügt oder nicht.
Technisch reden wir hier im Übrigen von zwei Teilaspekten: einerseits die Speicherung, welche Stationen (mit welchen IP-Adressen) miteinander kommunizieren und andererseits, wer hinter welcher IP-Adresse steckt. Diese ganze letzte Thematik haben wir allerdings nur, weil die ISPs einerseits ungern Privatkunden feste IP-Adressen vergeben und andererseits mitunter gar nicht so viele IP(v4)-Adressen wie Kunden haben und dann zu Tricks wie CG-NAT greifen müssen. Hämisch könnte man jetzt fragen, warum in dem Zusammenhang die Politik noch nicht alle zu IPv6 verpflichtet hat. Auf der anderen Seite wird deutlich, wie sehr sich das Internet verändert hat, nachdem es ein Massenmedium wurde.
Früher wurden feste IP-Adressen genutzt und die Zuordnung größtenteils öffentlich hinterlegt. Die Teilnehmer des Internets kannten sich mehr oder weniger sowieso alle untereinander. Als das Internet mehr und mehr ein Massenmedium wurde, ging es allerdings nicht mehr um den wissenschaftlichen oder beruflichen Austausch, sondern auch vorrangiger um das private Leben, wodurch auf einmal Grundrechte tangiert wurden und das Thema der Anonymität im Netz aufkam.
Gespeichert werden die Zuordnungen wohl auch weiterhin noch, aber sichtbar sind sie nur noch für Behörden und ähnliche Organisationen. Spätestens mit dem breiten Ausrollen der DSGVO wurde z. B. der whois-Dienst der DENIC für die Öffentlichkeit geschlossen. Wer einen Webseitenbetreiber ermitteln möchte, der kein Impressum auf der Seite stehen hat, schaut seitdem in die Röhre.
Vorratsdatenspeicherung ist und bleibt somit ein netzpolitisches Thema und lässt sich somit nicht auf der rein technischen Ebene erklären. Von da aus kann man sich oft an den Kopf fassen, was da alles von der Technik erwartet wird. Solche Themen sind auch ein Abbild der Gesellschaftspolitik, was daran deutlich wird, dass im Wesentlichen Deutschland eines der wenigen kritischen Länder diesbezüglich ist.
Die Never-ending-Story geht jetzt also in die nächste Runde. Weitere Probleme, Risiken und Lösungsansätze könnt ihr gerne euch in unserem Podcast anhören und in den Kommentaren mitdiskutieren.
Die Linux-Kommandoreferenz ist erstmalig 1995 erschienen. Die Kommandoreferenz war damals aber nur ein 56 Seiten langes Kapitel in der ersten Auflage meines Linux-Buchs. Aufgrund von Platzproblemen musste ich das Kommandoreferenz-Kapitel 15 Jahre später aus dem Linux-Buch entfernen und in ein eigenes Buch auslagern. Die erste Auflage im Taschenbuchformat hatte noch schlanke 176 Seiten. In der gerade neu erschienen sechsten Auflage hat das Buch den dreifachen Umfang!
547 Seiten, Hard-Cover
ISBN: 978-3-367-10103-0
Preis: Euro 29,90 (in D inkl. MWSt.)
Vor 15 Jahren zweifelten der Verlag und ich, ob die Kommandoreferenz überhaupt ein sinnvolles Buch wäre. Natürlich lassen sich alle Kommandos im Internet recherchieren. Heute verrät auch ChatGPT die gerade relevanten Optionen von find oder grep.
Dessen ungeachtet geben die Verkaufszahlen eine klare Botschaft: Ja, es gibt ganz offensichtlich den Bedarf nach einer Linux-Kommandoreferenz, die das Wesentliche vom Unwesentlichen trennt, die anhand thematischer Übersichten einen Startpunkt in das riesige Universum der Linux-Kommandos bietet, die mit vielen Beispielen alltägliche »Linux-Praxis« vermittelt. Keines meiner Bücher öffne ich selbst so oft (natürlich als PDF-Datei), um irgendein Detail rasch nachzulesen!
Für die 6. Auflage habe ich das Buch einmal mehr komplett aktualisiert. Die folgenden Kommandos habe ich neu aufgenommen:
Außerdem habe ich die Beschreibung vieler Kommandos aktualisiert oder mit zusätzlichen Beispielen versehen, unter anderem bei acme.sh, chmod, convert, curl, dd, find, firewall-cmd, mail, nmcli, pip und tcpdump.
Vor über vier Jahren hatte ich mich schon einmal mit dieser Thematik im Artikel „TURN-Server für Nextcloud Talk“ auseinandergesetzt. Über die Jahre hinweg hat sich jedoch einiges geändert und ich konnte mein Wissen ausbauen. Aus diesem Grund möchte ich nun meine aktuellsten Erkenntnisse noch einmal zusammenhängend präsentieren.
Installation
Ein TURN-Server wird von Nextcloud Talk benötigt, um Videokonferenzen zu ermöglichen. Der TURN-Server bringt die Teilnehmer, welche sich in verschiedenen Netzwerken befinden, zusammen. Nur so ist eine reibungslose Verbindung unter den Teilnehmern in Nextcloud Talk möglich.
Wer bisher meinen Anleitungen zur Installation von Nextcloud auf dem Raspberry Pi gefolgt ist, kann nun die eigene Cloud für Videokonferenzen fit machen. Zu bedenken gilt aber, dass ein eigener TURN-Server nur bis maximal 6 Teilnehmer Sinn macht. Wer Konferenzen mit mehr Teilnehmern plant, muss zusätzlich einen Signaling-Server integrieren.
Nun zur Installation des TURN-Servers. Zuerst installiert man den Server mit
sudo apt install coturn
und kommentiert folgende Zeile, wie nachfolgend zu sehen in /etc/default/coturn aus.
sudo nano /etc/default/coturn
Dabei wird der Server im System aktiviert.
#
# Uncomment it if you want to have the turnserver running as
# an automatic system service daemon
#
TURNSERVER_ENABLED=1
Nun legt man die Konfigurationsdatei zum TURN-Server mit folgendem Inhalt an.
Hier werden u.a. der Port und das Passwort des Servers sowie die Domain der Cloud eingetragen. Natürlich muss hier noch der Port im Router freigegeben werden. Ein starkes Passwort wird nach belieben vergeben.
Hierbei kann das Terminal hilfreich sein. Der folgende Befehl generiert z.B. ein Passwort mit 24 Zeichen.
gpg --gen-random --armor 1 24
Jetzt wird der Server in den Verwaltungseinstellungen als STUN- und TURN-Server inkl. Listening-Port sowie Passwort eingetragen.
Nextcloud – Verwaltungseinstellungen – TalkEintrag der Domain für STUN- und TURN-Server (sowie Passwort)
Bei meinen ersten Versuchen auf dem Raspberry Pi fiel auf, dass der Service des TURN-Servers schneller startet als das gesamte System, was einen Betrieb unmöglich machte. Diese Problematik konnte ich wie im Artikel „coTurn zeitverzögert auf Raspberry Pi starten“ beschrieben, lösen. Leider überstand aber dieser Eingriff kein Systemupgrade. Durch einen sehr hilfreichen Kommentar von Matthias, kann ich nun eine bessere Lösung aufzeigen.
Es wird mit
sudo systemctl edit coturn.service
der Service des Servers editiert. Folgender Eintrag wird zwischen die Kommentare gesetzt:
### Editing /etc/systemd/system/coturn.service.d/override.conf
### Anything between here and the comment below will become the new contents of the file

[Service]
ExecStartPre=/bin/sleep 30

### Lines below this comment will be discarded

### /lib/systemd/system/coturn.service
Dies ermöglicht den TURN-Server (auch nach einem Upgrade) mit einer Verzögerung von 30 Sekunden zu starten.
Zum Schluss wird der Service neu gestartet.
sudo service coturn restart
Ein Check zeigt, ob der TURN-Server funktioniert. Hierzu klickt man auf das Symbol neben dem Papierkorb in der Rubrik TURN-Server der Nextcloud. Wenn alles perfekt läuft ist, wird im Screenshot, ein grünes Häkchen sichtbar.
Einmal wollte ich faul sein und gleichzeitig einem FOSS-Projekt etwas Gutes tun. Anstelle mich immer selbst um ein Update von LibreOffice zu kümmern, wollte ich es aus dem Apple App Store installieren, via selbigen an das Projekt spenden und die Downloadzahlen im Store um eine Wertigkeit erhöhen. Automatische Updates im Hintergrund sollten hier die Wahl ... Weiterlesen
Screen Sharing mit dem Raspberry Pi war schon immer ein fehleranfälliges Vergnügen. In der Vergangenheit hat die Raspberry Pi Foundation auf die proprietäre RealVNC-Software gesetzt. Zuletzt war RealVNC aber nicht Wayland-kompatibel. Die Alternative ist wayvnc, ein Wayland-kompatible VNC-Variante: Wie ich unter Remote Desktop und Raspberry Pi OS Bookworm schon berichtet habe, ist wayvnc aber nicht mit allen Remote-Clients kompatibel, insbesondere nicht mit Remotedesktopverbindung von Microsoft.
Anfang Mai 2024 hat die Raspberry Pi Foundation mit Raspberry Pi Connect eine eigene Lösung präsentiert. Ich habe das System ausprobiert. Um das Ergebnis gleich vorwegzunehmen: Bei meinen Tests hat alles bestens funktioniert, selbst dann, wenn auf beiden Seiten private Netzwerke mit Network Address Translation (NAT) im Spiel sind. Das Setup ist sehr einfach, als Client reicht ein Webbrowser. Geschwindigkeitswunder sind aber nicht zu erwarten, selbst im lokalen Netzwerk treten spürbare Verzögerungen auf.
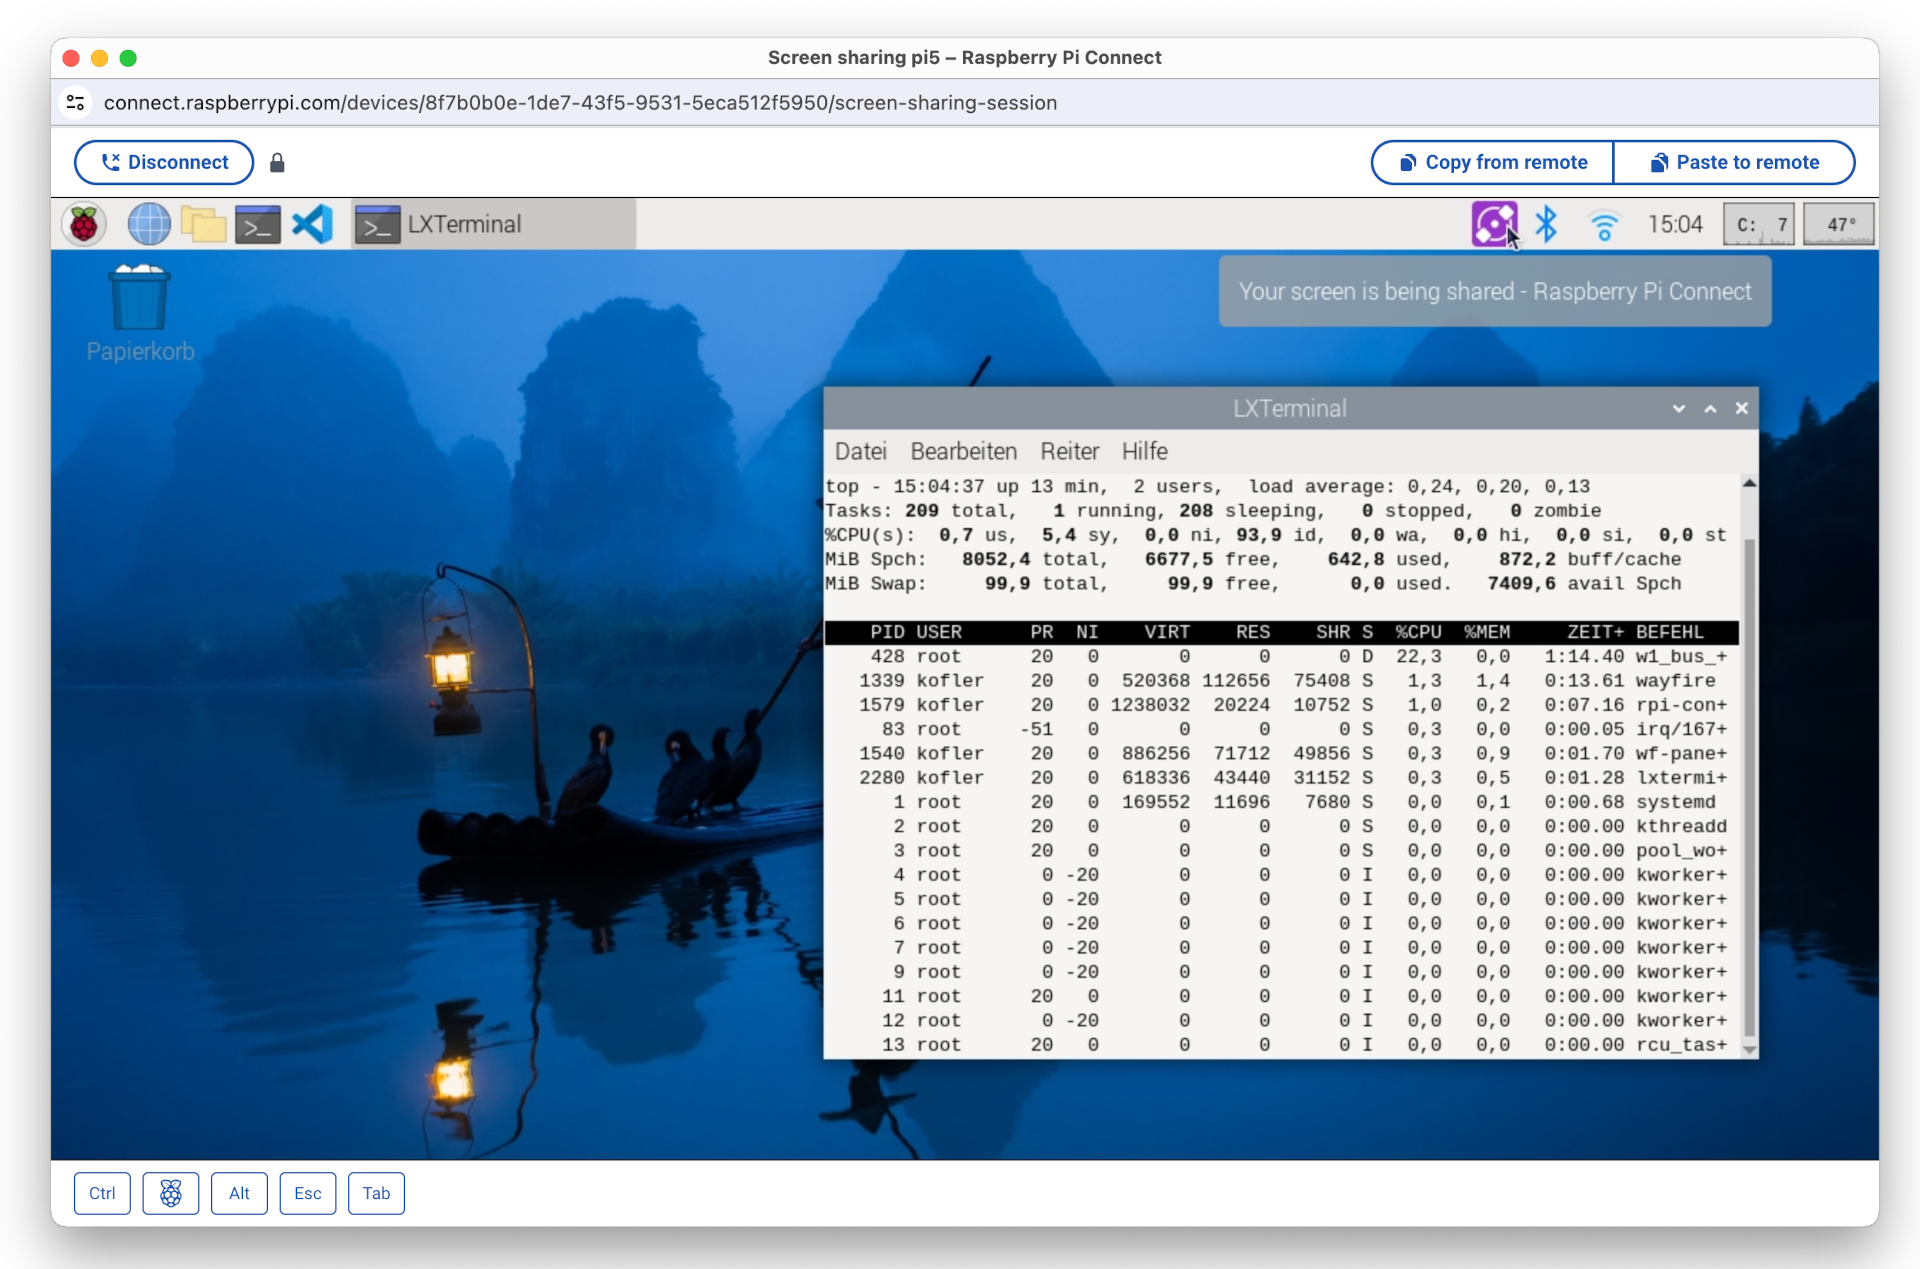
Der Zugriff auf den Raspberry-Pi-Client erfolgt hier in einem Fenster des Webbrowsers Google Chrome unter macOS
Voraussetzungen
Raspberry Pi Connect setzt voraus, dass Sie die aktuelle Raspberry-Pi-Version »Bookworm« verwenden und dass der PIXEL Desktop in einer Wayland-Session läuft. Das schränkt die Modellauswahl auf 4B, 400 und 5 ein. Ob Ihr Desktop Wayland nutzt, überprüfen Sie am einfachsten im Terminal:
echo $XDG_SESSION_TYPE

  wayland
Gegebenenfalls können Sie mit raspi-config zwischen Xorg und Wayland umschalten (Menüpunkt Advanced Options / Wayland).
Installation
Die Software-Installation verläuft denkbar einfach:
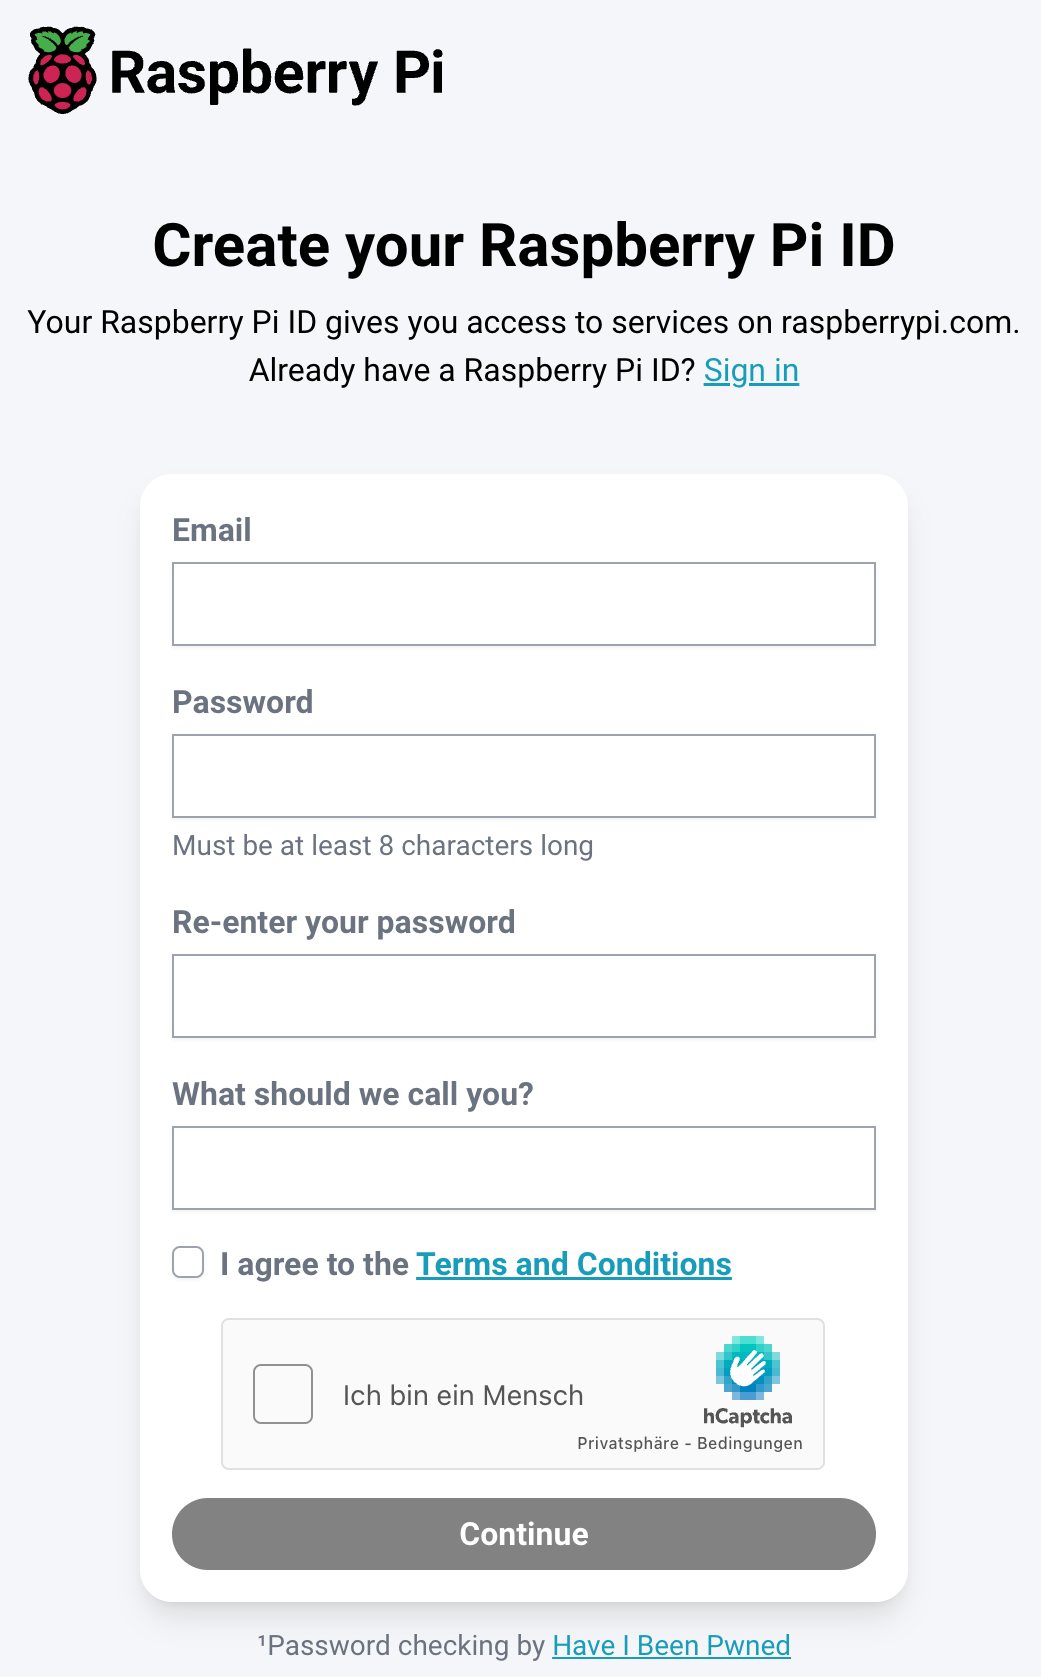
Nach der Installation erscheint ein neues Icon im Panel des PIXEL Desktops. Über dessen Menüeintrag Sign in gelangen Sie auf die Website https://connect.raspberrypi.com/sign-in. Dort müssen Sie eine Raspberry-Pi-ID einrichten. Die Eingabefelder sind auf ein Minimum beschränkt: E-Mail-Adresse, Passwort (2x) und Name. Fertig!
Bevor Sie Raspberry Pi Connect nutzen können, müssen Sie eine Raspberry Pi ID einrichten.
Fernzugriff
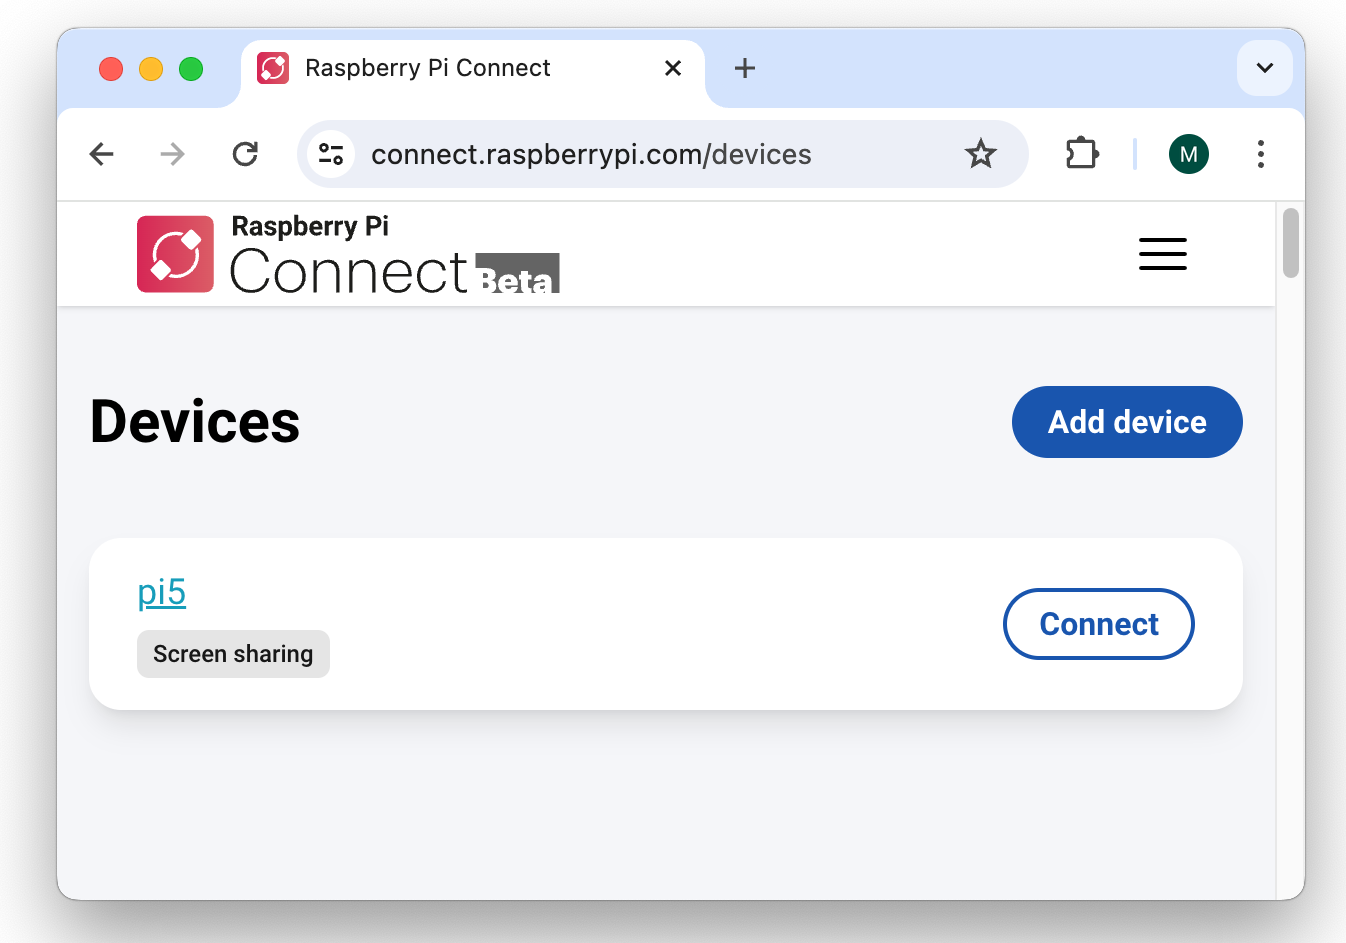
Um nun von einem anderen Rechner auf den PIXEL Desktop Ihres Raspberry Pis zuzugreifen, melden Sie sich dort ebenfalls auf der Website https://connect.raspberrypi.com/sign-in an. Dort werden alle registrierten Geräte aufgelistet. (Mit einer Raspberry-Pi-ID können als mehrere Raspberry Pis verknüpft werden.)
Remote-Verbindungsaufbau im Webbrowser
Praktische Erfahrungen
Bei meinen Tests hat Raspberry Pi Connect ausgezeichnet funktioniert. Der Verbindungsaufbau war problemlos. Der Desktop-Inhalt erscheint in einem neuen Browser-Fenster. Der Desktop-Inhalt wird automatisch auf die Fenstergröße skaliert. Die Bedienung ist denkbar simpel. Über zwei Buttons können Texte über die Zwischenablage kopiert bzw. eingefügt werden.
Raspberry Pi Connect testet beim Verbindungsaufbau, ob sich der Raspberry Pi und Ihr Client-Rechner (z.B. Ihr Notebook) im gleichen Netzwerk befinden. Wenn das der Fall ist, stellt der Client eine direkte Peer-to-Peer-Verbindung zum Raspberry Pi her. Nach dem Verbindungsaufbau fließen keine Daten mehr über den Raspberry-Pi-Connect-Server. Die Verbindungsgeschwindigkeit ist dann spürbar höher. Dennoch ist es empfehlenswert, die Bildschirmauflösung auf dem Raspberry Pi nicht höher einzustellen als notwendig.
Wenn sich Ihr Pi und Ihr Client-Rechner dagegen in unterschiedlichen (privaten) Netzwerken befinden, agiert ein Server der Raspberry Pi Foundation als Relay. Sowohl der Bildschirminhalt als auch alle Eingaben werden verschlüsselt nach Großbritannien und wieder zurück übertragen. Selbst wenn alle Geräte eine gute Internetverbindung haben, ist ein gewisser Lag unvermeidlich.
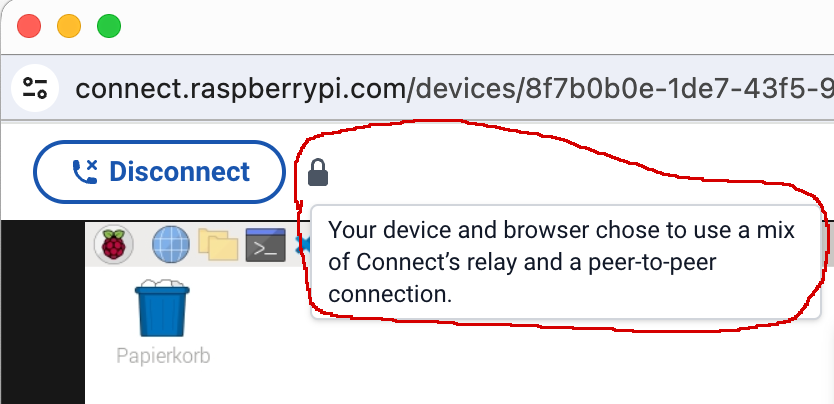
Details über die Art der Verbindung erfahren Sie, wenn Sie den Mauszeiger auf das Schloss-Icon im Screen-Sharing-Fenster bewegen.
Wenn Sie den Mauszeiger über das Schloss-Icon bewegen, erscheint ein Info-Text zum Status der Verbindung
Wenn die Remote-Desktop-Verbindung nicht im lokalen Netzwerk stattfindet, fließt der ganze Netzwerkverkehr über einen Relay-Server in Großbritannien. Dabei kommt das Protokoll Traversal Using Relays around NAT (kurz TURN) zum Einsatz. Die Daten werden TLS-verschlüsselt.
Der entscheidende Schwachpunkt des Systems besteht darin, dass es aktuell nur einen einzigen TURN-Server gibt. Je mehr gleichzeitige Remote-Desktop-Verbindungen aktiv sind, desto langsamer wird das Vergnügen … (Und besonders schnell ist es schon im Idealfall nicht.)
Fazit
Raspberry Pi Connect punktet vor allem durch seine Einfachheit.
Am Raspberry Pi reicht es aus, rpi-connect zu installieren.
Die Raspberry-Pi-ID kann rasch und unkompliziert eingerichtet werden.
Die Anwendung im Webbrowser funktioniert plattformübergreifend und einfach.
Allzu hohe Performance-Anforderungen sollten Sie nicht haben. Die Nachlaufzeiten bei Mausbewegungen und gar beim Verschieben eines Fensters sind beachtlich. Für administrative Arbeiten reicht die Geschwindigkeit aber absolut aus.
Schließlich bleibt abzuwarten, wie gut die Software skaliert. Aktuell befindet sich Raspberry Pi Connect noch in einem Probebetrieb. Soweit sich der Raspberry Pi und der Client-Rechner nicht im gleichen lokalen Netzwerk befinden, werden die Bildschirmdaten über einen Relay in Großbritannien geleitet. Aktuell gibt es genau einen derartigen Relay. Je mehr Anwender Raspberry Pi Connect gleichzeitig nutzen, desto langsamer wird es. Die Raspberry Pi Foundation lässt sich aktuell überhaupt offen, ob es den Relay-Betrieb dauerhaft kostenlos anbieten kann.

 Anmelden