Der Virutal Private Server (VPS), welcher diesen Blog ausliefert, war heute in der Zeit zwischen 08:06 Uhr und 17:52 Uhr nicht erreichbar.
Screenshot aus meiner Uptime-Kuma-Instanz
Ursache ist eine Störung im Nürnberger Rechenzentrum meines Anbieters Contabo. Die Störung besteht offenbar schon seit dem 30.08. (siehe Screenhot der Meldung unten), betraf meinen VPS aber erst heute.
Screenshot einer Contabo-Status-Meldung aus meinen RSS Feed Reader
Screenshot der Contabo-Störungs-Meldung zum Zeitpunkt 2024-09-02T20:11+02
Die Störung bei Contabo ist noch nicht behoben. Es ist nicht auszuschließen, dass dieser Blog nocheinmal davon betroffen sein wird. Ich bitte in diesem Fall um etwas Geduld.
Update 2024-09-16: Root Cause Analysis of September 2024 Nuremberg Data Center Outage
In diesem Beitrag erkläre ich kurz, was Ansible Lint ist und demonstriere dessen Anwendung am Beispiel meiner Ansible Collection tronde/nextcloud.
Er richtet sich primär an Personen, die mit Ansible Lint noch nicht vertraut sind. Linting-Profis werden vermutlich keine neuen Erkenntnisse gewinnen.
Was ist Ansible Lint und wofür ist es gut?
Lint (englisch für „Fussel“) ist eine Software zur statischen Code-Analyse. Davon abgeleitet hat sich das Verb linten (englisch to lint) für das Durchführen der statischen Code-Analyse etabliert.
Dem obigen Zitat und der Projektdokumentation folgend, ist Ansible Lint dementsprechend ein Werkzeug zur statischen Code-Analyse von Ansible Playbooks, Roles und Collections. Mit der Anwendung dieses Werkzeugs auf die eigenen Ansible-Inhalte kann sichergestellt werden, dass diese gängigen Konventionen und Standards entsprechen.
Ansible Lint liefert eine ganze Reihe von Profilen mit, welche Autoren unterstützen, die Code-Qualität schrittweise zu verbessern. Der Befehl ansible-lint --list-profiles gibt die verfügbaren Profile mit einer Beschreibung aus.
Ich werde im Folgenden mit dem Profil shared arbeiten, welches für Autoren gedacht ist, die ihre Collection auf https://galaxy.ansible.com veröffentlichen möchten.
Eine Collection linten
Bevor es zur Sache geht, wechsel ich in das Projektverzeichnis meiner Ansible Collection und erstelle einen neuen Branch, mit dem Befehl git checkout -b lint. Die in meinem Repo vorhandene Datei .ansible-lint-ignore lösche ich, da ich im folgenden alle Fehler und Regelverstöße sehen möchte. Zu Beginn stellt sich mein Arbeitsverzeichnis wie folgt dar:
(adt) nextcloud]$ git status
On branch lint
Changes not staged for commit:
  (use "git add/rm <file>..." to update what will be committed)
  (use "git restore <file>..." to discard changes in working directory)
	deleted:    .ansible-lint-ignore

no changes added to commit (use "git add" and/or "git commit -a")
Das Programm ansible-lint besitzt mit der Option --fix die Fähigkeit, Fehler automatisch zu korrigieren und auch YAML-Dateien neu zu formatieren. Der folgende Code-Block umfasst die gekürzte Ausgabe, wenn das Kommando ansible-lint --profile=shared --fix im Arbeitsverzeichnis ausgeführt wird.
(adt) nextcloud]$ ansible-lint --profile=shared --fix
WARNING  Listing 37 violation(s) that are fatal
galaxy[no-changelog]: No changelog found. Please add a changelog file. Refer to the galaxy.md file for more info.
galaxy.yml:1

var-naming[pattern]: Variables names should match ^[a-z_][a-z0-9_]*$ regex. (NC_HTML) (vars: NC_HTML)
roles/backup_restore_nextcloud/defaults/main.yml:4

…

risky-file-permissions: File permissions unset or incorrect.
roles/backup_restore_nextcloud/tasks/main.yml:18 Task/Handler: Copy backup files to container host

no-changed-when: Commands should not change things if nothing needs doing.
roles/backup_restore_nextcloud/tasks/main.yml:40 Task/Handler: Import tarball contents into an existing podman volume

no-changed-when: Commands should not change things if nothing needs doing.
roles/backup_restore_nextcloud/tasks/main.yml:54 Task/Handler: Export podman volumes to tarballs

var-naming[pattern]: Variables names should match ^[a-z_][a-z0-9_]*$ regex. (MYSQL_DATABASE) (vars: MYSQL_DATABASE)
roles/deploy_nextcloud_with_mariadb_pod/defaults/main.yml:13

…

Read documentation for instructions on how to ignore specific rule violations.

Modified 6 files.
                     Rule Violation Summary
 count tag                    profile rule associated tags
    33 var-naming[pattern]    basic   idiom
     1 risky-file-permissions safety  unpredictability
     1 galaxy[no-changelog]   shared  metadata
     2 no-changed-when        shared  command-shell, idempotency

Failed: 37 failure(s), 0 warning(s) on 25 files. Profile 'shared' was required, but 'min' profile passed.
Obige Ausgabe:
Benennt Funde mit Pfadangabe und Zeilennummer
Führt 37 Fehler auf, inkl. der Regeln, die nicht eingehalten werden; Beispiele
galaxy[no-changelog]: No changelog found. Please add a changelog file. Refer to the galaxy.md file for more info.
risky-file-permissions: File permissions unset or incorrect.
no-changed-when: Commands should not change things if nothing needs doing.
var-naming[pattern]: Variables names should match ^[a-z_][a-z0-9_]*$ regex.
Informiert, dass ansible-lint Änderungen an 6 Dateien vorgenommen hat
Mit git diff verschaffe ich mir einen Überblick, welche Änderungen ansible-lint vorgenommen hat. Dies sind in meinem Fall:
galaxy[no-changelog]: No changelog found. Please add a changelog file.
Unter Galaxy: Changelog Details finden sich Hinweise, wie dieser Fehler zu beheben ist. Ich erstelle die leere Datei CHANGELOG.md im Wurzelverzeichnis meiner Collection und der Fehler ist abgestellt.
Natürlich werde ich diese Datei zukünftig nutzen, um die wichtigsten Änderungen zu dokumentieren. ;-)
risky-file-permissions: File permissions unset or incorrect.
Auch hier habe ich kurz in der Dokumentation unter risky-file-permissions nachgesehen. Den Fehler habe ich abgestellt, indem ich den Parameter mode: 0600 zum Task hinzugefügt habe.
Dies war ein Flüchtigkeitsfehler, wie er häufig passieren kann, wenn man seinen Code nicht konsequent überprüft. Ohne den Dateimode explizit zu setzen, kann dies zu unvorhersehbaren bzw. überraschenden Verhalten führen.
no-changed-when: Commands should not change things if nothing needs doing.
An zwei Stellen bin ich leider nicht herumgekommen, das ansible.builtin.command Modul zu verwenden, da kein natives Modul für diese Aufgabe existiert. Betrachtet man sich die beiden Tasks fällt auf, dass diese jedes Mal Daten verarbeiten werden. Sie sind nicht idempotent. Im Ergebnis können sie erfolgreich sein oder fehlschlagen, aber sie werden immer Daten verarbeiten und dadurch ändern.
Um herauszufinden, wie ich ansible-lint zufriedenstellen kann, schaue ich wieder in der Doku unter no-changed-when nach. Nach der dortigen Beschreibung ist mein Fehler, dass ich den Rückgabewert des Kommandos nicht behandel. Daher registriere ich nun eine Variable je Task, die die Task-Ausgabe aufnimmt und prüfe den Rückgabewert. Ist der Rückgabewert gleich 0 wird der Task-Status auf changed gesetzt, ist der Rückgabewert ungleich 0 wird der Status entsprechend auf failed gesetzt. Das ganze sieht nun wie folgt aus:
Collection-intern verwendete Variablen leite ich mit zwei Unterstrichen (‚_‘) ein, um mir zu verdeutlichen, dass diese nicht durch den Nutzer gesetzt werden und daher auch nicht im README.md oder defaults/main.yml dokumentiert sind.
var-naming[pattern]: Variables names should match ^[a-z_][a-z0-9_]*$ regex.
Hier brauche ich nicht weiter nachzuschlagen. Ich verstoße gegen diese Regel, da ich meine Variablen-Namen großgeschrieben habe. Die Ausgabe von ansible-lint zeigt dies deutlich:
var-naming[pattern]: Variables names should match ^[a-z_][a-z0-9_]*$ regex. (NC_HTML) (vars: NC_HTML)
roles/backup_restore_nextcloud/defaults/main.yml:4
Diese Meldungen lassen sich mit folgendem Bash-Einzeiler abstellen:
$ for text in $(cut -d':' -f 1 roles/deploy_nextcloud_with_mariadb_pod/defaults/main.yml | grep -v '^$\|^#\|---'); do find roles -type f -iname "*.yml" | xargs sed -i -e "s/$text/\L&/g"; done
Aus verschiedenen Gründen hebe ich mir die Überarbeitung für später auf und nutze die Meldung, um zu demonstrieren, wie man ansible-lint dazu bringt, bestimmte Fehler zu ignorieren.
Um Regeln für ausgewählte Dateien zu ignorieren, spezifiziert man den jeweiligen Dateinamen und den Namen der Regel in der Datei .ansible-lint-ignore, welche im Wurzelverzeichnis der Collection erstellt wird:
Damit habe ich alle Probleme, die im ersten Durchlauf von ansible-lint gefunden wurden, adressiert. Ein zweiter Durchlauf zeigt das Ergebnis meiner Arbeit:
(adt) nextcloud]$ ansible-lint --profile=shared
WARNING  Listing 33 violation(s) marked as ignored, likely already known
var-naming[pattern]: Variables names should match ^[a-z_][a-z0-9_]*$ regex. (NC_HTML) (vars: NC_HTML) (warning) # ignored
roles/backup_restore_nextcloud/defaults/main.yml:4

…Ausgabe gekürzt

WARNING  Listing 1 violation(s) that are fatal
yaml[octal-values]: Forbidden implicit octal value "0600"
roles/backup_restore_nextcloud/tasks/main.yml:22

Read documentation for instructions on how to ignore specific rule violations.

                Rule Violation Summary
 count tag                profile rule associated tags
     1 yaml[octal-values] basic   formatting, yaml

Failed: 1 failure(s), 33 warning(s) on 27 files. Profile 'shared' was required, but 'min' profile passed.
Die ignorierten Regelverstöße werden als Warnung weiterhin ausgegeben, nehmen jedoch keinen Einfluss auf die abschließende Bewertung. Dafür habe ich einen neuen Fehler (yaml[octal-values]) eingebaut. Nach dem aktuellen Regelwerk erfordern oktale Werte ein explizites Quoting, um als Strings verarbeitet zu werden.
Nachdem ich das Problem mit mode: '0600' behoben habe, endet ein weiterer Lauf von ansible-lint schlussendlich mit:
Passed: 0 failure(s), 33 warning(s) on 27 files. Profile 'shared' was required, but 'production' profile passed.
Damit erfüllt meine Collection aktuell sogar die Anforderungen des nächst höheren Profils production; allerdings nur, weil ich einige Regeln bewusst ignoriere. Daher ist aktuell noch nicht sichergestellt, dass meine Collection tatsächlich bei einem Import auf Ansible Galaxy akzeptiert wird.
Zusammenfassung
Ansible Lint ist ein Werkzeug zur statischen Analyse von Ansible Playbooks, Roles und Collections
Das Werkzeug unterstützt Autoren dabei, gängige Konventionen und Standards einzuhalten und die Qualität des eigenen Codes auf einem Mindest-Niveau zu halten
Ansible Lint bietet mehrere Profile für verschiedene Anwendungsfälle
Regeln können bei Bedarf ignoriert werden, was zwar das Ergebnis des Linting beeinflusst, die Qualität jedoch nicht steigert
Linting sollte fester Bestandteil des eigenen Entwicklungsworkflows sein und stets nach Änderungen durchgeführt werden
Ich persönlich führe ansible-lint gern in einem eigenständigen Schritt aus. Es besteht jedoch auch die Möglichkeit, dies in den verwendeten Editor, die genutzte IDE oder Molecule zu integrieren und bei Änderungen automatisch laufen zu lassen.
Ich freue mich, wenn euch dieser Artikel gefallen hat.
Gnome unterstützt seit Version 46 Variable refresh rate (VRR). Ich habe mir kürzlich einen neuen Monitor gekauft, welcher VRR unterstützt. VRR ist standardmäßig nicht unter Gnome aktiviert und muss per Terminal zuerst aktivieren werden....
Interessanter Gegentrend: Während ich vor ziemlich genau einem Jahr über das zu der Zeit aktuellste Beispiel HashiCorp schrieb, wo eine Umstellung auf BSL-artige Lizenzen erfolgte, scheint es wohl auch einige Kandidaten zu geben, die wieder auf OSI-genehmigte Lizenzen umstellen. So verkündete Elastic am vergangenen Donnerstag, das sie wieder mit ihrer Suchmaschinensoftware Elasticsearch "Open Source" werden möchten, indem sie die AGPL als Lizenzoption aufnehmen.
Hintergrund
Hier einmal der Hintergrund bis jetzt, so wie es auf mich als externen Beobachter wirkte: Open Source hat es im Zeitalter der Cloud recht schwer, wenn man damit Geld verdienen möchte (um z. B. die Entwicklung zu finanzieren!). Das verbreitete Standardmodell zur Monetarisierung war bisher, eine Software Open Source anzubieten und den Support oder das Hosting kostenpflichtig anzubieten. Aus Kundensicht bestellt man dann direkt bei dem Hersteller, der seine Software auch am besten verstehen sollte.
Cloud Provider haben dem Modell das Wasser abgegraben, da sie einfach die Open Source Software nehmen und auf ihrer Plattform deployen konnten – ohne einen Cent dem Projekt zahlen zu müssen. Teilweise wurde die Software erweitert, ohne, die Änderungen wieder veröffentlichen zu müssen (deswegen sind auch die MIT- und BSD-Lizenzen so beliebt). Aus Kundensicht kauft man zwar nicht mehr bei dem Hersteller ein, hat aber
einerseits alles zentralisiert auf einer Cloudplattform und
andererseits gar keinen Bedarf für Herstellersupport, weil die Software sowieso über das SaaS-Modell supported wird und nicht mehr on-premise läuft.
Die Antwort vieler Projekte war es nun, die Lizenz so zu ändern, dass dieses Verhalten nicht mehr möglich ist, z. B. durch die Beschränkung von Konkurrenz-Hostingprodukten. Das verstößt allerdings gegen das Diskriminierungsverbot der OSI, nach dem die Verwendung von Produkten nicht durch die Lizenz beschränkt werden sollte (siehe auch das Good-Evil-Thema bei der JSON-Lizenz).
In der Konsequenz spalteten sich wie mit Open Search Elasticsearch-Forks ab, die weiterhin die offenen Lizenzen nutzen und durch Cloud Provider wie AWS direkt gepflegt wurden und werden. Wie Elasticsearch betont, sollen diese Projekte aber gleichzeitig auch einen eigenen Weg mit eigener Spezialisierung entwickelt haben. Die Community war natürlich aber auch verärgert, da die Software Elasticsearch nun nicht mehr als Free Open Source Software (FOSS) galt.
Wieder Open Source
Elasticsearch plant nun die Wogen zu glätten, indem die AGPL als weitere Lizenz zur ELv2 und SSPL zusätzlich aufgenommen wird. Die Nutzer können also frei entscheiden, welche Lizenz sie nutzen wollen, da insbesondere im Geschäftskontext die AGPL juristisch gesehen als heikel eingeschätzt wird, wenn man das Produkt aus verschiedenen Komponenten zusammengebaut und nicht den gesamten Quelltext veröffentlichen möchte. FOSS-Nutzer und Distributionen haben allerdings wieder die Möglichkeit, die Software wiederaufzunehmen. So entspricht z. B. die AGPL den Debian Free Software Guidelines.
Ende gut, alles gut? Wenn es nach der Ankündigung von Elastic geht, ist das Team zufrieden mit der Entscheidung, wieder Open Source zu sein. Ob der Fork OpenSearch aufrecht erhalten wird oder schlussendlich in das Urprodukt einfließt, ist allerdings noch nicht gewiss und muss sich in der Zukunft zeigen. Vielleicht sind die Communities auch schon zu sehr divergiert, sodass es nun unterschiedliche Lösungen für unterschiedliche Anwendungsfälle gibt.
#opensource #linux #linuxguides
In diesem Video zeigt Jean, wie man Syncthing installiert und einrichtet, um im lokalen Netzwerk Ordner von verschiedenen Rechnern zu synchronisieren.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
In diesem Video zeigt Jean, wie man seine NocoDB-Datenbank mit Python erweitern kann. Dadurch sind der Funktionalität keine Grenzen mehr gesetzt.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
Elektronomia - Sky High [NCS Release]
Music provided by NoCopyrightSounds.
Video Link: https://youtu.be/TW9d8vYrVFQ
Download Link: https://NCS.lnk.to/SkyHigh
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
Der TS101 lässt sich, wie auch der Pinecil v2, mit einem eigenen Bootlogo versehen. Beim TS101 muss das Logo der IronOS Firmwaredatei hinzugefügt werden # Arch Linux sudo pacman -S python-pillow python-intelhex git #...
In diesem Video erklärt Hannes, wie der Sound in Linux funktioniert und was eigentlich Pulseaudio, ALSA, Jack und Pipewire sind.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
E-Mail Adresse von Hannes: mail@hannes-brugger.com
0:00 Begrüßung
0:40 Linux Mint 22 mit Pipewire
1:50 Wie kommt der Ton von A nach B?
4:10 Mittelsmann: Sound-Server
7:30 Die Rolle von Pipewire
10:25 Welchen Sound-Server habe ich?
11:15 Verabschiedung
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
Heute Abend klären wieder Hauke und Jean Deine Fragen live!
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
--------------------
Links:
Frage stellen: https://ask.linuxguides.de
Forum: https://forum.linuxguides.de/
Micha bei Twitch: https://www.twitch.tv/saintofsinner
Haukes Webseite: https://goos-habermann.de/index.php
Nicht der Weisheit letzter Schluß: youtube.com/@nichtderweisheit
Linux Guides Admin: https://www.youtube.com/@LinuxGuidesAdmin
Professioneller Linux Support*: https://www.linuxguides.de/linux-support/
Linux Mint Kurs für Anwender*: https://www.linuxguides.de/kurs-linux-mint-fur-anwender/
Ubuntu Kurs für Anwender*: https://www.linuxguides.de/ubuntu-kurs-fuer-anwender/
Linux für Fortgeschrittene*: https://www.linuxguides.de/linux-kurs-fuer-fortgeschrittene/
Offizielle Webseite: https://www.linuxguides.de
Tux Tage: https://www.tux-tage.de/
Forum: https://forum.linuxguides.de/
Unterstützen: http://unterstuetzen.linuxguides.de
Twitter: https://twitter.com/LinuxGuides
Mastodon: https://mastodon.social/@LinuxGuides
Matrix: https://matrix.to/#/+linuxguides:matrix.org
Discord: https://www.linuxguides.de/discord/
Kontakt: https://www.linuxguides.de/kontakt/
BTC-Spende: 1Lg22tnM7j56cGEKB5AczR4V89sbSXqzwN
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
Ein neuer adminForge Service kann ab sofort genutzt werden. Ein alternatives Frontend zu Chefkoch mit dem Schwerpunkt auf Privatsphäre. GoCook Ein alternatives Frontend zu Chefkoch mit dem Schwerpunkt auf Privatsphäre. https://cook.adminforge.de Features: Schnell! Nur...
In diesem Video zeigt Jean, wie man in NocoDB verschiedene Ansichten mit Filtern einstellen kann und die Datenbanken mit anderen Personen teilen kann.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
Linux-Guides Merch*: https://linux-guides.myspreadshop.de/
Professioneller Linux Support*: https://www.linuxguides.de/linux-support/
Linux-Arbeitsplatz für KMU & Einzelpersonen*: https://www.linuxguides.de/linux-arbeitsplatz/
Linux Mint Kurs für Anwender*: https://www.linuxguides.de/kurs-linux-mint-fur-anwender/
Offizielle Webseite: https://www.linuxguides.de
Forum: https://forum.linuxguides.de/
Unterstützen: http://unterstuetzen.linuxguides.de
Mastodon: https://mastodon.social/@LinuxGuides
X: https://twitter.com/LinuxGuides
Instagram: https://www.instagram.com/linuxguides/
Kontakt: https://www.linuxguides.de/kontakt/
Inhaltsverzeichnis:
-------------------------------------
0:00 Einleitung
0:42 Filter
4:45 weitere Ansichten, Kalender, Galerie
8:26 Sortieren mit Rollup-Feldern (z.B. bezahlte Kunden)
14:40 Datenbanken und Zugriff teilen
17:23 Formulare
18:21 Ausblick
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
Dies ist ein Erfahrungsbericht zur Migration meiner Ansible-Rolle „Nextcloud im Container“ in eine Ansible Collection. Er umfasst die Migration der bestehenden Rolle und die Ergänzung der neuen Collection um eine weitere Rolle, welche sich um die Aufgaben Backup und Restore kümmert.
Wer es ganz eilig hat, kann direkt zur Zusammenfassung springen. Allen anderen wünsche ich viel Spaß bei der Lektüre.
Für grundlegende Informationen zu Ansible Collections siehe:
Randnotiz: Dass ihr zu meiner ersten Ansible Collection hier im Blog nicht fündig werdet, liegt darin begründet, dass meine Arbeit daran eingeschlafen ist.
Wie ihr in Teil 5 der Artikel-Serie nachlesen könnt, war ich mit der Lösung für Backup und Restore nicht ganz zufrieden. Ich möchte dieses Thema erneut angehen und mithilfe einer Ansible-Rolle lösen.
Backup und Restore beschreiben jedoch andere Anwendungsfälle als die Bereitstellung, weswegen ich den dafür notwendigen Quelltext nicht mit in die bestehende Rolle pressen möchte. Da Backup und Restore für mich jedoch zum Betrieb dazugehören, möchte ich alle Ansible-Rollen, die ich zum Betrieb meines Nextcloud-Setups benötige, in einer Collection zusammenfassen.
Migration der bestehenden Rolle in eine Collection
Ich orientiere mich hierzu an der englischsprachigen Dokumentation „Migrating a role to a collection“. Da ich bereits einen Galaxy Namespace besitze, nutze ich diesen auch für die Erstellung der Collection. Der folgende Codeblock zeigt die verwendeten Befehle.
]$ ansible-galaxy collection init tronde.nextcloud
- Collection tronde.nextcloud was created successfully

]$ mkdir tronde/nextcloud/roles/deploy_nextcloud_with_mariadb_pod && rsync -a ../roles/ansible_role_deploy_nextcloud_with_mariadb_pod/ tronde/nextcloud/roles/deploy_nextcloud_with_mariadb_pod/

]$ tree -L 3 tronde/nextcloud/
tronde/nextcloud/
├── docs
├── galaxy.yml
├── meta
│   └── runtime.yml
├── plugins
│   └── README.md
├── README.md
└── roles
    └── deploy_nextcloud_with_mariadb_pod
        ├── defaults
        ├── meta
        ├── README.md
        ├── tasks
        ├── tests
        └── vars

]$ rm -rf tronde/nextcloud/roles/deploy_nextcloud_with_mariadb_pod/.git
Im letzten Schritt entferne ich das .git-Verzeichnis, da ich die Collection als Ganzes in einem Repository verwalten möchte, statt alle Rollen einzeln zu versionieren und dann in die Collection einzufügen.
Anschließend aktualisiere ich die Dateien galaxy.yml und README.md. In der Rolle habe ich ein Playbook zum Testen verwendet, welches im Pfad deploy_nextcloud_with_mariadb_pod/tests/test.yml liegt. Um konform mit der Struktur einer Ansible Collection zu sein, erstelle ich im Wurzelverzeichnis meiner Collection das Verzeichnis playbooks und kopiere das Test-Playbook hier hinein:
]$ tree playbooks/
playbooks/
└── deploy_nextcloud_with_mariadb_pod.yml
An dieser Stelle halte ich zunächst inne und überlege mir, welche Tools ich noch benötige, um meine Collection entwickeln und testen zu können.
Ansible Development Tools
Ansible Development Tools (ADT) ist ein Projekt mit dem Ziel, einen Werkzeugkasten mit allen wichtigen Werkzeugen zur Entwicklung von Ansible Content zu bieten. Genau so etwas habe ich gesucht. Das probiere ich gleich aus.
Um mir mein System nicht zu verhunzen, installiere ich die ADT in ein Python Virtual Environment und lasse mir anzeigen, welche Werkzeuge ADT mitbringt:
Bei molecule-podman handelt es sich um einen Molecule-Treiber, welcher benötigt wird um Molecule-Tests in Podman-Containern ausführen zu können. Ich habe dieses Paket mitinstalliert, da ich mir vorstellen kann, dies in naher Zukunft zu nutzen.
ansible-lint
Ansible Lint ist das erste Werkzeug aus der ADT-Sammlung, welches ich verwende, um den Quelltext meiner Collection zu prüfen. Dazu wird das Kommando einfach im Wurzelverzeichnis der Collection ausgeführt. Anschließend können die gefundenen Fehler behoben werden.
Da es den Rahmen dieses Artikels sprengen würde, werde ich dem Thema einen eigenen Text widmen.
molecule
Ansible Molecule eignet sich zum Testen von Ansible-Rollen und Collections. Ich nutze meine Ansible Collection, um mich mit diesem Werkzeug vertraut zu machen.
Zwar gibt es auch hier erst eine Lernkurve, doch wird mir eine durchdachte Test-Konfiguration bei der weiteren Entwicklung sicher zugutekommen. Ich orientiere mich zu Beginn am Ansible Molecule Getting Started Guide.
Zu Beginn möchte ich meine in die Collection migrierte Rolle testen. Dazu bearbeite ich die Datei tronde/nextcloud/extensions/molecule/default/converge.yml. Sie enthält schließlich folgenden Inhalt:
Und mit folgendem Befehl teste ich, ob meine Nextcloud-Instanz erfolgreich deployt wird:
extensions]$ molecule converge
…
PLAY RECAP *********************************************************************
localhost                  : ok=10   changed=9    unreachable=0    failed=0    skipped=0    rescued=0    ignored=0

extensions]$ podman ps
CONTAINER ID  IMAGE                                    COMMAND               CREATED             STATUS             PORTS                    NAMES
48438d1bd884  quay.io/centos/centos:stream8            bash -c while tru...  7 minutes ago       Up 7 minutes                                instance
104c525a6b50  localhost/podman-pause:5.1.1-1717459200                        About a minute ago  Up About a minute  127.0.0.1:40671->80/tcp  e34ddf4d4203-infra
f27842b12d56  docker.io/library/mariadb:10.11.2        mariadbd              About a minute ago  Up About a minute  127.0.0.1:40671->80/tcp  nc_mariadb
9ee391a57fbd  docker.io/library/nextcloud:25-apache    apache2-foregroun...  13 seconds ago      Up 13 seconds      127.0.0.1:40671->80/tcp  nextcloud
Das Ergebnis ist positiv und kann durch Aufruf von http://127.0.0.1:40671 im Webbrowser überprüft werden. Ein Login mit den Default-Werten aus tronde/nextcloud/roles/deploy_nextcloud_with_mariadb_pod/defaults/main.yml bestätigt das erfolgreiche Deployment.
Es handelt sich hierbei noch nicht um ein adäquates Test-Setup; doch für den Moment ist es ausreichend. Ich werde mich noch weiter einarbeiten müssen, um das Test-Setup verbessern zu können. Vermutlich wird auch dazu dann ein weiterer Artikel folgen.
Falls sich jemand wundert, es ist durchaus Absicht, dass die Nextcloud nur via 127.0.0.1 und per HTTP erreichbar ist. Ich betreibe diese hinter einem Reverse-Proxy. Details können in Nextcloud im Container — Teil 3: Mit Reverse-Proxy nachgelesen werden.
Backup und Restore für die Nextcloud
Um die Konfiguration und die in der Nextcloud gespeicherten Daten sichern und wiederherstellen zu können, werde ich eine Offline-Sicherung der verwendeten Podman Volumes durchführen. Der Ablauf für die Sicherung sieht wie folgt aus:
Den Pod ˋnc_podˋ inkl. aller darin enthaltenen Container stoppen
Alle zum Setup gehörenden Podman Volumes in Tarballs exportieren
Diese Tarballs vom managed Node auf den Control Node sichern
Den ˋnc_podˋ wieder starten
Die Wiederherstellung läuft sinngemäß andersherum ab:
Die Tarballs werden vom Control Node auf den Managed Node kopiert
Der Pod ˋnc_podˋ inkl. aller darin enthaltenen Container wird gestoppt
Die Podman Volumes aus Schritt 1 werden importiert
Der nc_pod wird wieder gestartet
Die zur Wiederherstellung auf den Managed Node kopierten Tarballs werden wieder entfernt
Um diese neue Rolle der Collection hinzuzufügen, navigiere ich in das Rollenverzeichnis tronde/nextcloud/roles/ und erstelle dort das Grundgerüst für die Rolle: ansible-galaxy role init backup_nextcloud
Die Struktur sieht bei mir wie folgt aus, wobei nicht benötigte Verzeichnisse noch nicht entfernt wurden:
Das dortige README.md enthält wie bei dedizierten Rollen die Dokumentation zu dieser Rolle. Um doppelte Texte zu vermeiden, verweise ich im Collection-README auf die jeweiligen README-Dateien in den einzelnen Rollen.
Getestet wird diese Rolle ebenfalls mit Molecule. Zu den Tests mit Molecule werde ich noch mehr schreiben, sobald ich dies etwas verfeinert habe.
Fallen mir noch weitere Anwendungsfälle ein, können diese nun einfach als weitere Rollen der Collection hinzugefügt werden.
Ansible-Variablen definieren
Jede Rolle in dieser Collection ist für sich alleine nutzbar. Somit definiert jede Rolle die Eingangs-Variablen in der defaults/main.yml der jeweiligen Rolle.
Bei der Entwicklung achte ich darauf, dass Variablen, die z.B. den Namen eines Podman Volumes enthalten, in allen Rollen gleich geschrieben werden. Damit ist es möglich, diese Variablen an anderer Stelle zu definieren und in den verschiedenen Rollen nutzbar zu machen. So können an individuelle Deployments angepasste Variablen in Playbooks, group_vars, host_vars, etc. definiert werden.
Weitere Rollen können der Collection hinzugefügt werden, indem man sie im Verzeichnis roles der Collection-Verzeichnisstruktur wie gewohnt mit ansible-galaxy role init <Rollenname> erstellt und mit Leben füllt. Sorgfalt ist und bleibt bei der Benennung von Variablen und deren Präzedenz geboten, um nicht wahnsinnig zu werden. Dies ist nicht wirklich schwierig, doch muss ich fast jedes Mal in der Dokumentation nachschlagen, um sicher zu sein.
Die Ansible Development Tools (ADT) sind eine praktische Sammlung von Werkzeugen zur Entwicklung von Rollen und Collections für Ansible. Für mich sind aktuell Ansible Lint und Ansible Molecule die wichtigsten Werkzeuge aus dieser Sammlung. Wobei gerade die Dokumentation von Molecule auf dem Weg zu meinem Ziel, nämlich meine Collections in verschiedenen rootless Podman Containern mit nested Podman und Ansible zu testen, leider viele Fragen offen lässt. Grundsätzlich lassen sich Testpläne damit realisieren und vereinfachen mein bisheriges Testsetup bestehend aus diversen Skripts und virtuellen Maschinen. Und sie bieten Stoff für weitere Einträge in diesem Blog.
Die weitere Entwicklung meiner Nextcloud Collection findet auf Codeberg statt. Ihr findet sie dort unter der URL: https://codeberg.org/Tronde/nextcloud
In diesem Video zeigt Jean, wie man auf die neue Linux Mint Version 22 updated. Schritt für Schritt wirst Du durch den Upgrade-Prozess geführt, damit auch Dir alles ganz einfach gelingt.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
Links:
-------------------------------------
Linux Mint 22 Neuheiten https://www.youtube.com/watch?v=RqtMO5UHb6k
bei alten Linux Mint Versionen:
auf Linux Mint 21.3 upgraden https://www.youtube.com/watch?v=raeEPFHbcqs
von Linux Mint 20.3 auf 21 https://www.youtube.com/watch?v=jThB69TOBhA
Linux Mint Reparatur https://www.youtube.com/watch?v=nL0YIyl7zjs
Neuinstallation von Linux Mint https://www.youtube.com/watch?v=itcOTdTLInQ
Linux-Guides Merch*: https://linux-guides.myspreadshop.de/
Professioneller Linux Support*: https://www.linuxguides.de/linux-support/
Linux-Arbeitsplatz für KMU & Einzelpersonen*: https://www.linuxguides.de/linux-arbeitsplatz/
Linux Mint Kurs für Anwender*: https://www.linuxguides.de/kurs-linux-mint-fur-anwender/
Offizielle Webseite: https://www.linuxguides.de
Forum: https://forum.linuxguides.de/
Unterstützen: http://unterstuetzen.linuxguides.de
Mastodon: https://mastodon.social/@LinuxGuides
X: https://twitter.com/LinuxGuides
Instagram: https://www.instagram.com/linuxguides/
Kontakt: https://www.linuxguides.de/kontakt/
Inhaltsverzeichnis:
-------------------------------------
0:00 Wann soll ich updaten?
3:08 Spiegelserver einstellen
5:10 System auf den neuesten Stand bringen
5:57 Upgrade durchführen
14:19 abschließende Schritte
16:00 Supportangebot
Musik:
-------------------------------------
Elektronomia - Sky High [NCS Release]
Music provided by NoCopyrightSounds.
Video Link: https://youtu.be/TW9d8vYrVFQ
Download Link: https://NCS.lnk.to/SkyHigh
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
Drei C&C-Vereranen ist langweilig, deshalb stellen sie sich der OpenRA Combined Arms Herausforderung.
Combined Arms vereint das Beste aus allem C&C-Spielen und mischt die Karten komplett neu: Mehr Fraktionen, mehr Einheiten, mehr Spezialfähigkeiten und mehr Explosionen!
Und dabei bekommt man grafisch bei Combined Arms das beste was man aus Pixel herausholen kann und man sieht direkt die Leidenschaft der Entwickler, die sie in diese Mod gesteckt haben.
Combined Arms: https://www.moddb.com/mods/command-conquer-combined-arms
Micha bei Twitch: https://www.twitch.tv/saintofsinner
Haukes Webseite und Dienstleistungen: https://goos-habermann.de
Haukes Kanal: https://www.youtube.com/@nichtderweisheit
Professioneller Linux Support*: https://www.linuxguides.de/linux-support/
Linux-Arbeitsplatz für KMU & Einzelpersonen*: https://www.linuxguides.de/linux-arbeitsplatz/
Linux Mint Kurs für Anwender*: https://www.linuxguides.de/kurs-linux-mint-fur-anwender/
Offizielle Webseite: https://www.linuxguides.de
Tux Tage: https://www.tux-tage.de/
Forum: https://forum.linuxguides.de/
Unterstützen: http://unterstuetzen.linuxguides.de
Mastodon: https://mastodon.social/@LinuxGuides
Twitter: https://twitter.com/LinuxGuides
Instagram: https://www.instagram.com/linuxguides/
Matrix: https://matrix.to/#/#linuxguides:matrix.org/
Discord: https://www.linuxguides.de/discord/
Telegram: https://t.me/LinuxGuidesDECommunity
Kontakt: https://www.linuxguides.de/kontakt/
BTC-Spende: 1Lg22tnM7j56cGEKB5AczR4V89sbSXqzwN
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
In diesem Video stellt Jean das beispielhafte ERP-System fertig. Dabei wird gezeigt, wie fortlaufende Nummern erstellt werden können, man das aktuelle Jahr mithilfe eines Tricks und der SUBSTR-Funktion einfügen kann und ergänzt das Beispiel um den Einkauf und die Bestellungen.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
0:00 Begrüßung
0:59 Einkauf (Verknüpfung von Waren und Lieferanten)
5:49 Fortlaufende Nummer
12:28 Bestellungen (SUBSTR-Funktion)
26:15 Übersicht über die Relationen
27:42 Verabschiedung
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
In diesem Video zeige ich, welche Programme ich nutze um To-do-Listen zu erstellen, Notizen zu managen und meine Termine zu organisieren.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
Links:
-------------------------------------
Libre Workspace vorgestellt: https://www.youtube.com/watch?v=tzs9SdfeOMc
Android-Handy mit der Nextcloud verbinden: https://www.youtube.com/watch?v=liluZ6Nd0io
iPhone mit der Nextcloud verbinden: https://www.youtube.com/watch?v=-sLgP6P78L8
Mein Terminbuchungssystem: https://github.com/Jean28518/booking-system
Wissensmanagement mit Obsidian: https://www.youtube.com/watch?v=hC_5qJWzmMk
Linux-Guides Merch*: https://linux-guides.myspreadshop.de/
Professioneller Linux Support*: https://www.linuxguides.de/linux-support/
Linux-Arbeitsplatz für KMU & Einzelpersonen*: https://www.linuxguides.de/linux-arbeitsplatz/
Linux Mint Kurs für Anwender*: https://www.linuxguides.de/kurs-linux-mint-fur-anwender/
Offizielle Webseite: https://www.linuxguides.de
Forum: https://forum.linuxguides.de/
Unterstützen: http://unterstuetzen.linuxguides.de
Mastodon: https://mastodon.social/@LinuxGuides
X: https://twitter.com/LinuxGuides
Instagram: https://www.instagram.com/linuxguides/
Kontakt: https://www.linuxguides.de/kontakt/
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
Das Betreiben der Dienste, Webseite und Server machen wir gerne, kostet aber leider auch Geld.
Unterstütze unsere Arbeit mit einer Spende und diskutiere in unserem Chat mit.
Die meisten Linux-Distributionen bringen heute eine grafische Desktopoberfläche mit, die kaum Wünsche offen lässt. Aber mit ein bisschen Übung geht Manches schneller, wenn man es nicht über Mausklicks erledigt, sondern über Tastaturbefehle. Gerade in Kombination mit einer grafischen Oberfläche ist ein Kommandozeilenfenster - auch Shell genannt - ein starkes Werkzeug, das ganz nach persönlichem Geschmack eingesetzt werden kann.
Hauke und Claus teilen mit euch, wie sie die Shell benutzen und was ihre Lieblingsabkürzungen sind,
um Zeit zu sparen oder sich schlicht nerdig-cool zu fühlen.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
--------------------
Links:
Forum: https://forum.linuxguides.de/
Haukes Webseite: https://goos-habermann.de/index.php
Nicht der Weisheit letzter Schluß: youtube.com/@nichtderweisheit
Linux Guides Admin: https://www.youtube.com/@LinuxGuidesAdmin
Professioneller Linux Support*: https://www.linuxguides.de/linux-support/
Linux Mint Kurs für Anwender*: https://www.linuxguides.de/kurs-linux-mint-fur-anwender/
Ubuntu Kurs für Anwender*: https://www.linuxguides.de/ubuntu-kurs-fuer-anwender/
Linux für Fortgeschrittene*: https://www.linuxguides.de/linux-kurs-fuer-fortgeschrittene/
Offizielle Webseite: https://www.linuxguides.de
Tux Tage: https://www.tux-tage.de/
Forum: https://forum.linuxguides.de/
Unterstützen: http://unterstuetzen.linuxguides.de
Twitter: https://twitter.com/LinuxGuides
Mastodon: https://mastodon.social/@LinuxGuides
Matrix: https://matrix.to/#/+linuxguides:matrix.org
Discord: https://www.linuxguides.de/discord/
Kontakt: https://www.linuxguides.de/kontakt/
BTC-Spende: 1Lg22tnM7j56cGEKB5AczR4V89sbSXqzwN
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
In diesem Video zeigt Jean, wie man ein beispielhaftes ERP-System in NocoDB erstellt. Am Beispiel von Warenein- und Ausgangstabellen wird demonstriert, wie Tabellen miteinander verknüpft werden können und man eine etwas komplizierte Formel umsetzen kann. Es werden zudem Rollup-Felder und if-Abfragen behandelt.
Wenn Du das Video unterstützen willst, dann gib bitte eine Bewertung ab, und schreibe einen Kommentar. Vielen Dank!
Terminal Befehle:
-------------------------------------
NocoDB updaten (im gleichen Ordner wie docker-compose.yml ausführen)
sudo docker-compose pull
sudo docker-compose up -d
Linux-Guides Merch*: https://linux-guides.myspreadshop.de/
Professioneller Linux Support*: https://www.linuxguides.de/linux-support/
Linux-Arbeitsplatz für KMU & Einzelpersonen*: https://www.linuxguides.de/linux-arbeitsplatz/
Linux Mint Kurs für Anwender*: https://www.linuxguides.de/kurs-linux-mint-fur-anwender/
Offizielle Webseite: https://www.linuxguides.de
Forum: https://forum.linuxguides.de/
Unterstützen: http://unterstuetzen.linuxguides.de
Mastodon: https://mastodon.social/@LinuxGuides
X: https://twitter.com/LinuxGuides
Instagram: https://www.instagram.com/linuxguides/
Kontakt: https://www.linuxguides.de/kontakt/
Inhaltsverzeichnis:
-------------------------------------
0:00 Begrüßung
0:25 Aktualisieren
1:39 Tabelle für Waren (Felder, QR-Code)
6:47 Wareneingang (Tabellen verknüpfen)
15:04 Wareneintrag erstellen
16:48 Übersicht erstellen (Rollup-Feld)
18:55 Warenausgang
21:56 Gesamtbestand (Addition und if-Abfrage)
2/:00 Zusammenfassung und Hinweis zu Features
29:29 Verabschiedung
Haftungsausschluss:
-------------------------------------
Das Video dient lediglich zu Informationszwecken. Wir übernehmen keinerlei Haftung für in diesem Video gezeigte und / oder erklärte Handlungen. Es entsteht in keinem Moment Anspruch auf Schadensersatz oder ähnliches.
Heute möchte ich euch wissen lassen, welche Kombination es geworden ist.
Die Hardware
Ich habe mich für ein wiederaufbereitetes Lenovo T570 entschieden, welches für günstige 240 Euro im Onlinehandel verfügbar war. Da war dann auch noch für 30 Euro ein Schutzbrief drin, der Flüssigkeiten und Stürze abdeckt.
Mit dem Intel Core-i5 der 6. Generation, 8 GB RAM und einer 256 GB SSD bietet dieses Gerät mehr als ausreichend Leistung.
Das Gerät weist einige Gebrauchsspuren auf. Den Preis empfinde ich dennoch günstig, da Geräte dieser Klasse nicht unter 1.000 Euro Neupreis zu bekommen sind. Viel wichtiger jedoch ist, dass der Nutzer sich ebenfalls über das Gerät freut.
Linux-Distribution und Desktopumgebung
Wer die Wahl hat, hat die Qual. Um mir einen ersten Eindruck zu verschaffen, habe ich mir einen USB-Stick mit Ventoy und einer Auswahl an verschiedenen Linux-Distributionen erstellt. So konnte ich die verschiedenen Live-Systeme booten und prüfen, ob alles funktioniert und wie es sich in der Oberfläche navigieren lässt.
Schlussendlich habe ich mich für Debian Cinnamon entschieden. Dies machte nach dem ersten kurzen Test insgesamt den besten Eindruck. Firefox, Thunderbird, Bookmarks, Desktop-Verknüpfungen und Zoom-Client waren schnell eingerichtet und das Gerät bereit zur Übergabe.
Die Übergabe ist erfolgt
Mit der Übergabe gab es eine kurze Einweisung in das Gerät:
Wo schließt man das Netzteil an
Wo schaltet man das Gerät ein
Wie meldet man sich an
Wo findet man die Programme inkl. Tests aller wichtigen Dienste
Druck eines Anhangs aus Thunderbird
Wie fährt man das Gerät herunter
So reibungslos hat das bisher noch nie geklappt. Die Nutzungserfahrung ist positiv. Wir freuen uns.
Ende 2021 bin ich von einem Raspberry Pi 4 mit 4 GB auf einen Intel NUC7PJYH mit Proxmox VE umgestiegen. Hauptgrund damals war, dass bei mir das Upgrade von Raspberry Pi OS 10 auf...
Bei der Arbeit für unser KI-Buch bin ich kürzlich über Aider gestolpert. Dabei handelt es sich um ein Konsolenwerkzeug zum Coding. Im Gegensatz zu anderen Tools (ChatGPT, GitHub Copilot etc.), die Sie beim Coding nur unterstützen, ist Aider viel selbstständiger: Sie sagen, was Ihr Programm machen soll. Aider erzeugt die notwendigen Dateien, implementiert die Funktion und macht gleich einen git-Commit. Sie testen den Code, optimieren vielleicht ein paar Details, dann geben Sie Aider weitere Aufträge. Den Großteil der Coding-Aufgaben übernimmt Aider. Sie sind im Prinzip nur noch für das Ausprobieren und Debugging zuständig.
Wie Sie gleich sehen werden, funktioniert das durchaus (noch) nicht perfekt. Aber das Konzept ist überzeugend, und es ist verblüffend, wie viel schon klappt. Aider kann auch auf ein bestehendes Projekt angewendet werden, das ist aber nicht Thema dieses Blog-Beitrags. Generell geht es mir hier nur darum, das Konzept vorzustellen. Viel mehr Details können Sie in der guten Dokumentation nachlesen. Es gibt auch diverse YouTube-Videos. Besonders überzeugend fand ich Claude 3.5 and Aider: Use AI Assistants to Build AI Apps.
Voraussetzungen
Damit Sie Aider ausprobieren können, brauchen Sie einen Rechner mit einer aktuellen Python-Installation, git sowie einen (kostenpflichtigen!) Key für ein KI-Sprachmodell. Ich habe meine Tests mit GPT-4o von OpenAI sowie mit Claude 3.5 Sonnet (Anthrophic) durchgeführt. Ein wenig überraschend hat Claude 3.5 Sonnet merklich besser funktioniert.
Damit Sie einen API-Key bekommen, müssen Sie bei OpenAI oder Anthrophic einen Account anlegen und Ihre Kontakt- und Kreditkartendaten hinterlegen. Sie kaufen dort vorab »Credits«, die dann durch API-Abfragen aufgebraucht werden. Für erste Tests reichen 10 EUR aus. Sie müssen also kein Vermögen investieren, um Aider auszuprobieren.
Installation von aider
aider ist ein Python-Programm. Die Installation führen Sie am besten in einem Virtual Environment aus, im Prinzip so:
Falls beide Variablen definiert sind, nutzt Aider das Modell Sonnet von Anthrophic. Mit den Optionen --4o oder --sonnet können Sie das Sprachmodell explizit auswählen. Aider unterstützt auch andere Sprachmodelle, empfiehlt aber explizit diese beiden Modell sowie DeepSeek Coder (siehe auch https://aider.chat/docs/leaderboards/).
»Hello World« mit GPT-4o von OpenAI
Um Aider kennenzulernen habe ich mir gedacht, ich beauftrage das Tool, ein ganz simples Webscraping-Tool in Python zu programmieren, das aus einer Wetterseite von orf.at die aktuelle Temperatur in Graz extrahiert. (Warnung: Das Script hat reinen Demonstrations-Charakter. Das regelmäßige Auslesen von Wetterseiten und die Nutzung der so gewonnen Daten — wofür auch immer — ist bei nahezu allen Websites verboten.)
Für den Test habe ich ein neues Verzeichnis eingerichtet, dieses aktiviert und (immer noch im Virtual-Environment) aider gestartet.
mkdir ~/my-projects/test1
cd ~/my-projects/test1
aider --4o
  No git repo found, create one to track GPT's changes (recommended)? y
  Models: gpt-4o with diff edit format, weak model gpt-4o-mini
  Git repo: .git with 0 files
  Repo-map: using 1024 tokens
  Use /help <question> for help, run "aider --help" to see cmd line args
Die weitere Bedienung erfolgt durch Konsolenkommandos. Ich habe damit begonnen, mit /web die Wetterseite zu laden. Beim ersten /web-Kommando installiert Aider nach einer Rückfrage das Webscraping-Tool Playwright. Mit der folgenden Frage habe ich überprüft, dass Aider den Inhalt der gelesenen Seite versteht.
> /web https://wetter.orf.at/steiermark

I see that you've shared a webpage content. How can I assist you with this? Are
you looking to extract specific information, transform the data, or something
else? Please provide more details about what you need.

Tokens: 7,057 sent, 43 received. Cost: $0.04 request, $0.04 session.

> what is the temperature in Graz?

The temperature in Graz, according to the provided content, is 27.2°C.
Nach diesem einleitenden Test habe ich nun versucht, eine App zu entwickeln, die diese Aufgabe übernimmt. Aider erzeugt eine neue Datei und speichert die Datei dort. Von der Programmiersprache war nie die Rede, Aider hat sich für Python entschieden. In einem zweiten Prompt habe ich Aider darum gebeten, das Projekt mit einer requirement-Datei auszustatten.
> write a Python script which extracts the temperature of Graz
  from https://wetter.orf.at/steiermark/

Add https://wetter.orf.at/steiermark/ to the chat? y

Let's create a Python script that extracts the temperature of Graz from the
given URL. We'll use the requests library to fetch the webpage content and
BeautifulSoup from the bs4 library to parse the HTML.

Here is the script:

    import requests
    from bs4 import BeautifulSoup

    def get_graz_temperature():
        url = "https://wetter.orf.at/steiermark/"
        response = requests.get(url)
        response.raise_for_status()  # Ensure we notice bad responses

        soup = BeautifulSoup(response.text, 'html.parser')
        graz_section = soup.find('a', href="https://wetter.ORF.at/steiermark/grazuniversitaet/")

        if graz_section:
            temperature_text = graz_section.find_next_sibling(text=True)
            if temperature_text:
                temperature = temperature_text.strip().split(' ')[0]
                return temperature
        return None

    if __name__ == "__main__":
        temperature = get_graz_temperature()
        if temperature:
            print(f"The temperature in Graz is {temperature}°C.")
        else:
            print("Could not find the temperature for Graz.")

This script will:

 1 Fetch the webpage content from the given URL.
 2 Parse the HTML content to find the section related to Graz.
 3 Extract and print the temperature for Graz.

You can run this script in your Python environment to get the current
temperature in Graz.

Tokens: 7,196 sent, 314 received. Cost: $0.04 request, $0.11 session.

Allow creation of new file new_file_path: extract_graz_temperature.py? y

Applied edit to new_file_path: extract_graz_temperature.py
Commit beb001f feat: add script to extract temperature of Graz from weather website
You can use /undo to revert and discard commit beb001f.

> add a requirement file to the project

To add a requirements file to the project, we need to create a new file named
requirements.txt and list the necessary dependencies.

requests
beautifulsoup4

Tokens: 2,372 sent, 66 received. Cost: $0.01 request, $0.13 session.
In einem zweiten Terminal-Fenster oder -Tab habe ich nun ein weiteres Virtual Environment eingerichtet, um alle erforderlichen Module zu installieren und das neue Script zu testen.
Dabei habe ich auch schon den ersten Fehler entdeckt. Aider hat das neue Python-Script nicht extract_graz_temperature.py genannt, sondern new_file_path: extract_graz_temperature.py. Diesen Fehler habe ich mit git behoben.
python3 extract_graz_temperature.py

  extract_graz_temperature.py:13: DeprecationWarning: The
  'text' argument to find()-type methods is deprecated.
  Use 'string' instead.

  Could not find the temperature for Graz.
Der Code enthält offensichtlich einen veralteten Parameter. Zurück im ersten Terminal/Tab bitte ich Aider, das Problem zu beheben. Aider sieht den Fehler ein und korrigiert den Code.
> tried to run the code, got this error:
  extract_graz_temperature.py:13: DeprecationWarning: The 'text'
  argument to find()-type methods is deprecated. Use 'string'
  instead. Can you fix the code? I renamed the code file to
  extract_graz_temperature.py.

extract_graz_temperature.py
Add these files to the chat? y

 <<<<<<< SEARCH
         temperature_text = graz_section.find_next_sibling(text=True)
 =======
         temperature_text = graz_section.find_next_sibling(string=True)
 >>>>>>> REPLACE

...

Tokens: 2,585 sent, 86 received. Cost: $0.01 request, $0.14 session.
Aber auch nach diesem Fix funktioniert das Script nicht. Das Problem ist, dass das Script die Struktur der Wetter-Website nicht korrekt analysiert hat und Beautiful Soup (eine HTML-Parser-Bibliothek für Python) falsch anwendet. Etwas enttäuscht habe ich an dieser Stelle den ersten Versuch abgebrochen. Die bis dahin angefallenen Kosten von 14 US Cent sind immerhin verschmerzbar.
»Hello World« mit Sonnet 3.5 von Anthrophic
Anstatt mich mit der Fehlersuche zu ärgern, habe ich das ganze Experiment mit dem Sprachmodell Sonnet wiederholt. Die folgenden Ausgaben sind stark gekürzt.
mkdir ~/my-projects/test2
cd ~/my-projects/test2
aider --sonnet

> /web https://wetter.orf.at/steiermark

> what is the temperature in Graz?

Based on the information provided in the weather report for Steiermark, there
are multiple temperature readings for Graz:

 1 Graz Heinrichstrasse: 30.3°C
 2 Graz-Straßgang: 29.8°C
 3 Graz-Thalerhof: 29.2°C
 4 Graz-Universität: 30.3°C

The temperatures in Graz range from 29.2°C to 30.3°C, with most locations
reporting around 30°C. The warmest spots in Graz appear to be Heinrichstrasse
and the University area, both at 30.3°C.

Tokens: 7,323 sent, 129 received. Cost: $0.02 request, $0.05 session.

> write a Python script which extracts the temperature of Graz
  from https://wetter.orf.at/steiermark/

...

> add a requirement file to the project

...
In einem weiteren Terminal habe ich nun auch für dieses Projekt ein Python Environment eingerichtet und das Script ausprobiert:
(Virtual Environment einrichten, Requirements mit pip installieren ...)

python3 extract_graz_temperature.py

  Graz Heinrichstrasse: 30,3 °C
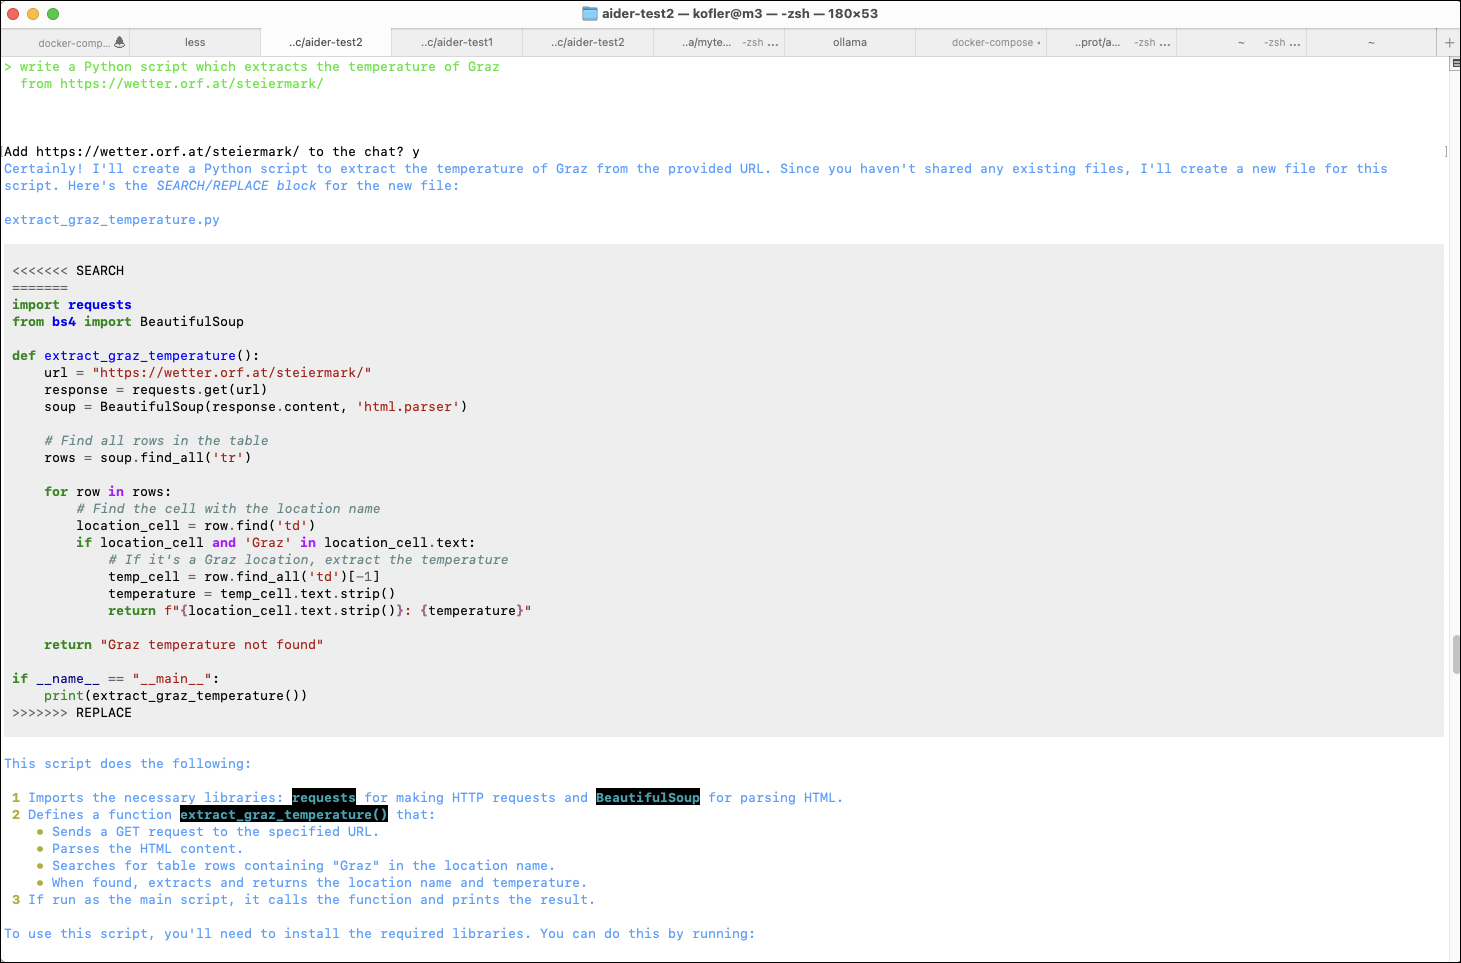
Aider in einem Terminal-Fenster
Bingo! Das Script wählt eine der vier Messstellen von Graz aus und zeigt die Temperatur dort an. Wunderbar.
Dementsprechend ermutigt habe ich mein Glück weiter strapaziert. Das Script soll die Durchschnittstemperatur aller vier Messstellen ausrechnen. Zurück in Terminal 1 mit Aider. Wie die folgenden Prompts zeigen, sind fünf Versuche notwendig, bis Aider endlich funktionierenden Code zusammenbringt. (Die ursprüngliche Fassung versucht aus Zeichenketten wie ‚30,3 C‘ in Fließkommazahlen umzuwandeln. Es ignoriert sowohl das deutsche Dezimalformat als auch die Zeichenkette ‚ C‘ am Ende. Die ganze Prozedur dauert inklusive meiner Tests eine Viertelstunde.
> please change extract_graz_temperature.py to calculate the average temperature for Graz

> does not work because of german number format (1,3 instead of 1.3); please fix

> still fails, probably because temperature string contains ' C' at the end; please fix once more

> still fails, the space in ' C' is a fixed space; try again

> it's the unicode fixed blank; just drop the last two characters

Tokens: 3,153 sent, 211 received. Cost: $0.01 request, $0.16 session.
Immerhin, das Script funktioniert jetzt:
python3 extract_graz_temperature.py

  Average temperature for Graz: 29.9°C
Die API-Kosten für die Entwicklung des Scripts betrugen 13 US Cents. Meine Arbeitszeit habe ich nicht gerechnet ;-)
Fazit
Im Internet finden Sie diverse Videos, wo Aider scheinbar auf Anhieb perfekt funktioniert. Meine Tests haben gezeigt, dass das durchaus nicht immer der Fall ist.
Was mich trotz aller Fehler begeistert, ist das Konzept: Am besten führen Sie Aider in einem VSCode-Terminal aus, während in VSCode das Projektverzeichnis geöffnet ist. (Das Ganze funktioniert natürlich auch mit jedem anderen Editor.) Dann haben Sie eine grandiose Umgebung zum Testen des Codes sowie für dessen Weiterentwickung mit Aider.
Ja, weder Aider noch die von Aider genutzten Sprachmodelle sind zum jetzigen Zeitpunkt perfekt. Aber das Potenzial, das hier schlummert, ist enorm. Sie sind damit quasi eine Abstraktionsebene über dem Code. Sie geben Aider Kommandos, wie es den Code weiterentwickeln oder verbessern soll, ohne sich im Detail mit Funktionen, Schleifen oder Variablen zu beschäftigen. (Dieses Wissen brauchen Sie zum Debugging aber weiterhin!)
Wer sagte noch gleich, dass klassische Release-Distributionen den Rolling Releases überlegen sind, weil sie so stabil seien? Dass es Ausnahmen von der Regel gibt, durfte ich heute erleben. Ich liebe diese Tage, wo auf einmal die normalsten Dinge nicht mehr gehen...
Es galt etwas in einem Softwareprojekt zu testen, das ich hierfür erstmal wieder in Gang bringen musste. Dabei setzt das Projekt auf Vagrant in Kombination mit VirtualBox. Ich habe dazu erstmal das Hostsystem aktualisiert und versucht, mit Vagrant die Maschine aufzusetzen – um dann feststellen zu dürfen, dass Vagrant einen Fehler wirft.
Was ging schief?
Konkret war VirtualBox in die Guru Meditation gefallen. Das tritt dann auf, wenn ein besonders schwerer Fehler auftritt, sodass das Programm nicht ordentlich weiterlaufen kann. Dabei war doch gar nicht viel am Entwicklungssystem verändert worden? Ich halte für solche Entwicklungsprojekte dedizierte Entwicklungsmaschinen vor, auf denen sich das Betriebssystem über die Jahre nicht verändert und die für die tägliche Arbeit auch entsprechend nicht eingesetzt werden. Was ich aber tue: die Zwischenupdates einspielen.
Stellt sich heraus, dass unter Ubuntu 22.04 LTS die Kernelversionen ab 5.15.0-112 den Fehler VERR_VMM_SET_JMP_ABORTED_RESUME wohl verursachen. Der Bug wird schon auf Launchpad, bei ubuntuusers.de und auch im VirtualBox-Forum diskutiert.
Wie kann man das fixen?
Man könnte einereits den Kernel downgraden bzw. einen alten Kernel nutzen, was aber nur kurzfristig Abhilfe schafft. Alternativ gibt es die Flucht nach vorne: entweder Ubuntu auf 24.04 LTS upgraden (habe ich nicht probiert, scheinbar ist der automatische Update-Pfad auch noch gar nicht freigeschaltet) oder VirtualBox auf Version 7.0 updaten. Ich habe mich für letzteren Schritt entschieden und dabei auf die offiziellen VirtualBox-Pakete von Oracle zurückgegriffen, da in den offiziellen Ubuntu-Repos für die Version nur Version 6.1 enthalten ist (was ja bei LTS-Versionen eigentlich auch sinnvoll ist). Das ist natürlich keine schöne Lösung, da man sich fremde Pakete in das System holt – aber sie funktioniert. Man muss allerdings auch bedenken, dass die aktuelle Vagrant-Version, die in den Ubuntu-Repos für 22.04 (jammy) enthalten ist, VirtualBox 7.0 noch gar nicht unterstützt. Folglich muss man dann auch auf die offiziellen Repositories von Hashicorp zurückgreifen – was allerdings angesichts der lizenzrechtlichen Änderungen sowieso bald nötig wird.
Was lernen wir daraus?
Software muss laufend auf Regressionsfehler getestet werden, die durch Updates an anderen Stellen passieren können. Ja, diese Fehler können immer passieren und sind teilweise schwer zu verhindern. Gleichzeitig muss man aber selber auch seine Setups regelmäßig testen, um schnell zu erkennen, dass ggfs. das Kernelupdate schuld war. Mittlerweile vermutet man das aufgrund der Stabilität der Systeme schon fast gar nicht mehr. Ansonsten geht viel Zeit aufgrund der Fehlersuche ins Land. Da ist es auch wenig zuträglich, dass die VirtualBox-Logs scheinbar keine Log Level beinhalten...
Ein Fix seitens Ubuntu steht für diesen Bug im Übrigen noch aus. Theoretisch sollte sich dann das Thema von selbst erledigen, weil die betreffende Änderung im Kernel einfach reverted wird. Ich wollte zwischenzeitlich aber die Workarounds einmal auflisten, sollte jemand ähnliche Probleme haben.
Vor einiger Zeit habe ich beschlossen eine Serie von Artikeln zum Thema Nextcloud auf dem RasPi auf meinem Blog intux.de zu veröffentlichen. Ziel ist es, eine eigene Cloud zu erstellen, die produktiv nutzbar ist. Diese soll später über das Internet erreichbar sein.
Was benötigt man dafür?
Um langfristig sicherzustellen, dass alles funktioniert, empfehle ich, die neueste Hardware zu verwenden, wie den Raspberry Pi 5. Allerdings würde hier auch ein Einplatinencomputer der vorherigen Generation mit 4GB RAM ausreichen.
Hier eine Auflistung der für das Projekt eingesetzten Komponenten:
Raspberry Pi 5
offizielles Gehäuse für den Raspberry PI 5
offizielles Netzteil für den Raspberry PI 5 (8GB RAM)
32GB MicroSD (SanDisk Extreme microSD UHS-I)
Vorbereitung
Diese kleine Anleitung soll helfen, das Projekt Nextcloud auf dem Raspberry Pi nicht nur umzusetzen, sondern auch besser zu verstehen. Der Schwerpunkt liegt dabei auf der Software und der Konfiguration. So können später auftretende Fehler besser lokalisiert und abgestellt werden.
Der Raspberry Pi wird als LAMP-Server (Linux, Apache, MariaDB, PHP) dienen, die Nextcloud zu betreiben. Wie man diese vier Bausteine aufsetzt, zeige ich im folgenden Abschnitt.
LAMP-Server
Installation
Der erste Baustein der installiert wird, ist Linux. Hierbei handelt es sich um das Betriebssystem Raspberry Pi OS. Dieses spielt man ganz einfach mit dem Raspberry Pi Imager auf die MicroSD.
Hier wählt man (siehe Screenshot) das zu installierende Betriebssystem aus. In diesem Fall ist es das Raspberry Pi OS (64-bit). Im Imager können vorab einige Einstellungen vorgenommen werden. Ich werde in dieser Anleitung einfache Bezeichnungen und Passwörter verwenden. Diese können während der Installation entsprechend frei angepasst werden!
Raspberry Pi Imager – OS und SD-Karte auswählenRaspberry Pi Imager – OS-Einstellungen vornehmen
Über das Zahnrad des Imagers lässt sich das Raspberry Pi OS vorkonfigurieren. Hier trägt man für den Anfang die entsprechenden Daten ein:
Danach wählt man am PC/Notebook die MicroSD aus, auf die geschrieben werden soll.
Raspberry Pi Imager – Schreibvorgang
Zum Schluss werden die Daten auf die MicroSD geflasht. Ist dies erledigt, kann die Karte ausgeworfen und in den vorbereiteten Raspbberry Pi (Kühlkörper, Gehäuse, Lüfter) geschoben werden. Dieser wird dann via LAN-Kabel mit dem heimischen Router verbunden und über das Netzteil mit Strom versorgt.
Natürlich könnte der RasPi auch via WLAN mit dem Router kommunizieren. Hiervon rate ich jedoch ab, da über die Funkverbindung oft nicht die volle Geschwindigkeit einer Ethernet-Verbindung genutzt werden kann. Weiterhin kann es zu Verbindungsabbrüchen bzw. -lücken kommen.
Nachdem der Raspberry Pi mit Strom versorgt wird, startet dieser. Ist der Raspberry Pi hochgefahren, kann dieser via arp-scan vom PC/Notebook im Netzwerk lokalisiert werden. In meinem Fall hat er die IP-Adresse 192.168.178.136.
sudo apt install arp-scan
sudo arp-scan -l
Identifizieren des RasPi mit arp-scan
Zugriff auf den Pi erhalte ich nun via zuvor im Imager aktiviertem SSH-Zugang.
ssh Benutzer@IP-Adresse
Zugang via SSH
Ist man eingeloggt, empfiehlt es sich die Lokalisierung über raspi-config auf deutsch (siehe Screenshots) umzustellen. Damit wird Datum und Uhrzeit des Servers an die europäische Zeitzone (Berlin) angepasst.
Nachdem die Installation durchgelaufen ist, kann man zum Testen den Webserver Apache via Browser über die Web-Adresse http://ip erreichen.
Anschließend wird die von der Nextcloud benötigte Datenbank installiert. Zuerst wird jedoch die mysql_secure_installation durchgeführt. Ich empfehle hier das Ganze gemäß meinen Empfehlungen (Enter, n, n, y, y, y, y) zu durchlaufen. Hierbei wird für den MariaDB-Server kein separates Root-Passwort vergeben, der anonyme User wird gelöscht, die Remote-Root-Anmeldung wird verboten, die Test-DB wird gelöscht und die Änderungen ausgeführt.
sudo mysql_secure_installation
If you’ve just installed MariaDB, and you haven’t set the root password yet, the password will be blank, so you should just press enter here. Enter
Switch to unix_socker_authentication [Y/n] n Change the root password? [Y/n] n Remove anonymous users? [Y/n] y Disallow root login remotely? [Y/n] y Remove test database and access to it? [Y/n] y Reload privilege tables now? [Y/n] y
Nachdem dieser Schritt durchgeführt wurde, kann über folgenden Befehl die Datenbank erstellt werden.
sudo mysql -u root -p
In meinem Fall heißen die Datenbank und der Benutzer „nextcloud“. Die Datenbank liegt dann auf dem „localhost“.
> CREATE DATABASE nextcloud;
> CREATE USER 'nextcloud'@'localhost' IDENTIFIED BY 'geheim';
> GRANT ALL ON nextcloud.* TO 'nextcloud'@'localhost';
> FLUSH PRIVILEGES;
> \q
Im Nachgang wechselt man in das Verzeichnis /var/www/html, wo die Nextcloud installiert wird. Die letzte Version wird vom Entwickler herunter geladen und entpackt. Danach wird die nicht mehr benötigte Zip-Datei wieder gelöscht und die Rechte der Dateien an den Benutzer www-data übertragen.
Nun ist die Nextcloud über http://ip/nextcloud (http://102.168.178.136/nextcloud) erreichbar. Man legt den Admin fest und trägt die Daten der zuvor erstellten MariaDB-Datenbank in die Eingabemaske ein. Hat das alles geklappt, dann dauert die Einrichtung ein paar Minuten und die Nextcloud steht bereit zum ersten Login des neuen Administrators.
Administrator-Konto anlegen
Vorschau
Im nächsten Teil zeige ich, wie man die App Collabora Online – Built-in CODE Server (ARM64) in der Nextcloud via Terminal installiert.
Die Entwickler von Immich haben nach der Kritik bzgl. der „Unlicensed“ Meldung nachgebessert und die Meldung heißt nun „Buy Immich“. Wie zuvor wird diese Meldung unten links angezeigt. Nach einem Klick auf die Meldung...

 Anmelden