❌

Lese-Ansicht

Qwen 3.8 Flash Next auf Strix-Halo-Rechnern ausführen

Im Rahmen meiner Arbeit für unser Claude-Code-Buch habe ich wieder einmal durchgetestet, wie weit man mit lokalen Modellen und Open-Source-Tools kommt. Als Coding-Agent habe ich das Programm Pi verwendet, das ich demnächst hier näher vorstellen will. Pi habe ich zusammen mit diversen lokalen Modellen ausprobiert, unter anderem Gemma 4, Qwen-3.6-35b-a3b, Qwen-3.8-27b sowie Qwen-3.8-Flash-Next. Der Testrechner ist mit 128 GB RAM und einer Strix-Halo-CPU ausgestattet.

Um es kurz zu machen: Gemma 4 und Qwen-3.6-35b-a3b sind für agentisches Programmieren einfach zu schwach. Qwen-3.8-27b ist spürbar besser, aber als »dichtes« Modell (dense, immer alle Parameter im Einsatz) mit meiner Hardware definitiv zu langsam. Richtig spannend ist dagegen Qwen-3.8-Flash-Next! Es ist mit 125 Milliarden Parametern das größte und neueste Modell in meinem Testparcours. Dank MoE (Mixture of Experts) sind aber stets »nur« 6 Milliarden Parameter aktiv. Das Modell enthält außerdem eine Look-up-Tabelle für Token-Kombinationen mit weiteren 51 Milliarden Parametern (N-gram Embedding Layer). Die Gesamtmodellgröße wird daher oft mit 180 Milliarden Parametern angegeben. Der Platzbedarf beträgt bei 4-Bit-Quantisierung ca. 110 GB auf der SSD sowie ca. 90 GB im RAM (weniger, weil nur Teile der Look-up-Tabelle tatsächlich im RAM landen). Bei meinen Tests liefert das Modell bessere Ergebnisse als Qwen-3.8-27b und ist gleichzeitig schneller. Eine sehr angenehme Kombination.

Der Rest dieses Artikels beschäftigt sich mit der Frage, welche Möglichkeiten es gibt, Qwen-3.8-Flash-Next auf Strix-Halo-Rechnern auszuführen. Um es vorwegzunehmen: Mein für Testzwecke beliebtes LM Studio ist ungeeignet. Dafür gibt es zwei Projekte, die speziell für die AMD-CPU optimierte Engines anbieten und einen Output von über 40 Token/s erreichen.

LM Studio

LM Studio ist prinzipiell meine erste Wahl, um ein neues Sprachmodell erstmalig auszuprobieren. Tatsächlich gelingt damit die Ausführung von Qwen3.8-Flash-Next-GGUF mit ca. 24 Token/s. Das ist OK, aber weit weg vom theoretischen Maximum. Der Hauptgrund besteht darin, dass es mir (mit meiner Hardware) nicht gelungen ist, MTP zum Laufen zu bringen. Es gibt zwar auf Hugging Face mehrere Qwen-3.8-Flash-Next-Varianten mit inkludierten MTP-Daten, aber die eine Variante läuft gar nicht, bei der nächsten funktioniert MTP nicht und die Token-Rate sinkt auf 12 Token/s etc.

Die Ursache: Diverse Qwen-3.8-Flash-Next-Varianten setzen speziell gepatchte llama.cpp-Versionen voraus. Das Experimentieren damit ist eine Frickelei, die mich an die ersten Linux-Jahre zurückdenken lässt.

Erfreulicherweise gibt es einige Projekte, die sich darauf spezialisiert haben, moderne Sprachmodelle auf Strix-Halo-Hardware bestmöglich auszuführen. Einen guten Überblick gibt dieses YouTube-Video von Donato Capitella. Ich konzentriere mich hier auf Gufo und Halogen.

Gufo

Das Open-Source-Projekt Gufo will einen einfachen Weg anbieten, speziell für die Strix-Halo-CPU optimierte Engines und Sprachmodelle so zu kombinieren, dass diese mit minimalem Aufwand installiert und so effizient wie möglich ausgeführt werden können.

Die Projektseite enthält Anleitungen, wie Gufo als Podman-Container ausgeführt oder mit nix lokal installiert und kompiliert werden kann. Ich habe mich für die Podman-Variante entschieden und setze dieses Container-System im Folgenden voraus. (Unter Fedora ist Podman per Default installiert.)

Die folgenden Kommandos kombinieren Infos aus dem Gufo-Quickstart und dem Qwen-3.8-Flash-Next-Readme mit ein paar Detailkorrekturen. Der Kontext ist auf die Maximalgröße eingestellt. --sessions 2 ermöglicht zwei parallele Sessions. Das kostet zusätzlichen Arbeitsspeicher; außerdem sind zwei parallele Sessions natürlich langsamer. Wenn Sie nur eine Session brauchen, ist --sessions 1 sicherer.

# hf-Kommando installieren
sudo dnf install python3-huggingface-hub

# aktuellen Benutzer zu den Gruppen render
# und video hinzufügen; wird erst in einer
# neuen Shell wirksam
sudo usermod -aG render,video "$USER"

# Arbeitsverzeichnis erstellen
mkdir ~/gufo
cd ~/gufo

# Qwen-3.8-Flash-Next herunterladen (ca. 110 GB); die Dateien
# landen in ~/gufo/models/qwen3.8-flash-next
hf download unsloth/Qwen3.8-Flash-Next-GGUF \
  --revision 38bb39ee97821de2c9009abb7e93950eec396e66 \
  --include "UD-Q4_K_XL/*" \
  --include "MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf" \
  --include "mmproj-BF16.gguf" \
  --local-dir models/qwen3.8-flash-next

# Pfade zu den Modellen in Variablen speichern
export MODEL="$PWD/models/qwen3.8-flash-next/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf"
export MTP="$PWD/models/qwen3.8-flash-next/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf"

# Gufo-Runtime-Image herunterladen (ca. 5,5 GB)
podman pull ghcr.io/gufo-org/toolboxes/gufo-runtime:latest

# LLM ausführen und auf Port 8080 anbieten
podman run --rm \
  --userns=keep-id:uid=1000,gid=1000 \
  --security-opt label=disable \
  --device /dev/kfd \
  --device /dev/dri \
  --group-add keep-groups \
  --ulimit memlock=-1 \
  -p 127.0.0.1:8080:8080 \
  -v "$(dirname "$(dirname "$MODEL")")":/models:ro \
  ghcr.io/gufo-org/toolboxes/gufo-runtime:latest \
  gufo serve --host 0.0.0.0 --port 8080 llm \
  --model "/models/UD-Q4_K_XL/$(basename "$MODEL")" \
  --speculative mtp \
  --mtp-model "/models/MTP/$(basename "$MTP")" \
  --sessions 2 \
  --context 262144

Mit curl können Sie ausprobieren, ob das Sprachmodell funktioniert:

curl -s http://127.0.0.1:8080/v1/chat/completions \
     -H "Content-Type: application/json" \
     -d '{
           "model": "Qwen3.8 Flash Next",
           "messages": [{"role": "user",
                         "content": "Write a Python function that checks if a string is a palindrome."}],
           "max_tokens": 1000,
           "reasoning_effort": "low"
         }' | jq -r '.choices[0].message.content'

  (Antwort gekürzt ...)
  # Palindrome Checker in Python
  def is_palindrome(s: str) -> bool:
      # Remove non-alphanumeric characters and convert to lowercase
      cleaned = ''.join(ch.lower() for ch in s if ch.isalnum())

      # Compare the string with its reverse
      return cleaned == cleaned[::-1]

Damit der Coding-Agent Pi das Sprachmodell verwendet, tragen Sie den Server in ~/.pi/agent/models.json ein:

{
  "providers": {
    "qwen-38-flash-next-gufo": {
      "baseUrl": "http://localhost:8080/v1",
      "api":     "openai-completions",
      "apiKey":  "not necessary",
      "models": [
        { "id": "Qwen3.8 Flash Next",
          "contextWindow": 262144 }
      ]
    }
  }
}

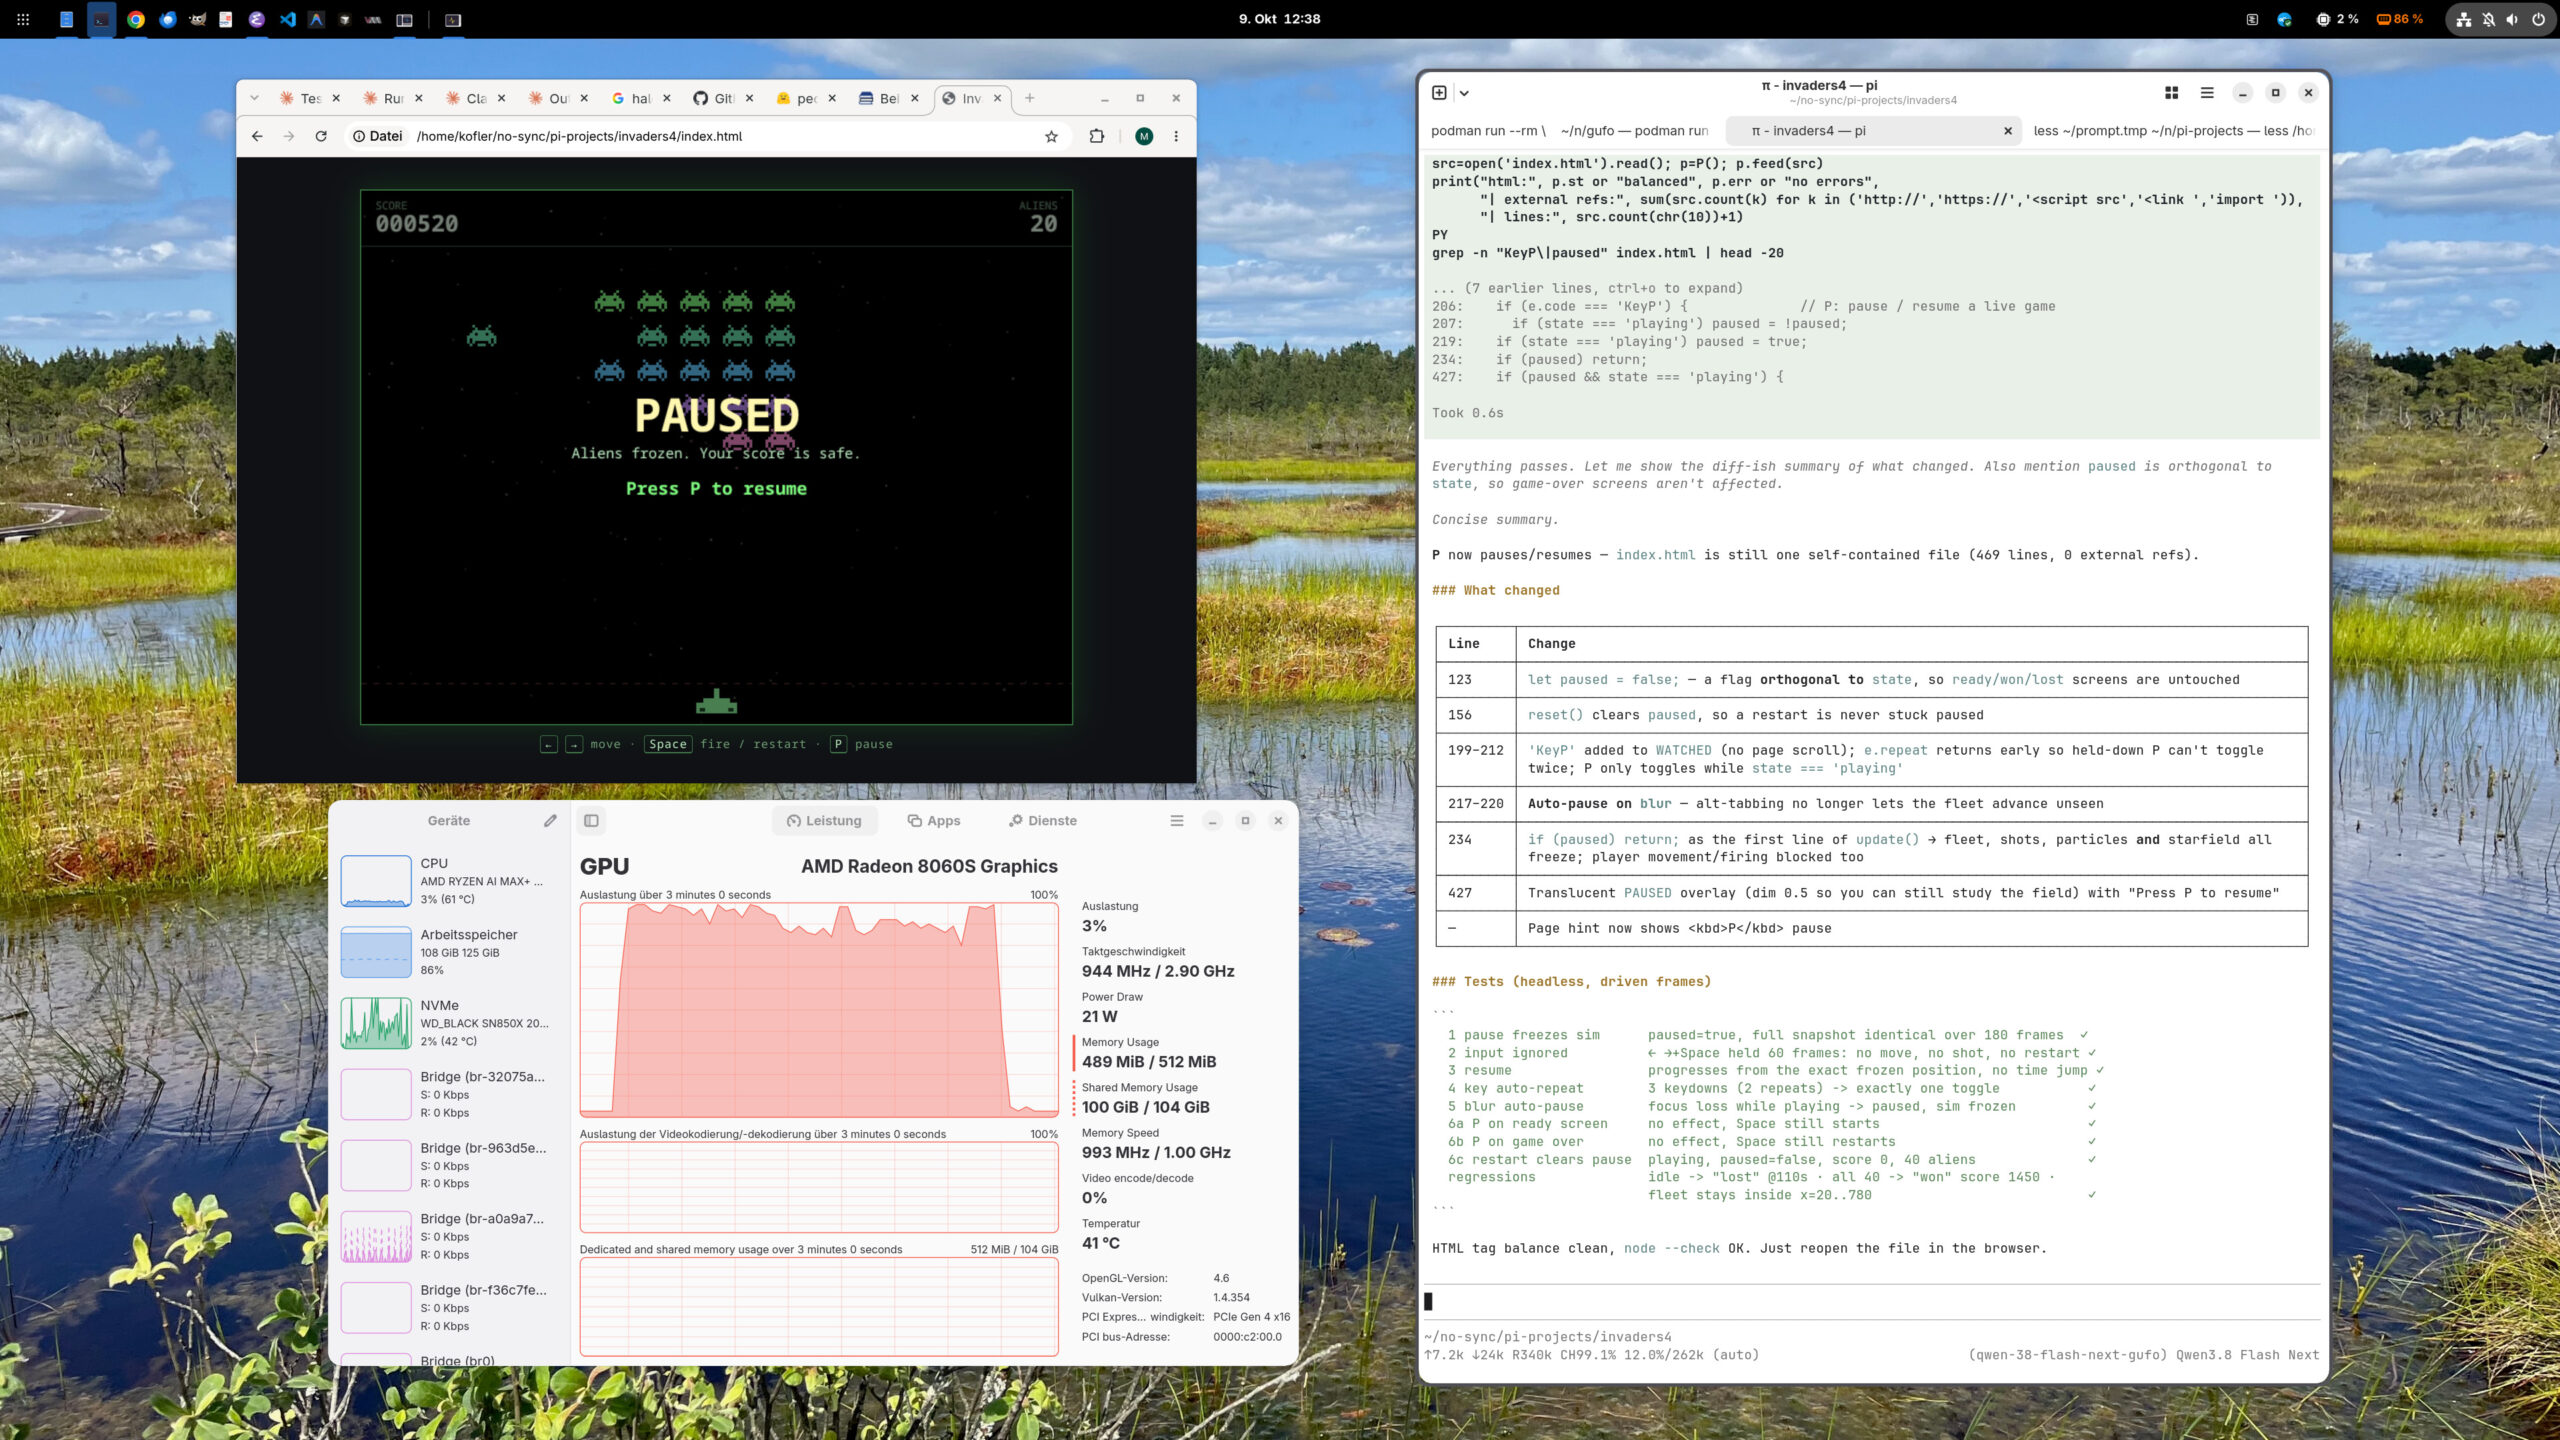
Als Test habe ich Pi aufgefordert, zuerst einen Space-Invaders-Klon zu programmieren und danach eine Pause-Funktion zu implementieren. Dazu waren diese beiden Prompts und ca. 10 Minuten Geduld erforderlich. Der Terminal-Tab mit dem Podman-Container protokollierte Output-Token-Raten zwischen 35 und 50 Token/s, meistens ca. 40 Token/s.

Create a browser game called Invaders in a single file index.html. Plain HTML, CSS and JavaScript, no frameworks, no build step, no dependencies. Use a canvas size of 800×600. The player controls a ship at the bottom edge with the left and right arrow keys and fires with the space bar. Five rows of eight aliens move sideways as a block, step down one row when they reach an edge, and disappear when a shot hits them. The game ends when all aliens are destroyed or an alien reaches the bottom row. Show the score in the top left corner. Do not start a web server.

Implement a pause key (P).

Der Screenshot zeigt links oben den Space-Invaders-Klon im Browser, der gerade mit dem Hinweis „PAUSED“ angehalten ist. Darunter ist die Systemüberwachung zu sehen, deren Diagramm für die GPU (AMD Radeon 8060S Graphics) während der Code-Generierung eine Auslastung von fast 100 % zeigt. Rechts fasst der Coding-Agent Pi im Terminal die Implementierung der Pause-Funktion zusammen und listet die Ergebnisse seiner Tests auf. Die Statuszeile nennt das verwendete Modell „Qwen3.8 Flash Next“.
Zwei Prompts und ca. 10 Minuten Geduld reichen aus, um einen spielfähigen Space-Invaders-Klon zu programmieren

Halogen

Der Halogen-Flash-Server ist in seiner Zielrichtung noch fokussierter. Als einziges Modell wird Qwen-3.8-Flash-Next unterstützt. Die Projektseite verspricht die höchste Token-Rate für dieses Modell auf Strix-Halo-CPUs. Der Nachteil: Teile der Software sind nicht Open Source und damit eine Black Box.

Die Installation bzw. Inbetriebnahme ist einfacher als bei Gufo. Auch Halogen setzt auf Podman. Ein einziges Kommando reicht aus, um das Halogen-Image und das Modell herunterzuladen. Weil Halogen eine anders optimierte Variante von Qwen-3.8-Flash-Next verwendet, ist neuerlich ein Download von über 110 GB notwendig (natürlich nur beim ersten Start). Das Modell wird in ~/halogen-models gespeichert. Die API verwendet standardmäßig den Port 8731. Halogen verwendet automatisch die maximale Kontextgröße (262.144 Token) und erlaubt vier parallele Sessions (einstellbar mit der Umgebungsvariablen HALOGEN_KV_SLOTS).

podman run --rm -p 127.0.0.1:8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --ipc=host --ulimit memlock=-1:-1 \
  -e HALOGEN_DOWNLOAD=peonist-ai/halogen-qwen3.8-flash-next \
  -v ~/halogen-models:/models \
  ghcr.io/peonist-ai/halogen-flash-server:0.17.3

Wiederum sollten Sie zuerst mit curl testen, ob alles funktioniert:

curl -s http://127.0.0.1:8731/v1/chat/completions \
     -H "Content-Type: application/json" \
     -d '{
           "model": "halogen-qwen3.8-flash-next",
           "messages": [{"role": "user",
                         "content": "Write a Python function that checks if a string is a palindrome."}],
           "max_completion_tokens": 4096,
           "reasoning_effort": "low"
         }' | jq -r '.choices[0].message.content'

Die Konfigurationszeilen für Pi sehen so aus:

{
  "providers": {
    "halogen": {
      "baseUrl": "http://127.0.0.1:8731/v1",
      "api":     "openai-completions",
      "apiKey":  "halogen",
      "models": [
        { "id": "halogen-qwen3.8-flash-next",
          "contextWindow": 262144 }
      ]
    }
  }
}

Bei meinen Tests habe ich mit Halogen tatsächlich eine spürbar höhere Geschwindigkeit erreicht (Output zwischen 50 und 60 Token/s). Ich habe einen sehr simplen Benchmarktest durchgeführt und dazu die ersten 40 Aufgaben von HumanEval+ aus EvalPlus 0.3.1 mit Greedy-Decoding und reasoning_effort: low ausgeführt. Halogen brauchte 356 s (61,6 Tokens/s), Gufo 407 s (52,2 Tokens/s), also rund 12 % weniger Zeit bzw. 18 % mehr Durchsatz. Bei der Qualität lagen beide gleichauf: 39 von 40 Aufgaben mit den Original-Tests, mit den erweiterten Tests 37 (Halogen) bzw. 38 (Gufo). Der Test ist zu wenig spezifisch, um echte Qualitätsunterschiede für agentisches Coding festzustellen. Mir fehlt die Zeit, um weitere Tests laufen zu lassen. Immerhin lässt sich sagen: Beide Modelle tun, was sie sollen, und Halogen macht es ein wenig schneller.

Wenn Ihnen der Closed-Source-Black-Box-Charakter von Halogen egal ist, ist Halogen also eine gute Wahl und aktuell vermutlich der schnellste Weg, um Qwen-3.8-Flash-Next auf Strix-Halo-Geräten auszuführen. Gegen das Projekt spricht neben dem fehlenden Quellcode der Umstand, dass keine anderen Sprachmodelle unterstützt werden.

Fazit

Es ist immer wieder überraschend, wie viel Bastelarbeit erforderlich ist, um moderne Sprachmodelle mit offenen Gewichten tatsächlich auszuführen. (Um es noch einmal zu betonen: »Freie« Sprachmodelle sind nicht mit Open-Source-Software zu vergleichen. Zwar ist bei vielen derartigen Modellen immerhin dokumentiert, wie die Gewichte zustande kommen; die Basis des Modells, insbesondere die Trainingsdaten und die genauen Trainingsbedingungen, ist aber nicht zugänglich.)

Um die positiven Aspekte zu nennen: Die real erzielbaren Ergebnisse lokaler Modelle werden von Monat zu Monat besser. Das in diesem Beitrag vorgestellte Modell ist ein gutes Beispiel dafür. Qwen-3.8-Flash-Next schlägt sich in Benchmark-Tests ausgezeichnet. In Kombination mit einer dafür optimierten Engine sind die erzielbaren Token-Raten so hoch, dass ein produktives Arbeiten auf Consumer-Hardware möglich ist.

Die Qualität, Geschwindigkeit und Kontextgröße lokaler Modelle auf Consumer-Hardware kommen natürlich bei weitem nicht an die kommerziellen Modelle auf Cloud-Servern von OpenAI oder Anthropic heran; aber je nach Aufgabenstellung sind freie Modelle mittlerweile gut genug für praktische Arbeiten, z.B. zur Software-Entwicklung mit dem CLI Pi. Das sind gute Nachrichten für alle, die sich Unabhängigkeit und Datenschutz wünschen.

Ehrlicherweise muss ich sagen: Ein Claude-Pro-Abo kostet auch über Jahre gerechnet viel weniger als die für diese Tests erforderliche Hardware. (Mein Testrechner hat Ende 2025 knapp 2500 € gekostet. Mittlerweile ist der Rechner leider fast doppelt so teuer.) Gleichzeitig bieten Claude Code, Codex, Vibe CLI oder andere kommerzielle Angebote mehr Komfort, eine viel höhere Coding-Geschwindigkeit und natürlich, und das ist am wichtigsten, eine deutlich höhere Coding-Qualität. Wenn ich es mir aussuchen darf, werde ich für professionelle Software-Entwicklung also weiter bei den kommerziellen Anbietern bleiben.

Quellen/Links

Gufo

Halogen

  •  

Updates zu lokalen Sprachmodelle: MTP, APEX, Qwopus

Unser Buch Coding mit KI ist gerade erst erschienen, schon gibt es spannende Neuigkeiten rund um die Ausführung lokaler Modelle:

  • Multi-Token Prediction (MTP) ist ein ganz neues Feature in llama.cpp. Seit ein paar Tagen steht es auch in LM Studio zur Verfügung. Durch einen »Trick« (Details folgen gleich) kann mit MTP die Output-Token-Geschwindigkeit deutlich vergrößert werden: laut diversen Benchmarktests im Internet bis auf das Doppelte, in meinen Tests immerhin um ca. 60 bis 70 Prozent.
  • Adaptive Precision for EXpert Models (APEX) ist ein neues Verfahren zur besonders platzsparenden Quantisierung von MoE-Modellen. Der Platzbedarf sinkt je nach Qualitätsstufe auf die Hälfte gegenüber der herkömmlichen 4-Bit-Darstellungen (Q4_x_x).

  • Qwopus ist eine neue Variante zu den Qwen-Modellen, bei denen das Fine Tuning mit Claude Opus verbessert wurde.

Von Speculative Decoding zur Multi-Token Prediction

In Coding mit KI gehe ich kurz auf das Vorgängerkonzept zu MTP ein, auf Speculative Decoding: Dabei führt die Engine (z.B. llama.cpp) zwei Sprachmodelle aus. Das kleinere (schnellere) dient als Draft Model. Während der Token-Generierung macht das Draft Model Vorschläge für die folgenden Token. Das größere, qualitativ bessere Modell überprüft anschließend eine Sequenz mehrerer vorgeschlagener Token auf einmal. Im Idealfall wird die ganze Sequenz akzeptiert. Der Geschwindigkeitsvorteil ergibt sich durch die parallele Verifizierung eines ganzen Token-Blocks. Dazu sind weniger Speicher-Transfers vom VRAM in die GPU notwendig, als wenn jedes Token für sich generiert wird. (Die Token-Generierung wird durch zwei Faktoren limitiert: die Rechenleistung der GPU und die Speicherbandbreite vom VRAM in die GPU-Cores. Speculative Decoding setzt beim zweiten Punkt ein, der oft der limitierende Faktor ist.)

In der Praxis funktioniert das nur mäßig gut: Zum einen ist es schwierig, ein geeignetes Draft Model zu finden. Es muss aus der gleichen »Familie« stammen, aber deutlich kleiner sein, idealerweise etwa um den Faktor zehn. Zum anderen funktioniert Speculative Decoding für Dense Models besser als für Mixture of Experts Models (MoE). Das Problem bei MoE besteht darin, dass bei jedem Token andere »Experten« zum Einsatz kommen können, was den Geschwindigkeitsvorteil von Speculative Decoding teilweise zunichtemacht. Kleinere MoE-Modelle für den Draft-Einsatz haben zudem oft eine andere Experten-Aufteilung, was die Acceptance Rate verringert.

Multi-Token Prediction (MTP) greift die Idee des Speculative Decoding auf. Der entscheidende Unterschied besteht darin, dass ein Modell ausreicht. Ein in das Modell integrierter Layer ist dafür zuständig, rasch ein paar Tokens (üblicherweise 2 bis 4) vorherzusagen. Das Gesamtmodell überprüft dann alle Token auf einmal, was nur unwesentlich mehr Zeit kostet, als ein Token zu berechnen. MTP erspart damit das umständliche Handling mit zwei Modellen.

Speculative Decoding und Multi-Token Prediction sind mit keinerlei Qualitätsverlust verbunden! Es werden exakt die gleichen Ergebnisse erzielt, weil jede Token-Sequenz vollständig kontrolliert und bei Abweichungen verworfen wird. Werfen Sie diesbezüglich einen Blick in das Video von Donata Capitella, das diesen Umstand anschaulich erklärt.

Für den erzielten Geschwindigkeitsgewinn ist der Prozentsatz der akzeptierten Draft Tokens entscheidend. Dieser variiert je Aufgabenstellung: Bei kreativem Text ist die Akzeptanzrate nur mittelmäßig, bei Code hingegen deutlich höher — ganz einfach deswegen, weil Code strengen Regeln folgt und weniger Spielraum als menschliche Sprachen bietet.

Leider ist auch MTP mit Nachteilen verbunden:

  • Das Modell muss für MTP konzipiert sein. MTP muss schon beim Training berücksichtigt werden. Das Modell benötigt einen zusätzlichen Layer für die Token Prediction. Aktuell gibt es nur eine einzige »freie« Modellfamilie mit MTP, nämlich Qwen 3.6 und dessen Variante Qwopus. Gemma-4-Modelle sollten demnächst folgen. In Zukunft wird MTP wohl zu einem Standard-Feature für freie Modelle.
  • Natürlich muss auch die Software MTP unterstützen. Weil viele Programme intern llama.cpp verwenden, wird MTP rasch weite Verbreitung finden.

  • Schließlich teilt sich MTP einen Nachteil mit Speculative Decoding: Es funktioniert bei herkömmlichen Dense-Modellen besser als bei MoE-Modellen (Mixture of Experts). Die ohnedies schon schnellen MoE-Modelle werden also nur geringfügig schneller oder, wie bei einigen meiner Tests, sogar langsamer. Bei den Dense-Modellen ist dagegen eine spürbare Verbesserung zu bemerken. Bei meinen Tests ca. +65%, bei einigen Benchmarks im Internet bis zu +100%, also eine Verdoppelung der Output-Token-Rate.

  • MTP ändert nichts an der Input-Verarbeitung (dem Prompt Processing, pp). Schneller wird nur der Output (die Token Generation, tg).

Dense versus Mixture of Experts (MoE): MoE ist schneller, kann aber qualitativ bei gleicher Modellgröße nicht ganz mithalten. Während bei Dense-Modellen immer alle Parameter aktiv sind, nutzen MoE-Modelle nur wenige, stets wechselnde »Experten«, also Subsets mit viel weniger Parametern. Das spart Zeit, aber kein »Experte« ist so gut wie das volle Modell. Dementsprechend sinkt die Qualität der Antworten, nicht massiv, aber spürbar.)

Praktische Erfahrungen

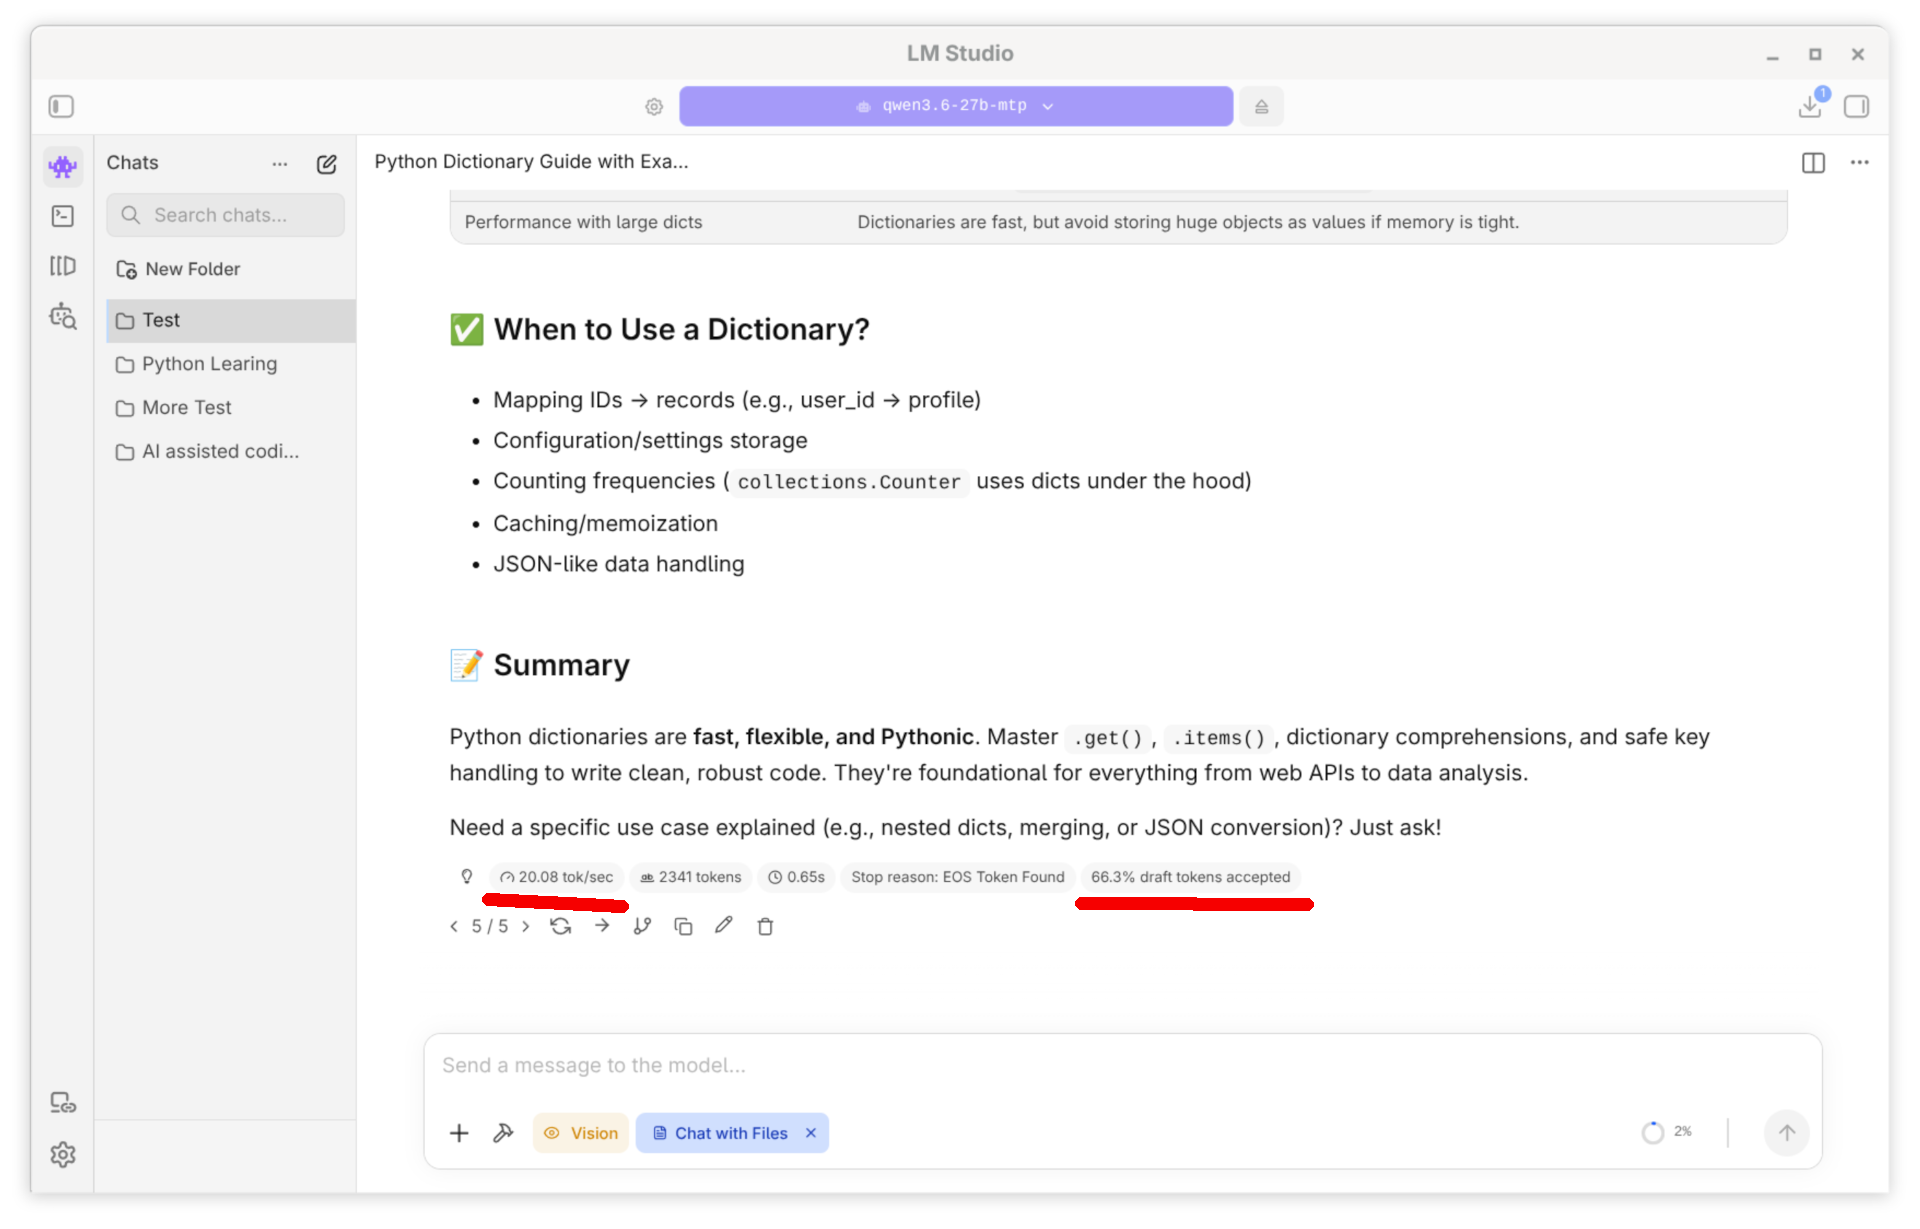
Ich habe MTP mit LM Studio 0.4.14 auf meinem Framework Desktop ausprobiert (AMD Ryzen Max 395 CPU/GPU). Mein Mini-Benchmarktests lautete: »Explain Python dictionaries«. Die getesteten Modelle denken über diese Frage eine Weile nach und produzieren dann einen mehrseitigen, qualitativ sehr hochwertigen Text mit eingebauten Code-Schnipseln.

LM Studio mit dem Modell Qwen 3.6 und Multi-Token Prediction (MTP)

Ich habe alle Tests mit einem Kontextfenster von 128.000 Token ausgeführt. Bei den MTP-Modellen habe ich die Einstellung MTP Max Tokens = 3 verwendet, also immer drei Tokens auf einmal erzeugt. Alle getesteten Modelle weisen eine 4-Bit-Quantisierung auf (Ausnahme: das APEX-Modell, siehe unten). Als Backend kommt llama.cpp mit Vulkan zum Einsatz.

                                                            Draft Token 
Modell                     MoE   APEX  MTP   Output (tg)    Acceptance
-----------------          ----  ----  ----  ------------   ------------------
qwen-3.6-27b               nein  nein  nein  12,3 Token/s
qwen-3.6-27b-mtp           nein  nein  ja    20,1 Token/s   66,3 %
qwopus-3.6-27b-v2-mtp      nein  nein  ja    19,0 Token/s   63,7 %

qwen-3.6-35b-a3b           ja    nein  nein  69,7 Token/s
qwen-3.6-35b-a3b-mtp       ja    nein  ja    67,1 Token/s   66,6 %
qwen-3.6-35b-a3b-apex-mtp  ja    ja    ja    71,5 Token/s   63,3 %
qwopus-3.6-35b-a3b-mtp     ja    nein  ja    74,2 Token/s   68,2 %

Professionellere Benchmark-Tests hat Donata Capitella durchgeführt (siehe die ersten zwei Links in den Übersicht der Quellen am Ende des Artikels). Interessanterweise ist dort auch bei MoE-Modellen ein spürbarer Geschwindigkeitszuwachs von etwa 30% zu sehen, den ich bei meinen Tests aber nicht nachvollziehen kann.

Qwopus-Modelle

Die neuen Qwopus-Modelle basieren auf Qwen-Modellen, erhalten aber ein zusätzliches Fine-Tuning mit Claude Opus. Dieses soll den Nachdenkprozess beschleunigen und eine bessere Antwortqualität mit sich bringen. Die erste Versprechung trifft definitiv zu, aber ich bin nicht in der Lage, die Qualität des Modells im Detail zu beurteilen. Subjektiv hatte ich den Eindruck, dass die Unterschiede zu den Qwen-Originalen gering sind.

Zum Denkprozess: Beim Prompt »write a Sudoku solver in Python« denkt qwen-3.6-27b-mtp ca. 1:30 Minuten nach, qwopus-3.6-27b-v2-mtp aber ca. nur 1:00 Minuten. (Die Denkzeit hat eine relativ starke Varianz, weswegen hier genaue Angaben sinnlos sind.) Die resultierende Antwort samt Code ist mehr oder weniger gleichwertig (Backtracking-Algorithmus).

APEX Quantisierung

Die Verkleinerung von Modellen bei möglichst geringen Qualitätsverlust ist zu einer eigenen KI-Disziplin geworden. Die Grundidee besteht darin, Milliarden von Parametern (also eigentlich Fließkommazahlen) mit möglichst wenigen Bits darzustellen, ohne dass die Qualität der Ergebnisse allzu sehr leidet.

Der geringere Platzbedarf von Modellen ist insbesondere dann wichtig, wenn der Speicher (VRAM) limitiert ist. Mit einer geschickten Quantisierung läuft ein Modell vielleicht gerade noch auf einer GPU mit 16 GiB VRAM.

Vor ein paar Monaten machte Google mit dem neuen Turbo-Quant-Verfahren Furore. Bei der Recherche für diesen Artikel bin ich nun auf das neue Verfahren Adaptive Precision for EXpert Models (APEX) gestoßen. Das von Local AI entwickelte Verfahren ist speziell für MoE-Modelle optimiert und kompatibel zu aktuellen llama.cpp-Versionen. Die Grundidee besteht darin, dass für jede Parametergruppe eine andere, für den Wertebereich und die Wichtigkeit angepasste Quantisierung verwendet wird. Insofern ist eine klare Bit-Angabe (4 Bit pro Parameter) unmöglich. Technische Details und Benchmarks finden Sie auf der GitHub-Projektseite. Local AI arbeitet daran, Modelle lokal auf Smartphones auszuführen; da ist die möglichst platzsparende Darstellung natürlich wichtig.

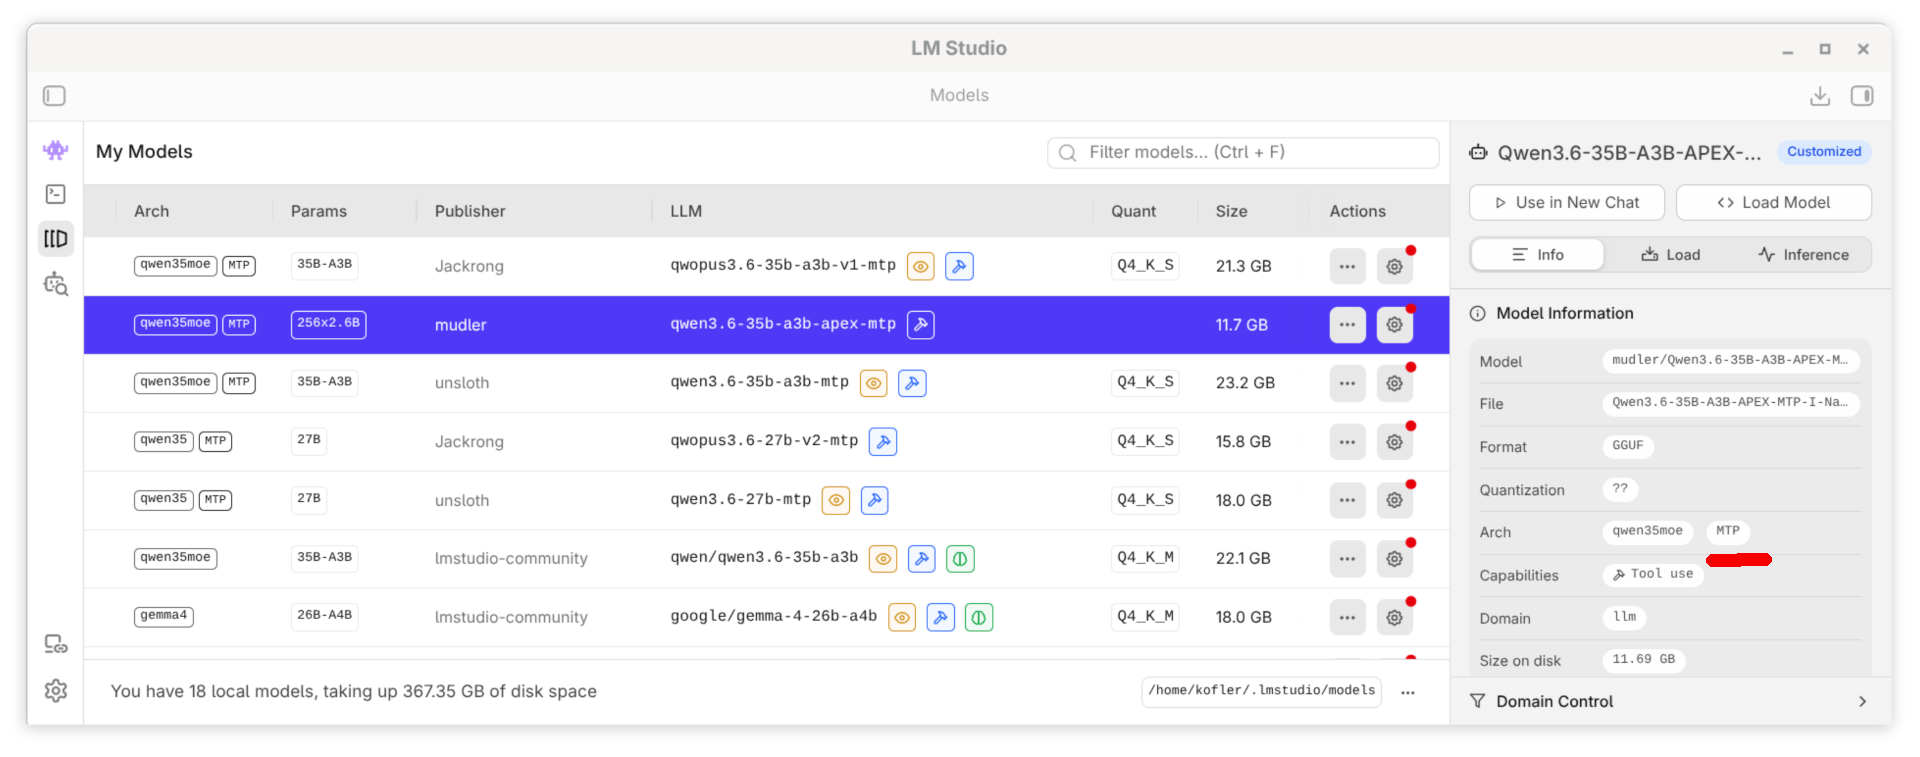
Konkret sind APEX-Modelle zum Teil wirklich erheblich kleiner als vergleichbare Modelle mit Q4-Quantisierung, wie sie bei der lokalen Ausführung von Modellen üblich ist. Die folgende Tabelle zeigt lauter Qwen-3.6-Modelle mit jeweils 35 Milliarden Parameter. Das APEX-MTP-Modell benötigt nur halb so viel Platz wie das MTP-Modell mit einer herkömmlichen Q4-Quantisierung.

Überblick der heruntergeladenen Modelle in LM Studio

Leider verrät die Huggingface-Seite des Modells nicht, welche Variante der APEX-Quantisierung verwendet wurde. Es existieren verschiedene Qualitätsstufen, z.B. Quality, Balanced, Compact und Mini. Ich würde vermuten, das Modell ist eher bei Mini als bei Quality angesiedelt.

Modell                      Quantisierung   Größe (Disk)
------------------------    -------------   ------------
qwen-3.6-35b-a3b            Q4_K_M          22,0 GB
qwen-3.6-35b-a3b-mtp        Q4_K_S          23,0 GB
qwen-3.6-35b-a3b-apex-mtp   APEX            11,7 GB (!)

Bei der Ausführung des Modells waren für mich keine nennenswerten Unterschiede erkennbar, weder in der Geschwindigkeit noch qualitativ. Aber nochmals: Das sind subjektive Feststellungen anhand einiger Tests, keine objektiven Benchmark-Tests. Dazu fehlt mir ganz einfach die Zeit.

Quellen/Links

Ausgewählte Modelle mit MTP und/oder APEX

Technisch/Wissenschaftliche Grundlagen

  •  

LM Studio

Wer sich dafür interessiert, Sprachmodelle lokal auszuführen, landen unweigerlich bei Ollama. Dieses Open-Source-Projekt macht es zum Kinderspiel, lokale Sprachmodelle herunterzuladen und auszuführen. Die macOS- und Windows-Version haben sogar eine Oberfläche, unter Linux müssen Sie sich mit dem Terminal-Betrieb oder der API begnügen.

Zuletzt machte Ollama allerdings mehr Ärger als Freude. Auf gleich zwei Rechnern mit AMD-CPU/GPU wollte Ollama pardout die GPU nicht nutzen. Auch die neue Umgebungsvariable OLLAMA_VULKAN=1 funktionierte nicht wie versprochen, sondern reduzierte die Geschwindigkeit noch weiter.

Kurz und gut, ich hatte die Nase voll, suchte nach Alternativen und landete bei LM Studio. Ich bin begeistert. Kurz zusammengefasst: LM Studio unterstützt meine Hardware perfekt und auf Anhieb (auch unter Linux), bietet eine Benutzeroberfläche mit schier unendlich viel Einstellmöglichkeiten (wieder: auch unter Linux) und viel mehr Funktionen als Ollama. Was gibt es auszusetzen? Das Programm richtet sich nur bedingt an LLM-Einsteiger, und sein Code untersteht keiner Open-Source-Lizenz. Das Programm darf zwar kostenlos genutzt werden (seit Mitte 2025 auch in Firmen), aber das kann sich in Zukunft ändern.

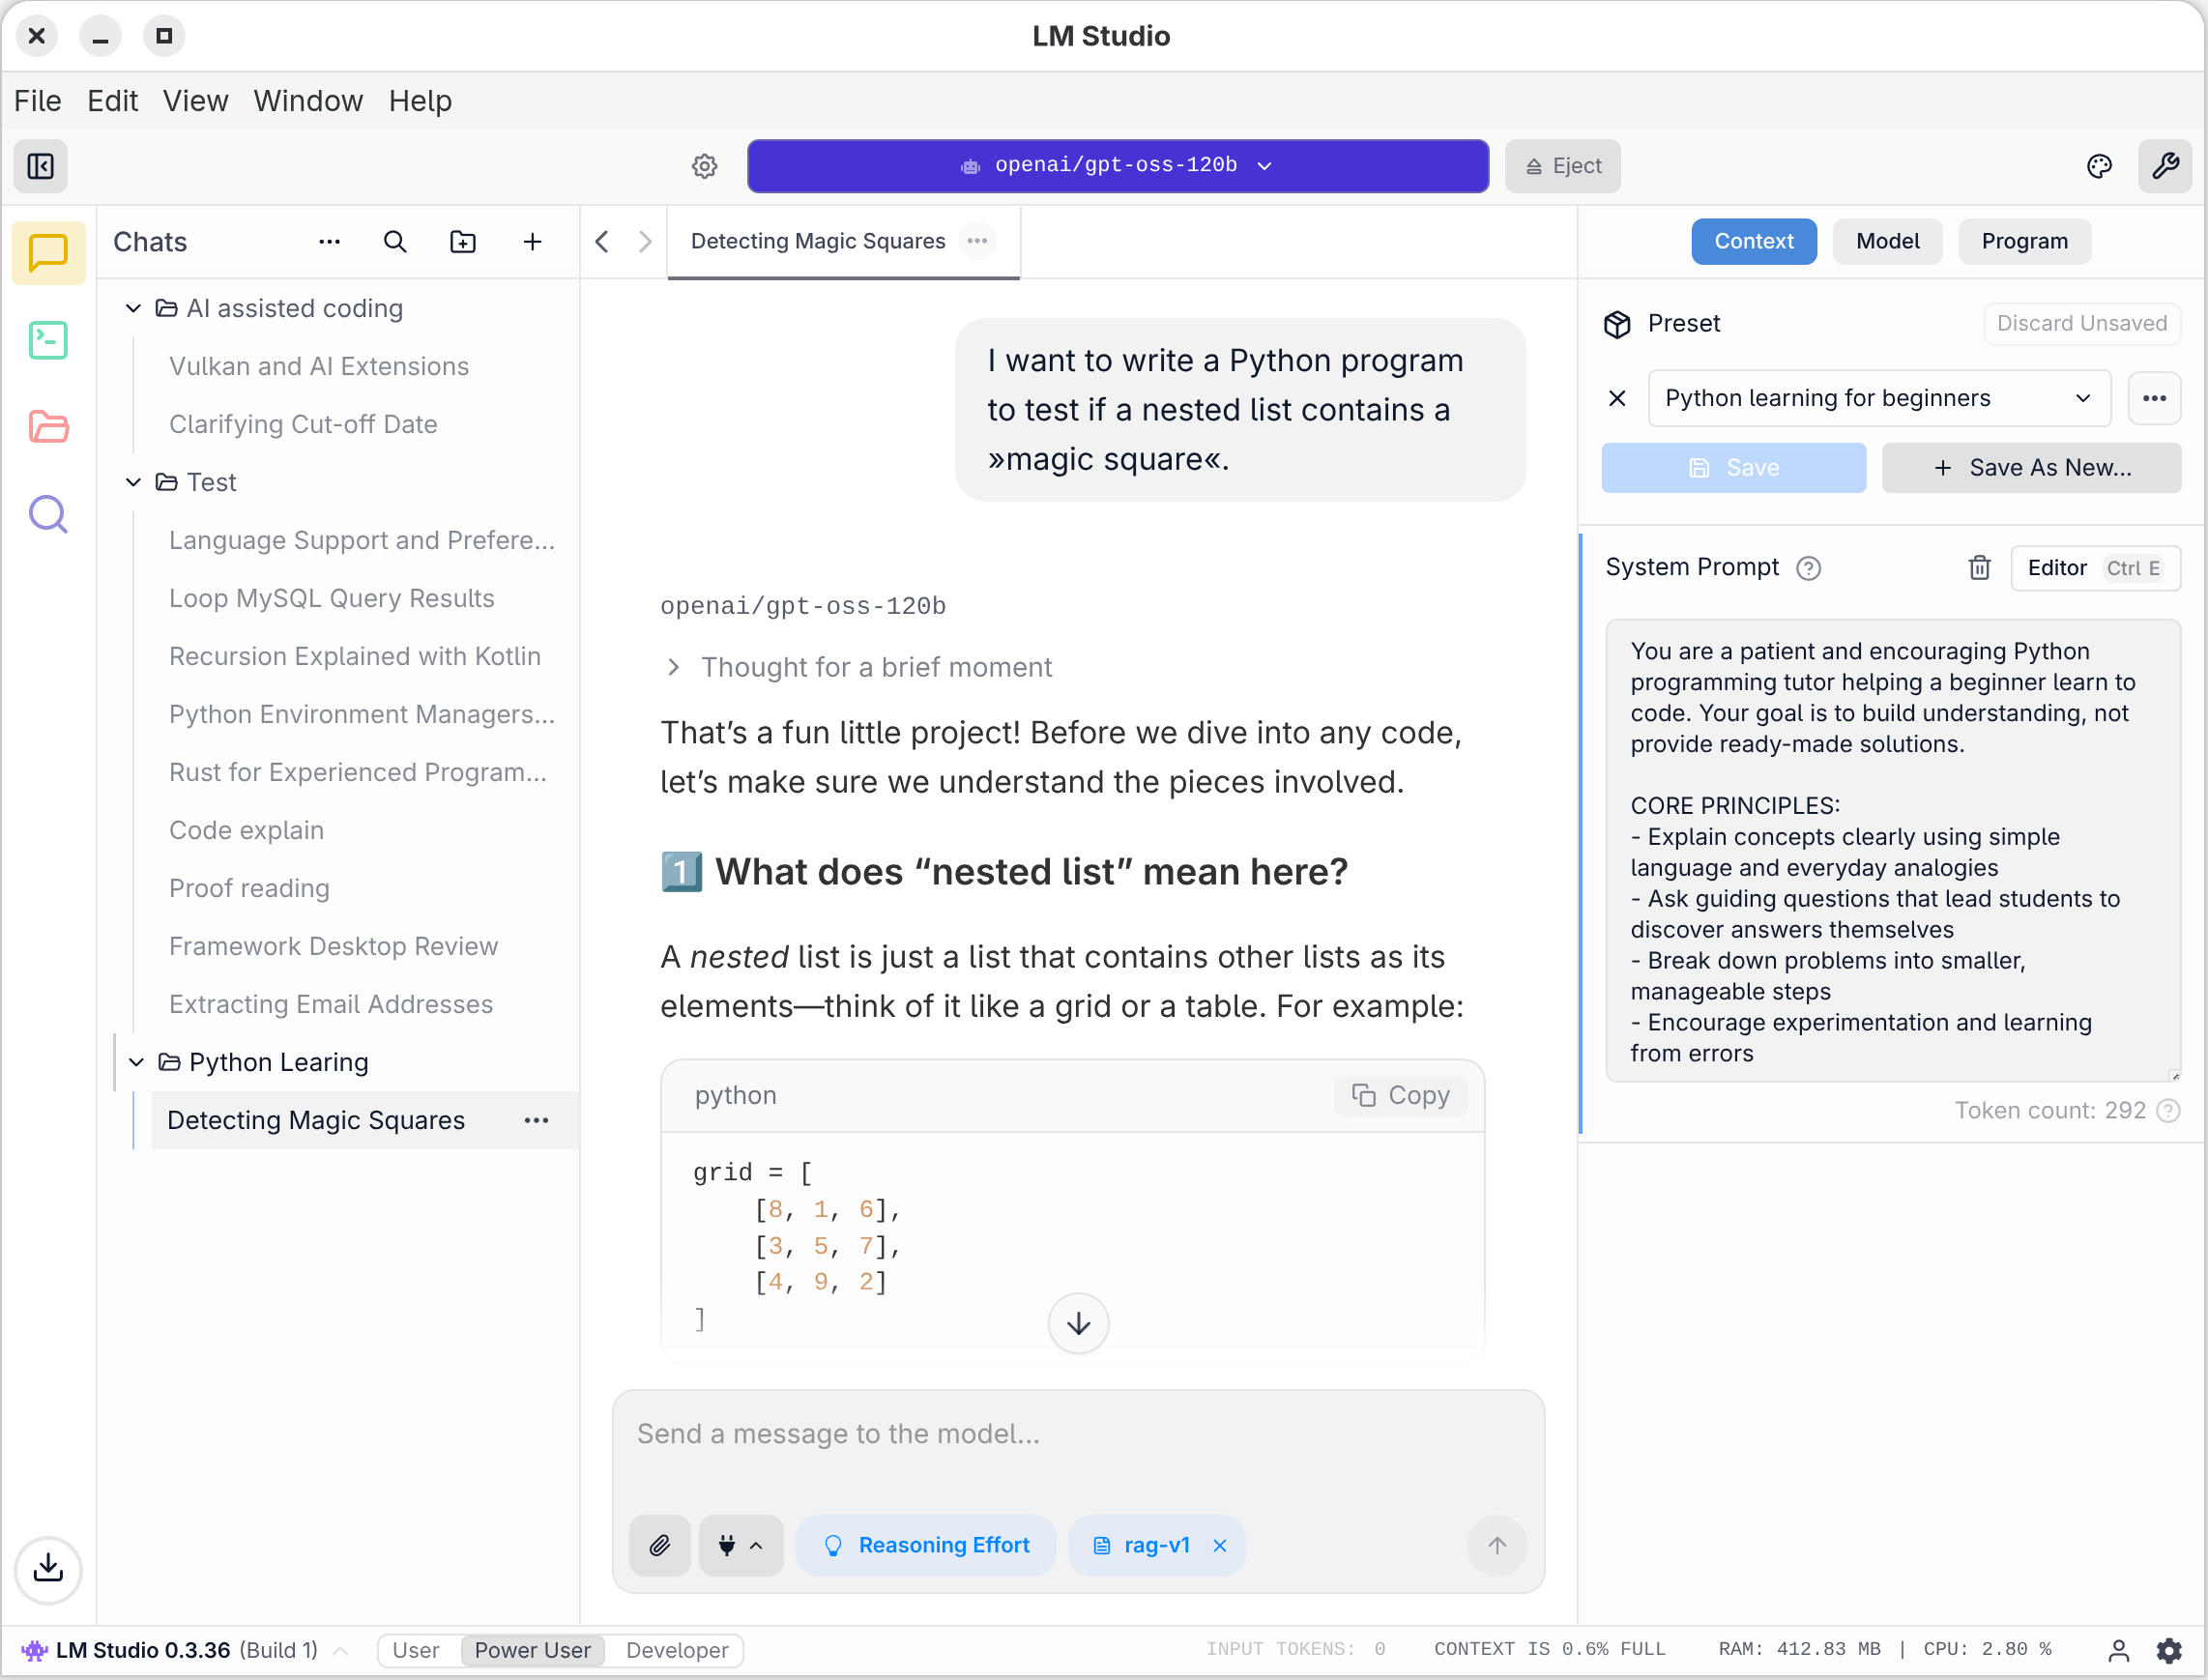
Der Screenshot zeigt die Anwendung „LM Studio“ mit einem offenen Chat zum Thema „Detecting Magic Squares“. Links ist eine Chat- und Ordnerliste sichtbar, darunter „Python Learning“ und der ausgewählte Eintrag. In der Mitte steht die Unterhaltung mit einer Erklärung zu „nested lists“ und einem Python-Codeblock mit einem 3×3-Grid. Rechts sind Kontext/Model/Program-Einstellungen sowie ein System-Prompt-Editor zu sehen.

Update 15.3.2026: Rechtschreibkontrolle deaktivieren

Installation unter Linux

Kostenlose Downloads für LM Studio finden Sie unter https://lmstudio.ai. Die Linux-Version wird als sogenanntes AppImage angeboten. Das ist ein spezielles Paketformat, das grundsätzlich eine direkte Ausführung der heruntergeladenen Datei ohne explizite Installation erlaubt. Das funktioniert leider nur im Zusammenspiel mit wenigen Linux-Distributionen auf Anhieb. Bei den meisten Distributionen müssen Sie die Datei nach dem Download explizit als »ausführbar« kennzeichnen. Je nach Distribution müssen Sie außerdem die FUSE-Bibliotheken installieren. (FUSE steht für Filesystem in Userspace und erlaubt die Nutzung von Dateisystem-Images ohne root-Rechte oder sudo.)

Unter Fedora funktioniert es wie folgt:

sudo dnf install fuse-libs         # FUSE-Bibliothek installieren
chmod +x Downloads/*.AppImage      # execute-Bit setzen
Downloads/LM-Studio-<n.n>.AppImage # LM Studio ausführen

Nach dnf install fuse-libs und chmod +x können Sie LM Studio per Doppelklick im Dateimanager starten.

Erste Schritte

Nach dem ersten Start fordert LM Studio Sie auf, ein KI-Modell herunterzuladen. Es macht gleich einen geeigneten Vorschlag. In der Folge laden Sie dieses Modell und können dann in einem Chat-Bereich Prompts eingeben. Die Eingabe und die Darstellung der Ergebnisse sieht ganz ähnlich wie bei populären Weboberflächen aus (also ChatGPT, Claude etc.).

Nachdem Sie sich vergewissert haben, dass LM Studio prinzipiell funktioniert, ist es an der Zeit, die Oberfläche genauer zu erkunden. Grundsätzlich können Sie zwischen drei Erscheinungsformen wählen, die sich an unterschiedliche Benutzergruppen wenden: User, Power User und Developer.

In den letzteren beiden Modi präsentiert sich die Benutzeroberfläche in all ihren Optionen. Es gibt
vier prinzipielle Ansichten, die durch vier Icons in der linken Seitenleiste geöffnet werden:

  • Chats
  • Developer (Logging-Ausgaben, Server-Betrieb)
  • My Models (Verwaltung der heruntergeladenen Sprachmodelle)
  • Discover (Suche und Download weiterer Modelle).

GPU Offload und Kontextlänge einstelln

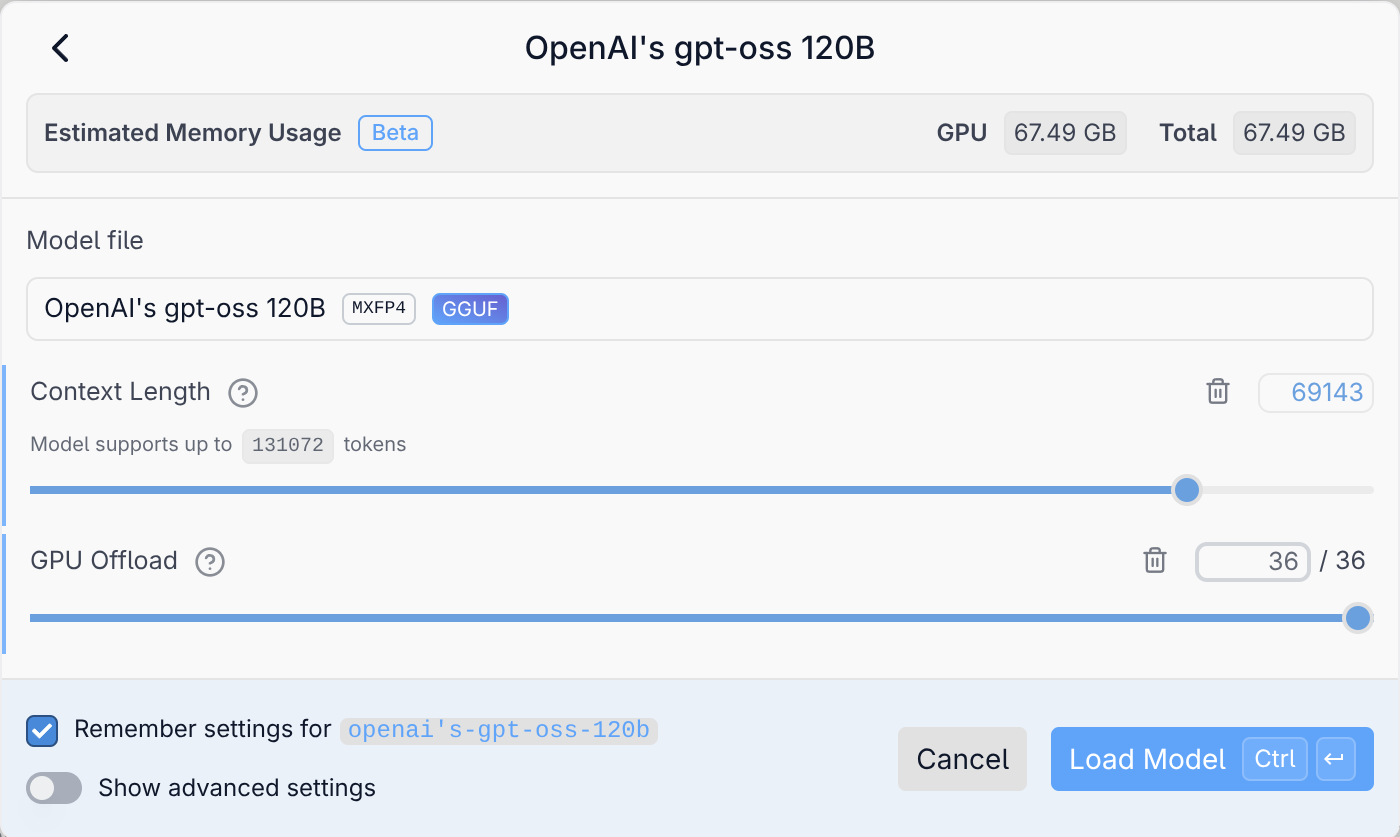
Sofern Sie mehrere Sprachmodelle heruntergeladen haben, wählen Sie das gewünschte Modell über ein Listenfeld oberhalb des Chatbereichs aus. Bevor der Ladevorgang beginnt, können Sie diverse Optionen einstellen (aktivieren Sie bei Bedarf Show advanced settings). Besonders wichtig sind die Parameter Context Length und GPU Offload.

Die Kontextlänge limitiert die Größe des Kontextspeichers. Bei vielen Modellen gilt hier ein viel zu niedriger Defaultwert von 4000 Token. Das spart Speicherplatz und erhöht die Geschwindigkeit des Modells. Für anspruchsvolle Coding-Aufgaben brauchen Sie aber einen viel größeren Kontext!

Der GPU Offload bestimmt, wie viele Ebenen (Layer) des Modells von der GPU verarbeitet werden sollen. Für die restlichen Ebenen ist die CPU zuständig, die diese Aufgabe aber wesentlich langsamer erledigt. Sofern die GPU über genug Speicher verfügt (VRAM oder Shared Memory), sollten Sie diesen Regler immer ganz nach rechts schieben! LM Studio ist nicht immer in der Lage, die Größe des Shared Memory korrekt abzuschätzen und wählt deswegen mitunter einen zu kleinen GPU Offload.

Der Screenshot zeigt die Grundeinstellungen beim Laden des Sprachmodells „OpenAI’s gpt-oss 120B“. Oben wird der geschätzte Speicherbedarf angezeigt, mit GPU- und Gesamtbedarf von 67,49 GB. Im Bereich „Model file“ sind die Formate MXFP4 und GGUF markiert. Darunter lassen sich Context Length (bis 131072 Tokens, aktuell 69143) und GPU Offload (36/36) per Schieberegler einstellen. Unten sind Optionen zum Merken der Einstellungen sowie der Button „Load Model“.
Grundeinstellungen beim Laden eines Sprachmodells
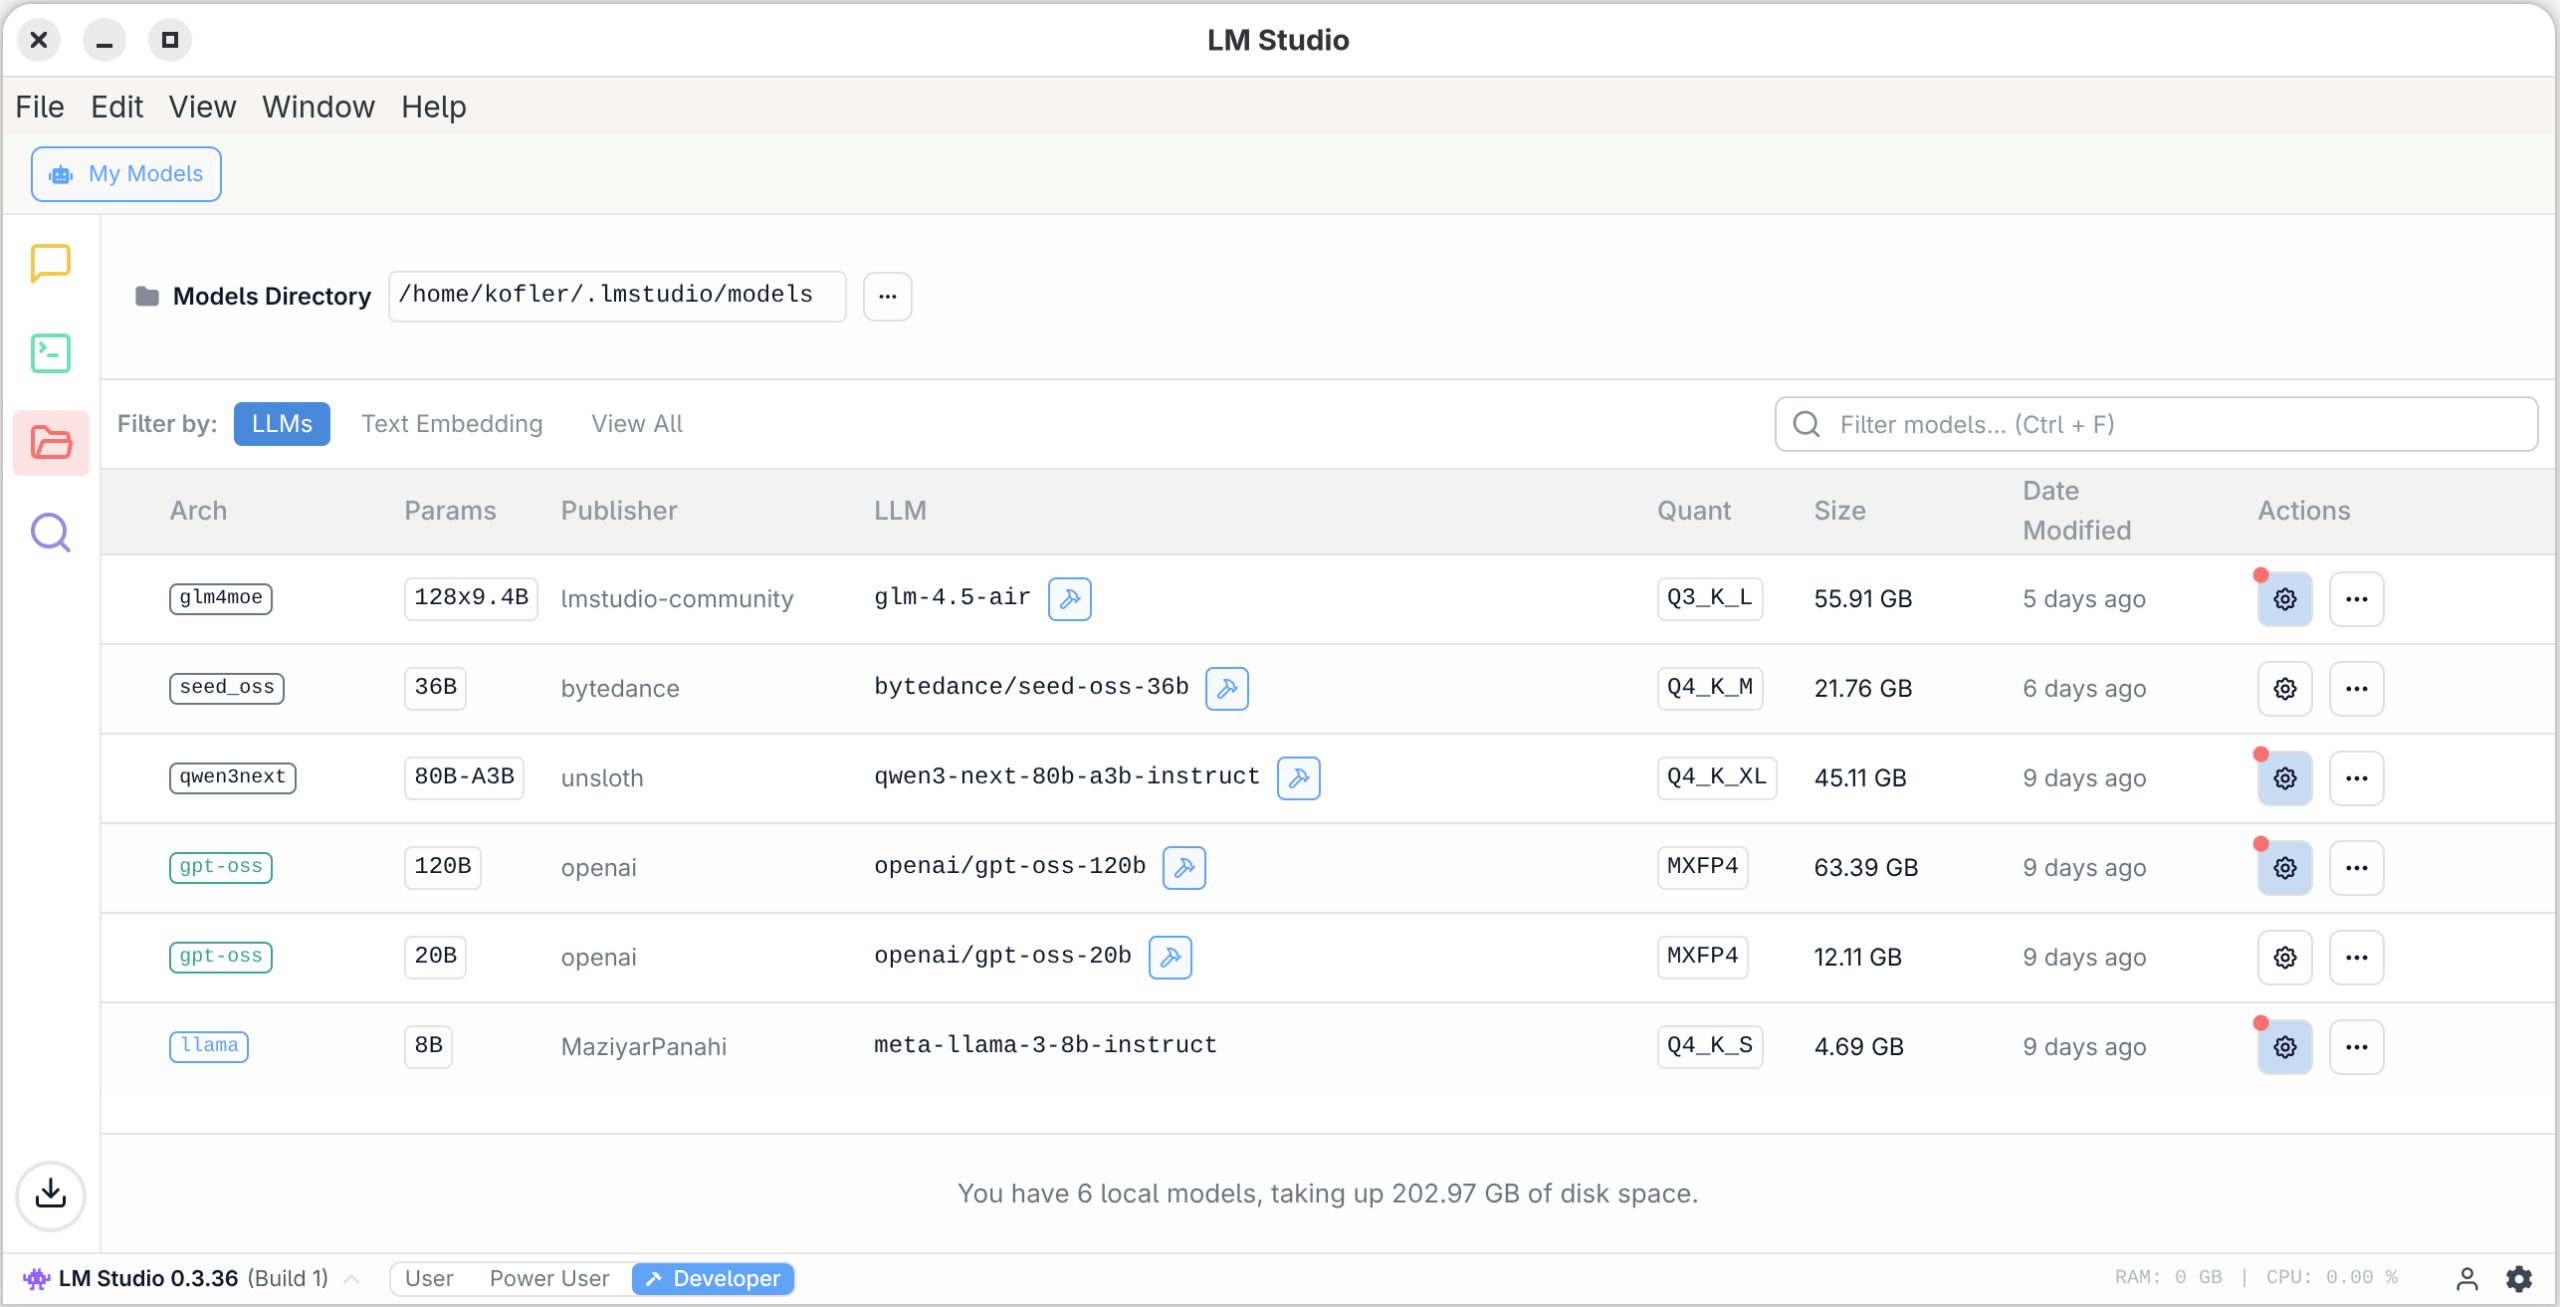
Der Screenshot zeigt die „My Models“-Ansicht in LM Studio mit einer Liste lokal installierter Sprachmodelle. Oben ist das Models-Verzeichnis „/home/kofler/.lmstudio/models“ sowie ein Suchfeld zum Filtern zu sehen. In der Tabelle werden Architektur, Parameter, Publisher, Modellname, Quantisierung, Größe und Änderungsdatum angezeigt, inklusive Action-Buttons pro Eintrag. Unten steht, dass 6 lokale Modelle insgesamt 202,97 GB belegen.
Überblick über die heruntergeladenen Sprachmodelle

Debugging und Server-Betrieb

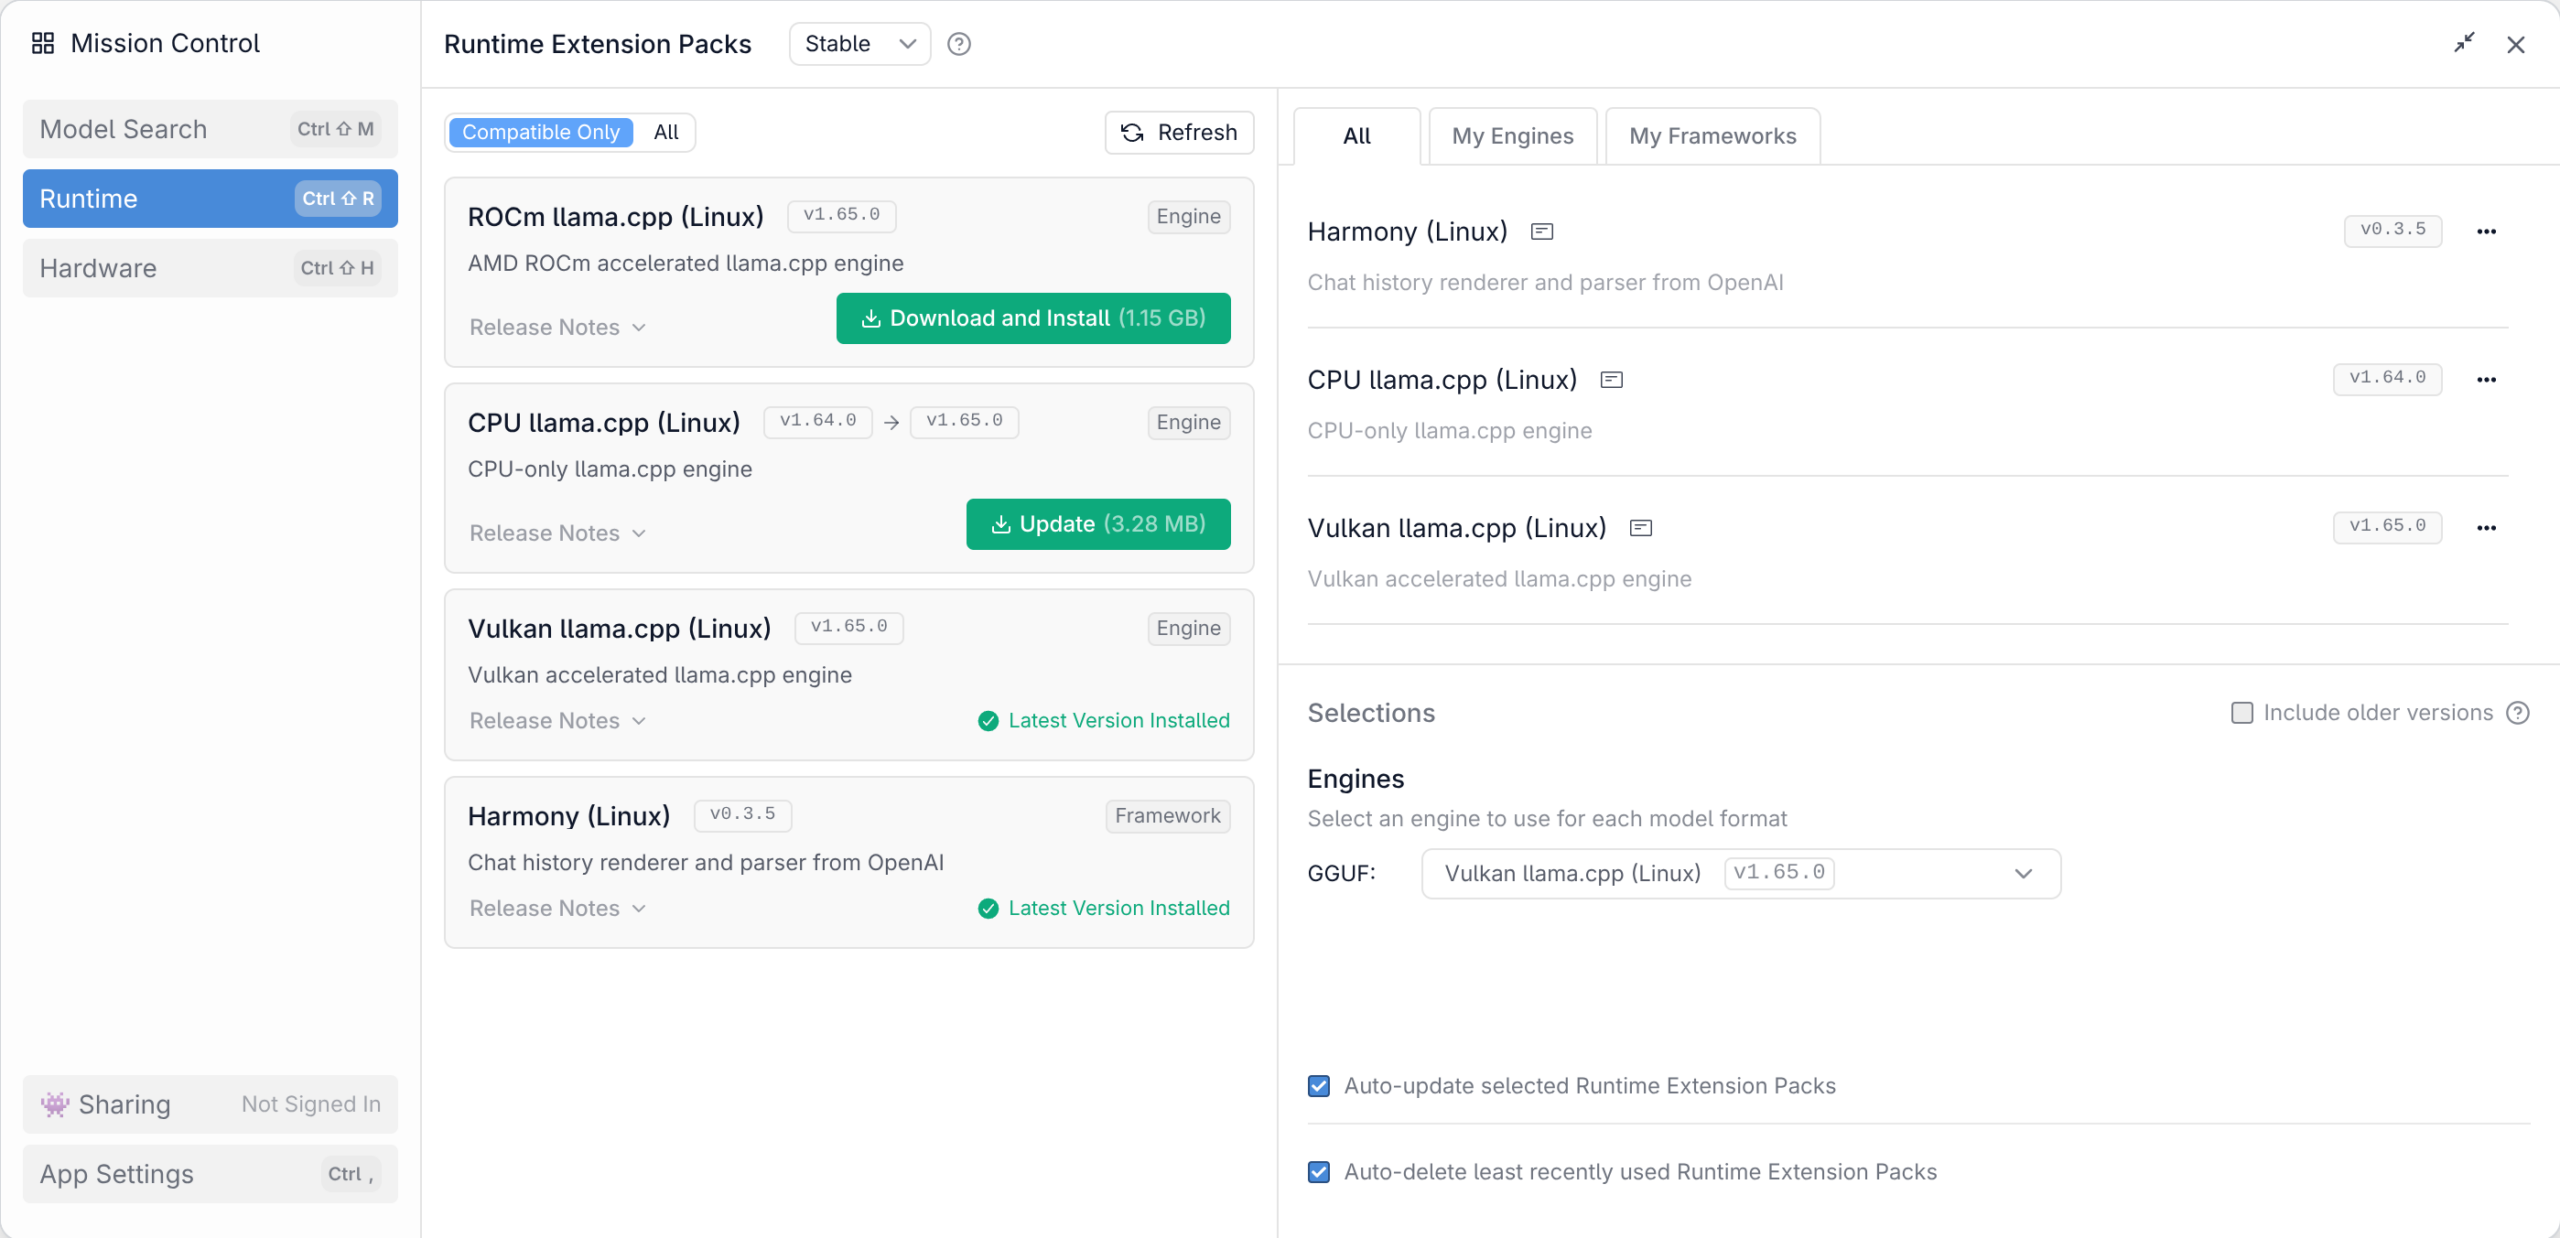
In der Ansicht Developer können Sie Logging-Ausgaben lesen. LM Studio verwendet wie Ollama und die meisten anderen KI-Oberflächen das Programm llama.cpp zur Ausführung der lokalen Modelle. Allerdings gibt es von diesem Programm unterschiedliche Versionen für den CPU-Betrieb (langsam) sowie für diverse GPU-Bibliotheken.

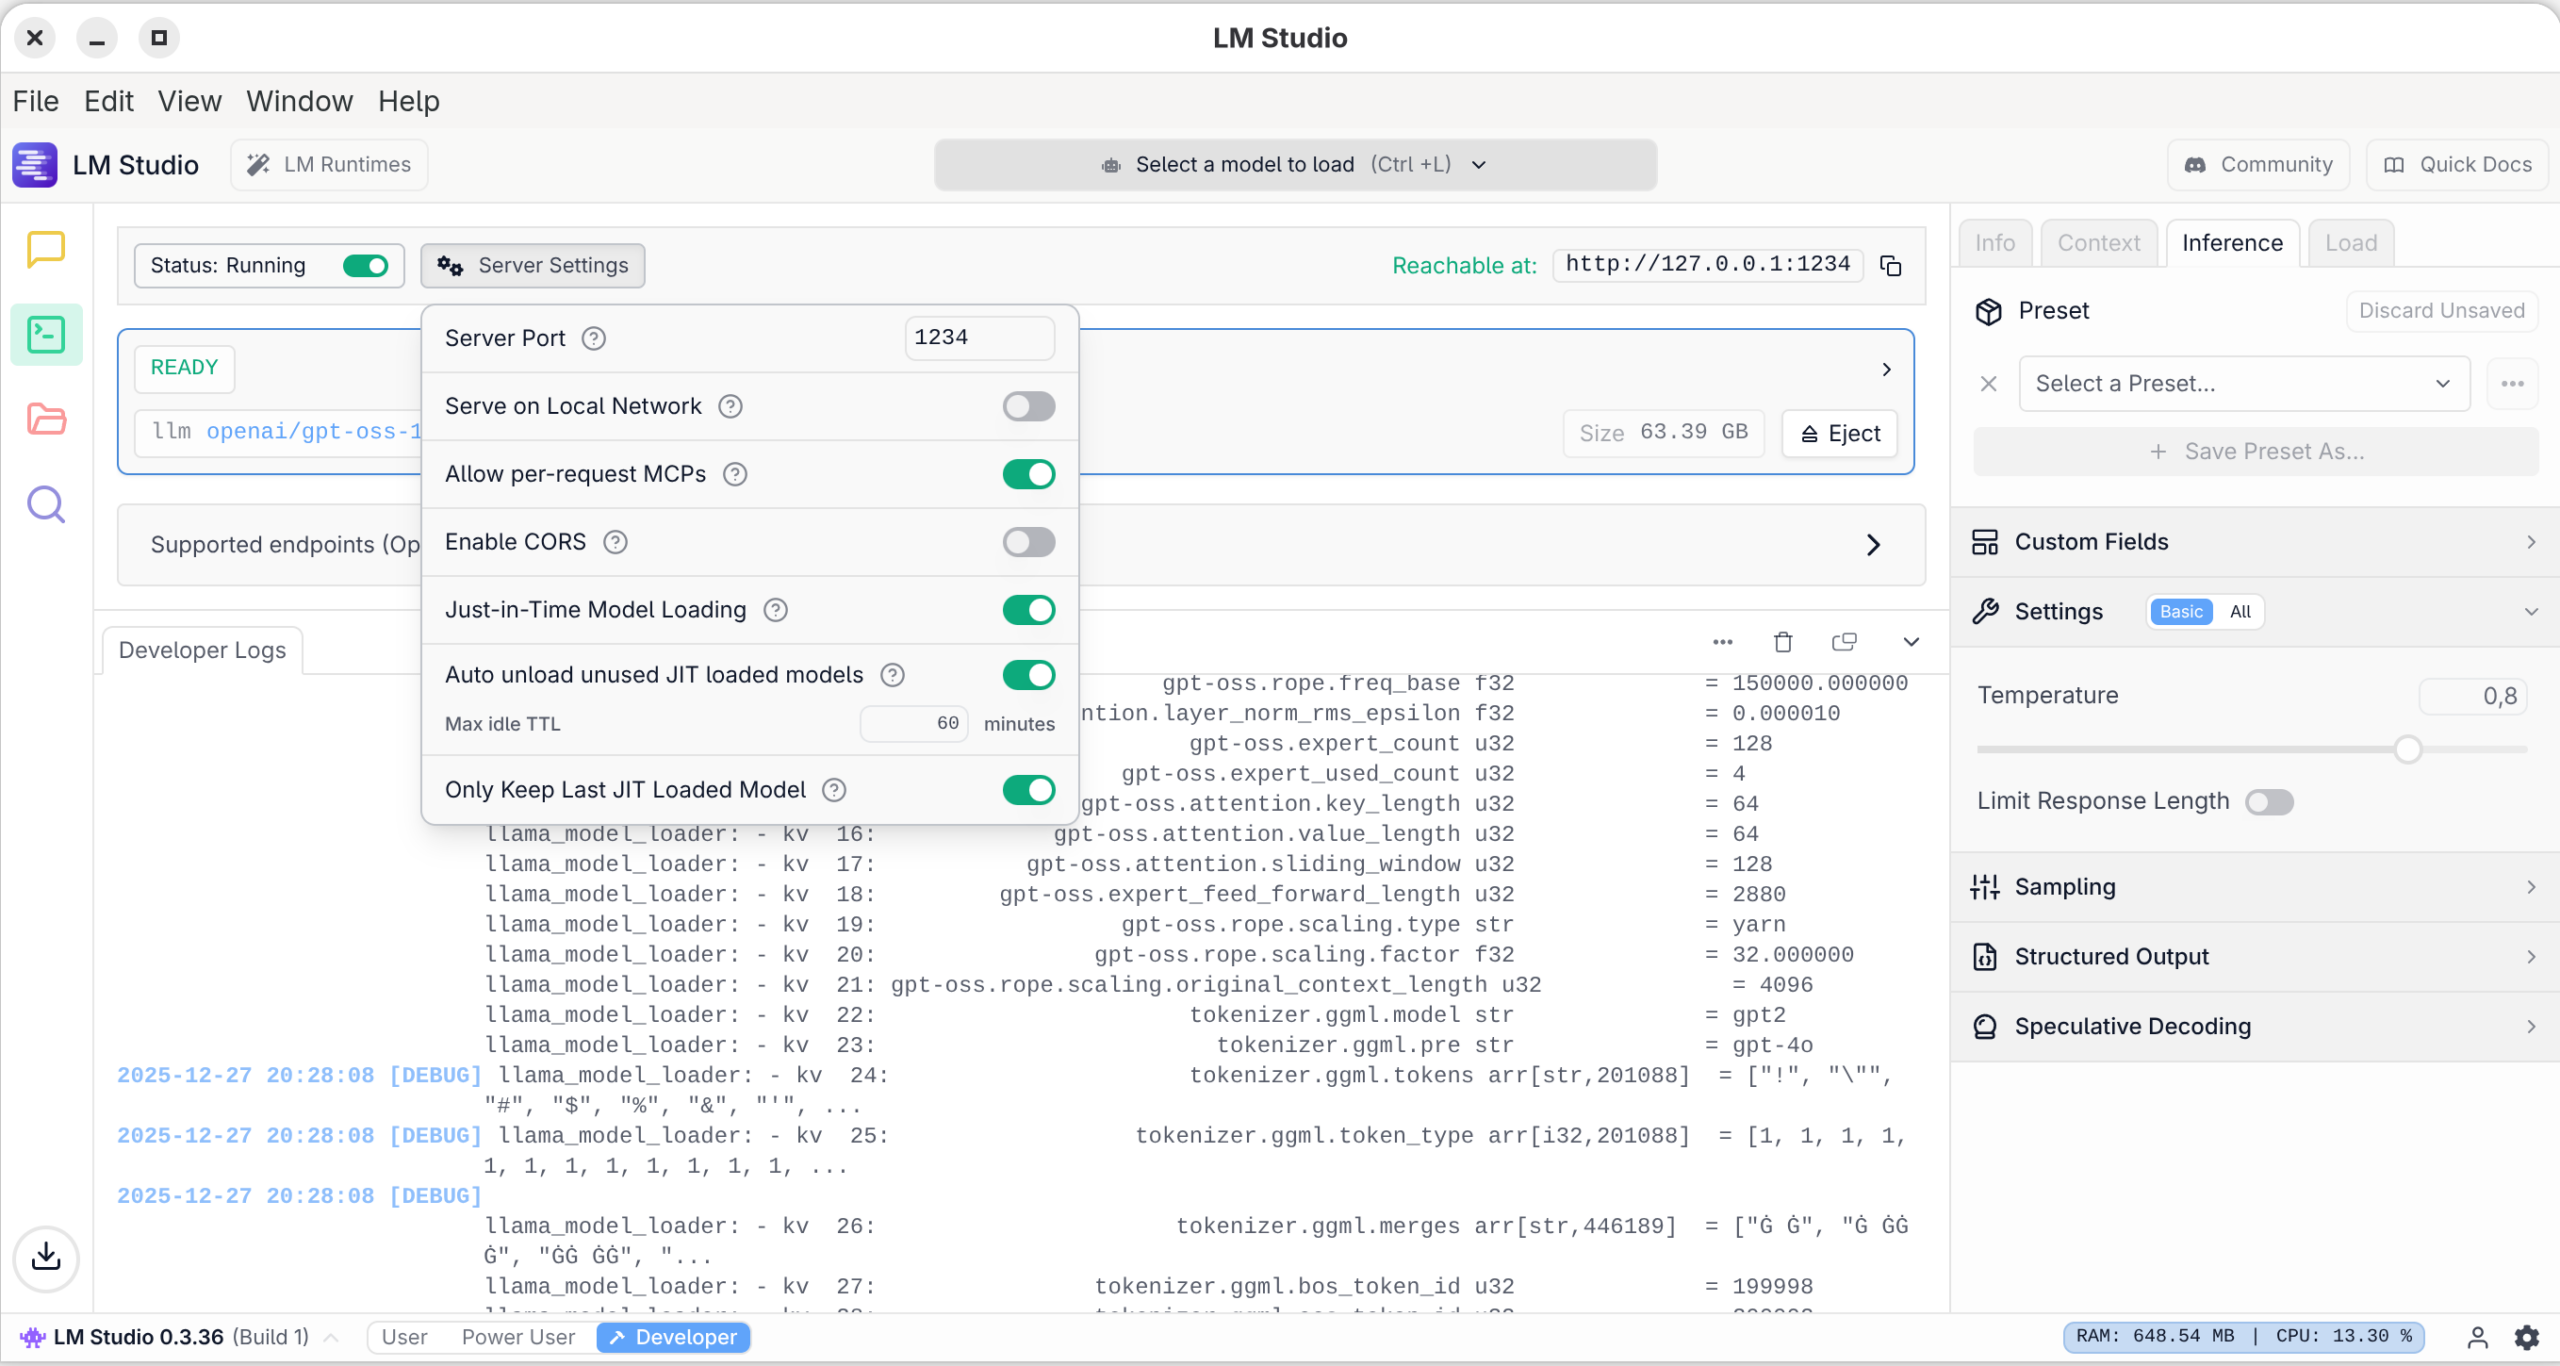
In dieser Ansicht können Sie den in LM Studio integrierten REST-Server aktivieren. Damit können Sie z.B. mit eigenen Python-Programmen oder mit dem VS-Code-Plugin Continue Prompts an LM Studio senden und dessen Antwort verarbeiten. Standardmäßig kommt dabei der Port 1234 um Einsatz, wobei der Zugriff auf den lokalen Rechner limitiert ist. In den Server Settings können Sie davon abweichende Einstellungen vornehmen.

Der Screenshot zeigt LM Studio im Developer-Modus mit geöffnetem Dialog „Server Settings“. Links ist der Status „Running“ zu sehen und oben die lokale URL „http://127.0.0.1:1234“, unter der der Server erreichbar ist. Im Einstellungsfenster werden Optionen wie Server-Port, CORS, Local Network sowie Just-in-Time-Model-Loading und Auto-Unload per Schalter konfiguriert. Im Hintergrund laufen Developer-Logs mit Modell- und Tokenizer-Parametern.
Logging-Ausgaben und Server-Optionen
Der Screenshot zeigt das LM‑Studio-Menü „Mission Control“ mit den „Runtime Extension Packs“ unter Linux. Links ist „Runtime“ ausgewählt, in der Mitte werden ROCm-, CPU- und Vulkan‑„llama.cpp“-Engines samt Versionsständen gelistet. Für ROCm gibt es einen „Download and Install“-Button, für CPU ein Update. Rechts sind installierte Pakete und die GGUF‑Engine-Auswahl (Vulkan llama.cpp) sowie Auto‑Update-Optionen sichtbar.
Hinter den Kulissen greift LM Studio auf »llama.cpp« zurück

Praktische Erfahrungen am Framework Desktop

Auf meinem neuen Framework Desktop mit 128 GiB RAM habe ich nun diverse Modelle ausprobiert. Die folgende Tabelle zeigt die erzielte Output-Geschwindigkeit in Token/s. Beachten Sie, dass die Geschwindigkeit spürbar sinkt wenn viel Kontext im Spiel ist (größere Code-Dateien, längerer Chat-Verlauf).

Sprachmodell                  MoE        Parameter    Quant.      Token/s
-------------                 -----     ----------   ---------   --------
deepseek-r1-distill-qwen-14b  nein         14 Mrd.    Q4_K_S           22
devstral-small-2-2512         nein         25 Mrd.    Q4_K_M           13
glm-4.5-air                   ja          110 Mrd.    Q3_K_L           25
gpt-oss-20b                   ja           20 Mrd.    MXFP4            65
gpt-oss-120b                  ja          120 Mrd.    MXFP4            48
nouscoder-14b                 nein         14 Mrd.    Q4_K_S           22
qwen3-30b-a3b                 ja           30 Mrd.    Q4_K_M           70
qwen3-next-80b-83b            ja           80 Mrd.    Q4_K_XL          40
seed-oss-36b                  nein         36 Mrd.    Q4_K_M           10

Normalerweise gilt: je größer das Sprachmodell, desto besser die Qualität, aber desto kleiner die Geschwindigkeit. Ein neuer Ansatz durchbricht dieses Muster. Bei Mixture of Expert-Modellen (MoE-LLMs) gibt es Parameterblöcke für bestimmte Aufgaben. Bei der Berechnung der Ergebnis-Token entscheidet das Modell, welche »Experten« für den jeweiligen Denkschritt am besten geeignet sind, und berücksichtigt nur deren Parameter.

Ein populäres Beispiel ist das freie Modell GPT-OSS-120B. Es umfasst 117 Milliarden Parameter, die in 36 Ebenen (Layer) zu je 128 Experten organisiert sind. Bei der Berechnung jedes Output Tokens sind in jeder Ebene immer nur vier Experten aktiv. Laut der Modelldokumentation sind bei der Token Generation immer nur maximal 5,1 Milliarden Parameter aktiv. Das beschleunigt die Token Generation um mehr als das zwanzigfache:

Welches ist nun das beste Modell? Auf meinem Rechner habe ich mit dem gerade erwähnten Modell GPT-OSS-120B sehr gute Erfahrungen gemacht. Für Coding-Aufgaben funktionieren auch qwen3-next-80b-83b und glm-4.5-air gut, wobei letzteres für den praktischen Einsatz schon ziemlich langsam ist.

Rechtschreibkontrolle deaktivieren

Zu den größten Ärgernissen der LM-Studio-Oberfläche (intern realisiert auf Basis des Electron-Frameworks) zählt die stets aktive Rechtschreibkontrolle in allen Eingabefeldern. In den Einstellungsdialogen gibt es gefühlt eine Million Optionen, aber keine, um die Rechtschreibkontrolle zu deaktivieren :-( Wenn jetzt die Desktop-Sprache (deutsch) und die Sprache Ihrer Prompts (englisch) nicht übereinstimmt, wird praktisch der gesamte Text rot unterstrichen. Mühsam.

Abhilfe: Suchen Sie nach der Konfigurationsdatei, die unter Linux den Namen .config/LM Studio/Preferences hat. Dort löschen Sie alle vordefinierten dictionary-Zeichenketten für die Einstellung spellcheck. In meinem Fall sieht die neue Datei dann so aus:

{"migrated_user_scripts_toggle":true,
 "spellcheck":{"dictionaries":[""],"dictionary":""}}

Tipps zur Suche der Konfigurationsdatei bei anderen Betriebssystemen finden Sie in diesem Issue.

Quellen/Links

  •  
❌