Normale Ansicht

Einfacher Ollama-Speed-Benchmark

07. Mai 2024 um 16:45

Die Geschwindigkeit bei der lokalen Ausführung großer Sprachmodelle (LLMs) wird in Zukunft zu einem entscheidenden Kriterium für die CPU/GPU-Auswahl werden. Das gilt insbesondere für Software-Entwickler, die LLMs lokal nutzen möchten anstatt alle Daten an Anbieter wie ChatGPT in die Cloud zu übertragen.

Umso verblüffender ist es, dass es dafür aktuell kaum brauchbare Benchmarks gibt. In Anknüpfung an meinen Artikel Sprachmodelle lokal ausführen und mit Hilfe des Forum-Feedbacks habe ich die folgende Abbildung zusammengestellt.
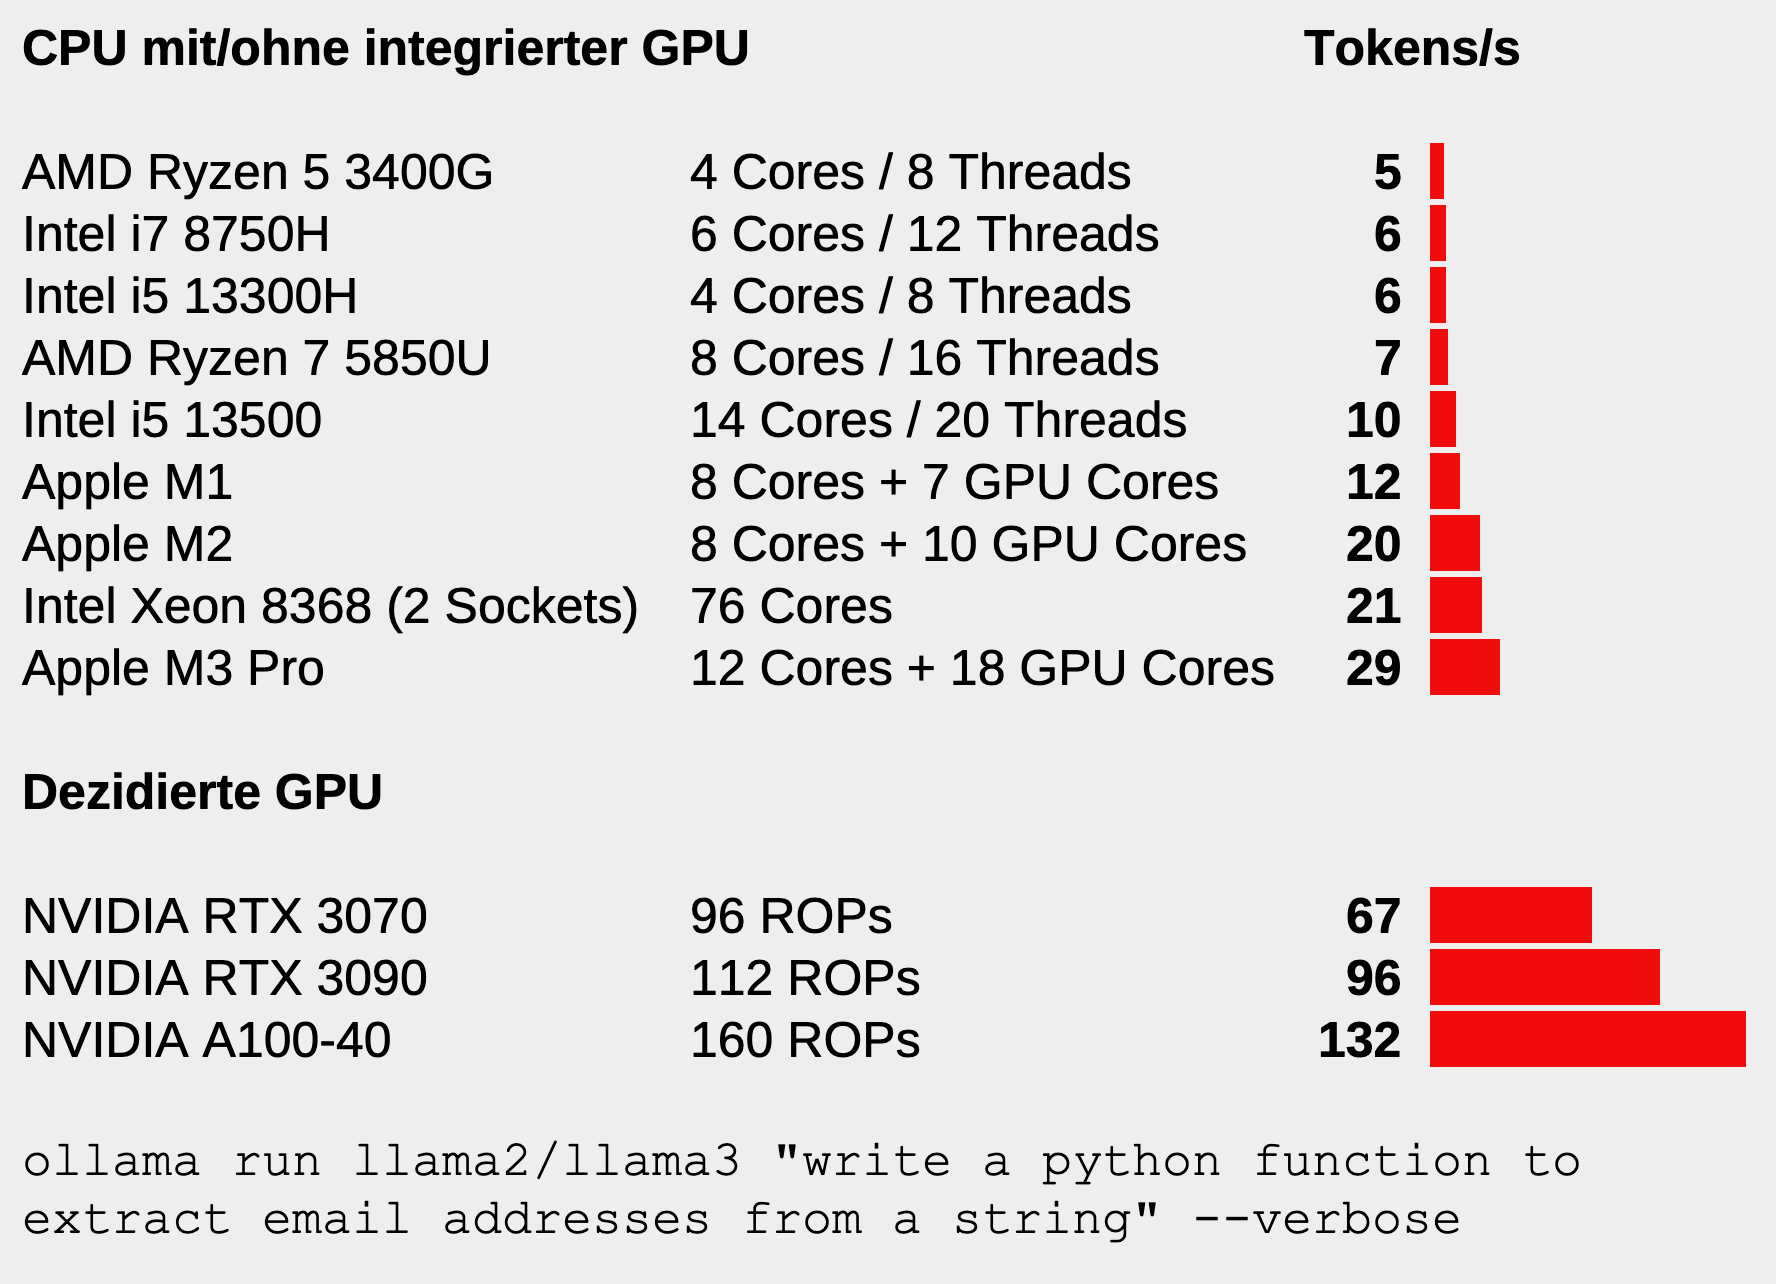
Textproduktion in Tokens/s bei der lokalen Ausführung von llama2 bzw. llama3

Die Geschwindigkeit in Token/s wird — zugegeben unwissenschaftlich — mit der Ausführung des folgenden Kommandos ermittelt:

ollama run  llama2 "write a python function to extract email addresses from a string" --verbose

oder

ollama run  llama3 "write a python function to extract email addresses from a string" --verbose

Bei den Tests ist llama3 um ca. 10 Prozent langsamer als llama2, liefert also etwas weniger Token/s. Möglicherweise liegt dies ganz einfach daran, dass das Sprachmodell llama3 in der Standardausführung etwas größer ist als llama2 (7 versus 8 Mrd. Parameter). Aber an der Größenordnung der Ergebnisse ändert das wenig, die Werte sind noch vergleichbar.

Beachten Sie, dass die im Diagramm angegebenen Werte variieren können, je nach installierten Treiber, Stromversorgung, Kühlung (speziell bei Notebooks) etc.

Helfen Sie mit! Wenn Sie Ollama lokal installiert haben, posten Sie bitte Ihre Ergebnisse zusammen mit den Hardware-Eckdaten im Forum. Verwenden Sie als Sprachmodell llama2 bzw. llama3 in der Defaultgröße (also mit 7 bzw. 8 Mrd. Parameter, entspricht llama2:7b oder llama3:8b). Das Sprachmodell ist dann ca. 4 bzw. 5 GByte groß, d.h. die Speicheranforderungen sind gering. (Falls Sie das LLM mit einer dezidierten GPU ausführen, muss diese einen ausreichend großen Speicher haben, in dem das ganze Sprachmodell Platz findet. Je nach Betriebssystem sind u.U. zusätzliche Treiber notwendig, damit die GPU überhaupt genutzt wird.)

Ich werde das Diagramm gelegentlich mit neuen Daten aktualisieren.

Stable Diffusion auf Ubuntu /Linux Mint – KI-Bilder offline erstellen

Von: jdo
20. April 2024 um 07:19

Du willst KI-Bilder offline und ohne Abo auf Deinem eigenen Rechner erstellen? Dann brauchst Du nur zwei Dinge: einen PC mit einer halbwegs aktuellen Grafikkarte (ab etwa 6 bis 8 GByte VRAM, ideal NVIDIA) und eine kostenlose Software wie Stable Diffusion samt Oberfläche. Das Ganze kostet Dich keinen Cent – nur etwas Zeit und Speicherplatz. Mit GPT4All gibt es bereits einen Chatbot wie ChatGPT, den Du auf Deinem Computer installieren und offline benutzen kannst. Möchtest Du offline Bilder mithilfe einer […]

Der Beitrag Stable Diffusion auf Ubuntu /Linux Mint – KI-Bilder offline erstellen ist von bitblokes.de.

Nextcloud veröffentlicht großes Update für KI-Assistant – 2.0

Von: jdo
04. April 2024 um 05:23

Das Team von Nextcloud hat ein großes Update für den Nextcloud KI-Assistenten zur Verfügung gestellt. Ab sofort gibt es Context Chat und Context Write. Zudem ist GPU-Beschleunigung möglich und der Nextcloud-Server lässt sich vom KI-Server abspalten. Ferner arbeitet das Nextcloud-Team mit mehreren bekannten europäischen Hosting-Unternehmen zusammen, darunter IONOS und OVHcloud, um KI-as-a-Service-Lösungen anzubieten, die Privatsphäre und digitale Souveränität respektieren. In diesem Fall benötigst Du selbst keine teuren GPUs, um KI und Nextcloud zu vereinen. Nextcloud Assistant 2.0 Die Oberfläche wurde […]

Der Beitrag Nextcloud veröffentlicht großes Update für KI-Assistant – 2.0 ist von bitblokes.de.

Nextcloud 29 wird viel mehr KI-Optionen zur Verfügung stellen

Von: jdo
22. März 2024 um 07:09

Ich habe bei meiner Nextcloud-Testinstanz die Beta-Version von Nextcloud 29 installiert und war etwas neugierig. Insbesondere die Optionen für KI haben mich interessiert. Bei der letzten Version wurden Möglichkeiten erwähnt, Bilder via KI erstellen zu lassen und so weiter. Allerdings habe ich keine Möglichkeiten gefunden, die erwähnten Funktionen einfach zu nutzen. Mit Nextcloud 29 scheint die Sache nun ein Gesicht zu bekommen. Werfen wir zunächst einen Blick darauf, wie der Nextcloud-Assistent in Version 28 aussieht. Betreibst Du selbst eine NC, […]

Der Beitrag Nextcloud 29 wird viel mehr KI-Optionen zur Verfügung stellen ist von bitblokes.de.

digiKam 8.3 – Tags mit KI automatisch hinzufügen

Von: jdo
16. März 2024 um 06:39

Ab sofort kannst Du die Open-Source-Fotoverwaltungs-Software digiKam 8.3 herunterladen. Es gibt 250 Bugfixes, aber auch interessante Neuerungen. Es gibt etwa ein Tool, womit Du Fotos und Bildern automatisch Tags zuweisen kannst. Dafür wird ein neuronales Netzwerk für Deep Learning benutzt. Du findest hier genaue Details zu dieser Funktion. Du findest die Funktion unter Extras > Wartung > Auto tags. Die Funktion mit dem automatischen Zuordnen von Tags ist auch im QueueManager verfügbar. Ebenso gibt es im QueueManager ein neues Tool, […]

Der Beitrag digiKam 8.3 – Tags mit KI automatisch hinzufügen ist von bitblokes.de.

❌