Manchmal braucht es eine reißerische Überschrift, um das eigene Versagen zu übertünchen. Was war passiert? Wie in Ubuntu-Server-Update von 24.04 auf 26.04 beschrieben, habe ich vor ein paar Tagen einen Ubuntu-Server auf Version 26.04 aktualisiert. Dort lief (und läuft weiterhin) unter anderem Nextcloud.
Was ich bei meinem Upgrade übersehen hatte: Ich hatte meine Nextcloud-Installation in den vergangenen 18 Monaten sträflich vernachlässigt. Alles funktionierte, an Updates hatte ich nicht gedacht. Genau das ist mir mit dem Ubuntu-Upgrade auf die Füße gefallen. Meine Nextcloud-Clients konnten keine Verbindung mehr herstellen. Die Webseite zeigte kurz und bündig:
This version of Nextcloud is not compatible with PHP>=8.5.
You are currently running 8.5.4
Ein kurzer Test ergab, dass Nextcloud 31 installiert war. Die erste Version, die PHP 8.5 unterstützt, ist aber Nextcloud 33. Aktuell wäre gar Nextcloud 35 …
Das klingt nach einem trivialen Problem, aber das täuscht: Für den Upgrade-Prozess ist ein PHP-Script zuständig, und dieses verweigert mit meiner neuen PHP-Version die Ausführung. Außerdem muss Nextcloud immer Version für Version aktualisiert werden. Eine direkte Abkürzung von Version 31 zu 35 ist nicht zulässig.
In der Vergangenheit hatte ich schon mehrfach das Problem, dass ich Nextcloud nicht aktualisieren konnte, weil PHP zu alt war. Auf die Idee, dass es auch den umgekehrten Fall geben könnte (PHP zu neu), bin ich nicht gekommen.
Docker ist die Lösung
Ich brauchte also auf meinem frisch aktualisierten Server eine alte PHP-Version. Dafür gibt es (inoffizielle) Repositories, aber die wollte ich nicht verwenden. PHP 8.3 oder 8.4 sollte ja nur für ein paar Minuten ein Script ausführen. Zu Hilfe kam mir einerseits Docker, das auf dem Server sowieso installiert ist, und andererseits Claude Code, von dem ich mir mit dem folgenden Prompt eine detaillierte Anleitung erstellen ließ.
/var/www/html/nextcloud contains Nextcloud 31.0.4. My problem: I upgraded to PHP 8.5, but Nextcloud 31 is incompatible with this PHP version. I need to upgrade to Nextcloud version 33 (first PHP 8.5 compatible version), keeping all data. Docker is available to run an older PHP version. Line out an upgrade plan.
Die Grundidee besteht darin, mit einem Dockerfile ein Image mit PHP 8.3 zur Ausführung des Upgrades zu erstellen:
# Dockerfile
FROM php:8.3-cli
ADD https://github.com/mlocati/docker-php-extension-installer/releases/latest/download/install-php-extensions /usr/local/bin/
RUN chmod +x /usr/local/bin/install-php-extensions \
 && install-php-extensions pdo_mysql gd intl zip bcmath gmp apcu exif opcache pcntl sysvsem imagick
RUN printf "memory_limit=2G\napc.enable_cli=1\n" > /usr/local/etc/php/conf.d/nc.ini
Das Image wird im Verzeichnis mit dem Dockerfile mit dem folgenden Kommando erzeugt:
sudo docker build -t nc-php83 .
Auf der Basis dieses Images kann das Nextcloud-Kommando occ mit dem folgenden Script nc-occ ausgeführt werden:
Das Script bindet in den temporären Container das Nextcloud-Verzeichnis unter demselben Pfad wie auf dem Host ein, damit die absoluten Pfade in der config.php weiter stimmen. Es läuft mit der UID von www-data, damit die Dateirechte passen, und nutzt --network host, damit die lokale Datenbank erreichbar ist. Code, Konfiguration und Daten bleiben also auf dem Host, und im Container läuft nur php occ.
Die größte Hürde war die Datenbankverbindung. Der erste Test mit nc-occ status scheiterte mit SQLSTATE[HY000] [2002] No such file or directory. Die Ursache: Das Debian-PHP sucht den MySQL-Socket standardmäßig unter /var/run/mysqld/mysqld.sock, das offizielle Docker-Image tut das nicht. Es reicht deshalb nicht, den Socket-Ordner per -v /var/run/mysqld:/var/run/mysqld einzubinden, man muss PHP den Pfad auch mit -d pdo_mysql.default_socket=/var/run/mysqld/mysqld.sock mitteilen.
Der weitere Ablauf ist in der schon erwähnten Anleitung detailliert ausgeführt. Selbstredend habe ich vorher ein Backup meiner Daten gemacht (also das Verzeichnis /var/www/html/nextcloud/data sowie die MySQL-Datenbank).
Danach habe ich diese Anleitung Schritt für Schritt abgearbeitet. Theoretisch wäre es auch denkbar, diese Aufgabe agentisch an Claude Code zu delegieren; dazu hätte ich Claude Code aber root-Rechte geben müssen. So mutig war ich dann doch nicht.
Später habe ich Nextcloud in der Web-UI weiter auf die Versionen 34 und 35 aktualisiert. Zum Schluss habe ich aufgeräumt, also insbesondere /var/www/html/nextcloud/data/updater-xxx/* sowie das Docker-Imgage für PHP 8.3 gelöscht.
Linus Torvalds sieht eine positive Konsolidierung bei den zunehmenden KI-Einreichungen zum Kernel. Die Verantwortung verbleibt jedoch bei den Maintainern und Entwicklern.
Nachdem bereits OpenAI und Anthropic Einschränkungen bei der Nutzung ihrer KI-Agenten eingeführt haben, begrenzt nun offenbar auch SpaceX die Nutzung seines Agenten Grok Bot.
Vor ein paar Wochen habe ich hier beschrieben, wie ich das Sprachmodell Qwen 3.8 Flash Next auf einem Rechner mit Strix-Halo-CPU und 128 GB RAM ausführe. Dort habe ich auch angekündigt, den Coding-Agenten Pi vorzustellen, mit dem ich das lokale Modell getestet habe: Pi ist so ziemlich das Gegenteil von Claude Code — minimalistisch, sparsam mit dem Kontext und gerade deswegen ideal für lokal ausgeführte Sprachmodelle.
Das Problem: Claude Code und lokale Modelle
Claude Code ist für mich aktuell das beste CLI-Coding-Tool. Das gilt aber nicht für das Zusammenspiel mit lokalen Modellen. Zwar lässt sich Claude Code über die Umgebungsvariable ANTHROPIC_BASE_URL mit LM Studio, llama.cpp & Co. verbinden, aber die Ergebnisse sind ernüchternd: Schon für einen Miniprompt wie »Can we talk?« vergehen je nach Modell Minuten, bis die erste Antwort erscheint.
Eine Ursache dafür ist das sogenannte Context Bloating. Claude Code schickt bei jedem Prompt einen riesigen Basiskontext mit. Wenn Sie in einer leeren Session nach »Can we talk?« das Kommando /context ausführen, zeigt Claude Code eine Kontextnutzung von 50k bis 60k Token an:
Der Systemprompt beansprucht ca. 10k Token. Das ist eine Grundanleitung, wie Claude Code agieren soll.
Ungefähr weitere 30k Token ergeben sich aus der Anleitung, wie der Agent Tools wie Bash, Edit, Read oder Write aufrufen soll.
Der Rest stammt von Skills, Plugins, MCP-Servern usw.
Bei den Anthropic-Modellen mit einem Kontextfenster von einer Million Token ist das (fast) vernachlässigbar. Ein lokales Modell mit einem Kontextfenster von 260.000 Token ist aber schon zu 20 bis 25 Prozent gefüllt, bevor Sie überhaupt etwas Sinnvolles gefragt haben. Und all diese Token müssen von Ihrer lokalen Hardware verarbeitet werden, die nun mal nicht mit Cloud-Rechenzentren mithalten kann. Manche Kritiker sprechen bei Claude Code deswegen nicht nur von Context, sondern auch von Feature Bloating.
Die Idee hinter Pi
Hinter Pi steckt Mario Zechner: Der Österreicher hat unter anderem das Game-Framework libGDX entwickelt. Als ihm Claude Code zu komplex und zu geschwätzig wurde, hat er kurzerhand einen eigenen Agenten geschrieben. Der Code steht unter der MIT-Lizenz und wird mittlerweile von der Organisation Earendil weiterentwickelt. Seit 1.10.2026 gibt es die Version 1.0, aktuell (Anfang November 2026) ist schon Version 1.5.
Die Grundidee lässt sich schnell zusammenfassen: Moderne Sprachmodelle wissen ohnehin schon, wie man eine Shell bedient, wie ein Git-Repository funktioniert und wie man eine Datei bearbeitet. Vieles von dem, was ein Systemprompt, AGENTS.md, Skills usw. hinzufügen, kostet zuerst einmal Token und lenkt ab. (Das sagen übrigens nicht nur die Pi-Entwickler, das sagt interessanterweise — wenn auch in einem etwas anderen Zusammenhang — sogar Anthropic!)
Pi aktiviert deswegen standardmäßig nur vier Tools: read, write, edit und bash. Es gibt kein eigenes Tool für die Volltextsuche, keines für Webzugriffe. Wer suchen will, ruft über bash einfach grep oder rg auf. Der komplette Systemprompt inklusive aller Tool-Definitionen beträgt nur gut 1.000 Token. Das ist ein Fünfzigstel von dem, was Claude Code mindestens braucht! Bei einem lokalen Modell mit 130.000 oder 260.000 Token ist das der Unterschied zwischen »unbrauchbar langsam« und »funktioniert«.
Der Preis für diese Sparsamkeit sind weniger Funktionen, weniger Komfort im Terminal und weniger Tools. Pi ist aber erweiterbar (dazu gleich mehr). Erfreulich für Umsteiger: Pi liest beim Start AGENTS.md und ersatzweise CLAUDE.md, und zwar global, aus allen übergeordneten Verzeichnissen sowie aus dem aktuellen Verzeichnis.
Installation
Pi setzt Node.js (Version 22.19 oder neuer) voraus. Zur Installation verwenden Sie am einfachsten das Installations-Script oder npm (hier zur Referenz die Originalanleitung).
$ curl -fsSL https://pi.dev/install.sh | sh                  # Linux, macOS
> powershell -c "irm https://pi.dev/install.ps1 | iex"       # Windows
$ npm i -g --ignore-scripts @earendil-works/pi-coding-agent  # Node.js
Das Installations-Script hat den Vorteil, dass es alle Abhängigkeiten auf exakte Versionen fixiert; Updates führen Sie dann mit pi update durch. Weitere Installationsvarianten beschreibt https://pi.dev.
Anschließend starten Sie den Agenten im Projektverzeichnis mit pi und melden sich mit /login bei einem der über 40 unterstützten Anbieter an. Neben Anthropic, OpenAI und Google funktionieren auch OpenRouter, DeepSeek oder Groq. Bei OpenAI können Sie sogar ein ChatGPT-Abo verwenden.
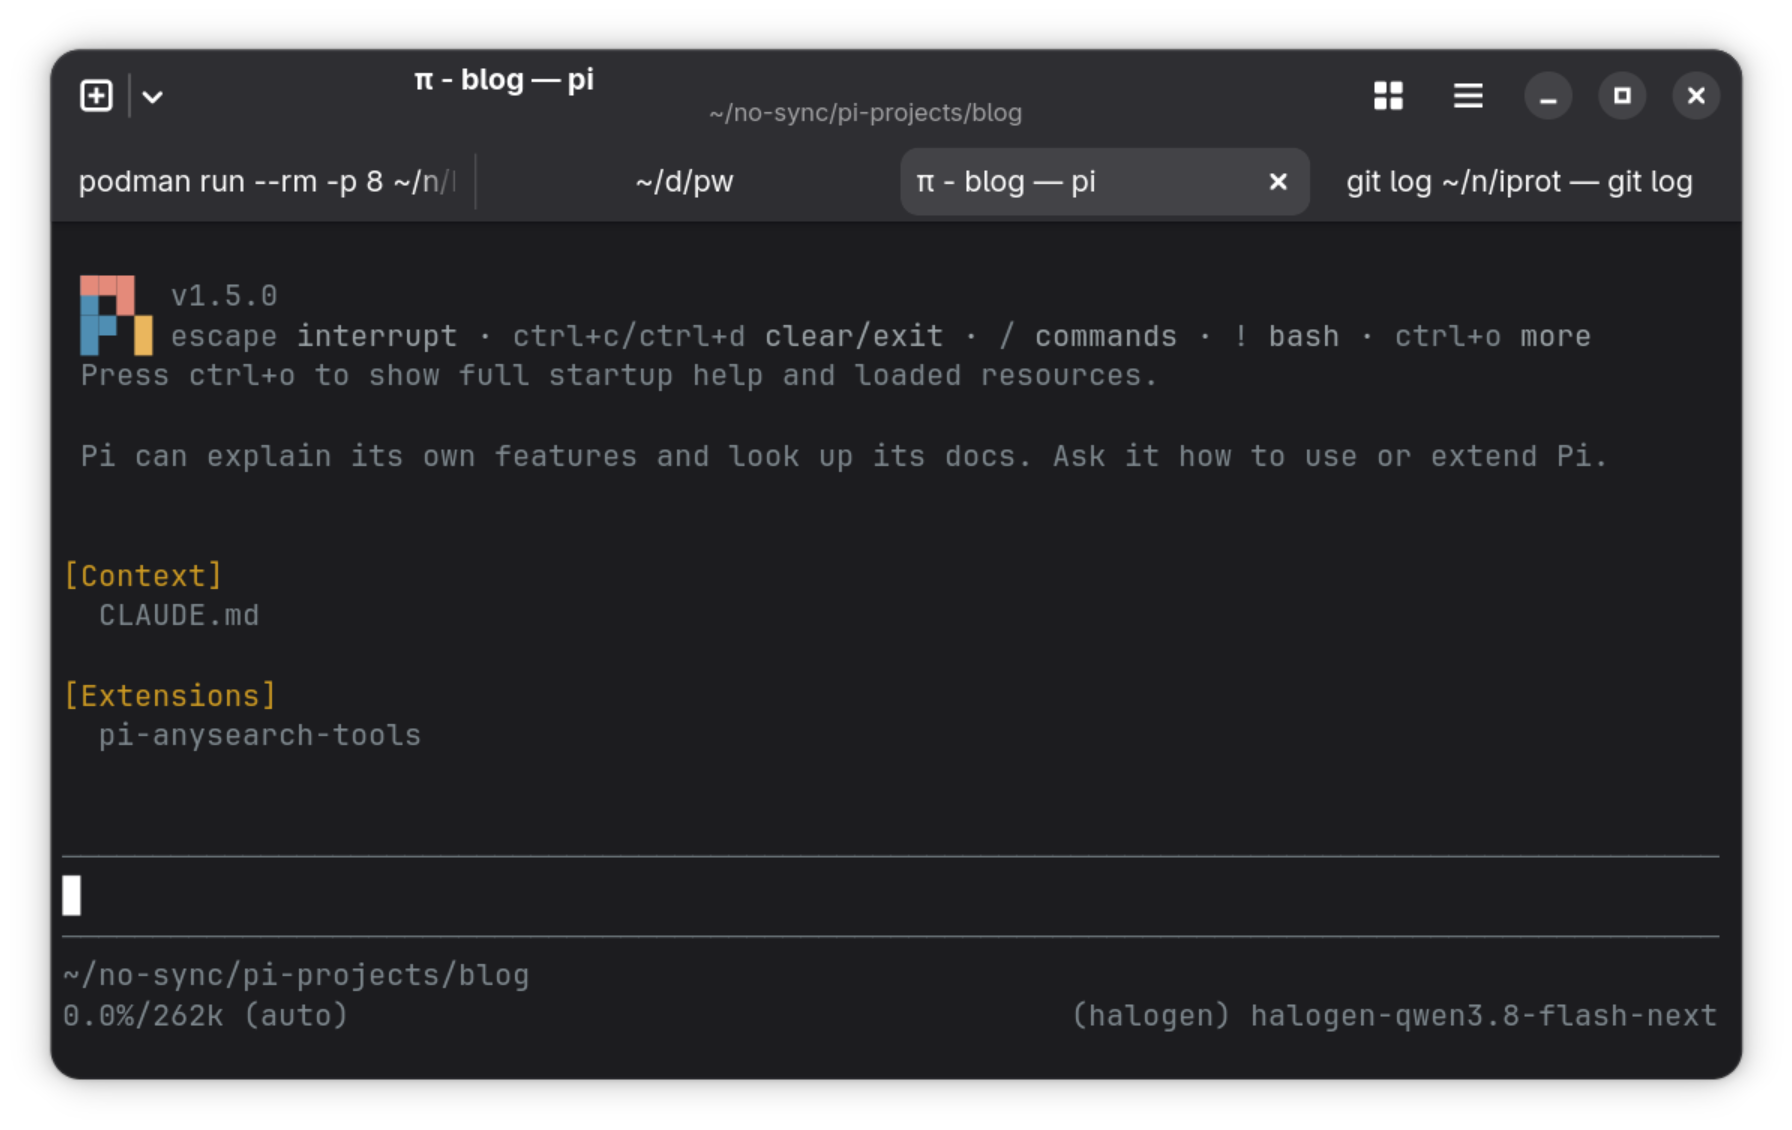
Auch die Startseite von Pi ist minimalistisch
Lokale Modelle anbinden
Für mich viel interessanter ist aber die Anbindung eines lokalen Modells. Dazu tragen Sie den Server in ~/.pi/agent/models.json ein. Das folgende Beispiel geht davon aus, dass LM Studio auf dem lokalen Rechner läuft und dort das Modell Qwen 3.8 Flash Next geladen ist:
Pi spricht mit LM Studio über die OpenAI-kompatible Schnittstelle. Die meisten Inferenz-Engines unterstützen diese API, d.h., die gleiche Konfiguration funktioniert sinngemäß auch für Ollama, vLLM oder die auf Strix Halo optimierten Engines, die ich in meinem Artikel zu Qwen 3.8 Flash Next vorgestellt habe. Sie müssen nur baseUrl und die Modell-ID anpassen. Die Angabe von contextWindow ist optional; ohne sie nimmt Pi 128.000 Token an. Welche Modelle gerade zur Auswahl stehen, zeigt /model.
Mittlerweile hat Pi außerdem einen eingebauten Provider für den Router-Modus von llama.cpp. Dabei verwaltet llama serve mehrere GGUF-Modelle und lädt diese bei Bedarf. In Pi richten Sie die Verbindung mit /login llama.cpp ein, laden mit /llama ein Modell und wählen es dann mit /model aus.
Hinweis: Achten Sie darauf, dass Sie in Ihrer Inferenz-Engine ein ausreichend großes Kontextfenster einstellen. Viele Engines verwenden per Default einen winzigen Kontext von 4.096 oder 32.768 Token. Für agentisches Coding ist das viel zu wenig, auch mit Pi. Ich verwende auf meinem 128-GB-Rechner das Maximum, das viele lokale Modelle aktuell unterstützen, also 256k Token (262144).
Erweiterungsmechanismen
Ein Agent mit so wenigen Tools klingt trostlos. Pi kompensiert den anfänglichen Minimalismus mit vier Erweiterungsmechanismen:
Skills: Im Kontext steht dauerhaft nur die Beschreibung eines Skills. Die eigentliche Anleitung wird erst geladen, wenn der Skill tatsächlich gebraucht wird.
Extensions: Das sind TypeScript-Module, die eigene Tools, Slash-Kommandos oder Hooks (ebenfalls auf TypeScript-Basis) zur Verfügung stellen.
Prompt Templates: wiederverwendbare Prompt-Bausteine, vergleichbar mit den Slash-Kommandos von Claude Code.
Themes und Keybindings: Farbschemata und Tastenkürzel.
Alle vier Mechanismen lassen sich zu einem Pi Package zusammenfassen und über npm oder Git weitergeben. Installiert werden Pakete mit pi install npm:paketname.
MCP: Kehrtwende mit Kontext-Spartrick
Lange Zeit war die Meinung der Pi-Entwickler zu MCP klar: »No MCP. Build CLI tools with READMEs.« Wer partout MCP wollte, musste das Paket pi-mcp-adapter installieren.
Mit Version 0.99 (Ende September 2026) hat sich das geändert: Pi unterstützt MCP-Server jetzt direkt, sowohl lokal (stdio) als auch remote (Streamable HTTP, inklusive OAuth-Login). Die Konfiguration erfolgt in ~/.pi/agent/mcp.json bzw. projektspezifisch in .pi/mcp.json. Das Format entspricht dem von Claude Code, d.h., Sie können vorhandene mcpServers-Einträge einfach kopieren. Alternativ richten Sie Server mit pi mcp add ein:
$ pi mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem .
$ pi mcp add docs --url https://example.com/mcp --bearer-token-env-var DOCS_TOKEN
$ pi mcp list
Innerhalb von Pi zeigt /mcp den Zustand aller Server an. Dort können Sie Server auch aktivieren oder deaktivieren und sich bei OAuth-Servern anmelden.
Interessant ist, wie Pi das Kontextproblem löst, das MCP-Server üblicherweise verursachen. Per Default landen die Tool-Definitionen der MCP-Server nämlich gar nicht im Kontext. Stattdessen aktiviert Pi ein zusätzliches Tool namens Codemode. Damit schreibt das Sprachmodell kleine JavaScript-Programme, die in einer Sandbox ausgeführt werden. Dort kann das Modell mit searchTools() nach passenden MCP-Tools suchen, diese aufrufen, die Ergebnisse filtern und nur die wirklich relevanten Ergebnisse zurückgeben. Im Systemprompt steht pro MCP-Server nur eine Zeile mit einer Kurzbeschreibung. Alternativ können Sie in mcp.json für jeden Server bzw. für einzelne Tools einstellen, ob diese direkt deklariert werden (direct), erst nach einer Suche mit tool_search (deferred) oder gar nicht (hidden).
Ob dieses Konzept auch mit lokalen Modellen gut funktioniert, hängt vom Modell ab: Ein Modell, das zuverlässig JavaScript schreibt und Tools sucht, profitiert davon. Für kleinere Modelle ist es vermutlich besser, wenige wichtige Tools mit direct freizugeben.
Keine Websuche
Zu den Lücken in Pi zählt nach wie vor die Websuche. Pi greift auf das bash-Tool mit curl zurück, um einzelne Webseiten mit bekannter URL zu lesen, aber das ist kein echter Ersatz. Hier liegt kein technisches Problem vor, sondern ein wirtschaftliches: Die meisten Suchmaschinen leben von der Werbung. Sie erkennen agentische Websuchen und blockieren diese rasch. Die fehlende Websuche ist kein Pi-spezifisches Problem, sondern betrifft auch andere Open-Source-Agenten außerhalb des reinen Coding-Umfelds, z.B. Hermes und OpenClaw.
Glücklicherweise gibt es Packages, die eine Suchfunktion für Pi nachliefern. Die meisten davon benötigen aber einen Key oder ein Abo. Beispielsweise nutzt npm:@burneikis/pi-web-search die Websuche von Anthropic; dass setzt aber einen Claude-API-Key voraus. Ich habe stattdessen pi-anysearch-tools ausprobiert. Die Installation ist unkompliziert:
$ pi install npm:pi-anysearch-tools
Das Paket erfordert allerdings eine Registrierung und einen Key bei https://anysearch.com. AnySearch hat (Stand: November 2026) einen großzügigen Free Plan, der immerhin 1.000 Suchanfragen pro Tag erlaubt. Für mehr Suchen oder eine bessere Suchqualität müssen Sie ein Abo abschließen. Den Key tragen Sie in ~/.pi/agent/anysearch.json ein:
{
  "anysearchApiKey": "as_sk_xxx"
}
Bei meinen Tests hat das Zusammenspiel zwischen Pi und AnySearch ausgezeichnet funktioniert. Seit Pi MCP unterstützt, können Sie natürlich auch einen MCP-Server für die Websuche einbinden.
Keine Permissions
Pi hat kein Permission-System. Das Modell ruft bash auf. Damit läuft jedes Kommando mit Ihren Rechten; im Worst Case gilt das auch für rm -rf! Im Unterschied zu Claude Code gibt es weder einen Auto-Modus noch einen Classifier, der Kommandos vor der Ausführung begutachtet. Wer die Grenzen der Permission-Systeme kommerzieller Coding-Agenten kennt, mag das konsequent finden. Tatsächlich habe ich mit Pi durchwegs gute Erfahrungen gemacht. Dennoch gilt: Pi ist nur so gut wie die Modelle, die es nutzt.
Immerhin gibt es einen sogenannten Project Trust: Wenn ein Projektverzeichnis eigene Einstellungen, Extensions, Skills oder MCP-Server mitbringt (also z.B. .pi/settings.json oder .pi/mcp.json), fragt Pi beim Start, ob Sie diesem Projekt vertrauen. Das verhindert, dass ein fremdes Repository unbemerkt Code in den Pi-Prozess lädt. Auf die Aktionen des Sprachmodells hat das aber keinen Einfluss.
Die Dokumentation empfiehlt stattdessen, Pi in einen Container oder eine virtuelle Maschine zu stecken, und beschreibt dafür mehrere Varianten. Das ist nicht so komfortabel wie die Sandboxing-Systeme kommerzieller Coding-Agenten, aber sicherheitstechnisch ein vernünftiger Ansatz.
Was sonst noch fehlt
Ebenfalls nicht eingebaut sind Subagenten, ein Planungsmodus, Hintergrund-Tasks oder eine Worktree-Unterstützung. Die Entwickler argumentieren, dass solche Features besser als Extension aufgehoben sind. Tatsächlich gibt es fertige Pakete, die genau das nachrüsten. Wer alles auf einmal will, greift zu omp: Das ist ein Fork von Pi, der LSP-Integration, Debugger-Anbindung, Subagenten und Planungsmodus mitbringt. Leider ist man damit wieder bei der Komplexität, vor der Pi ursprünglich geflüchtet ist.
Sessions, Slash-Kommandos und Optionen
Pi speichert jede Session als JSONL-Datei in ~/.pi/agent/sessions, sortiert nach Arbeitsverzeichnis. Mit /resume kehren Sie zu einer früheren Session zurück, mit /fork zweigen Sie von einer beliebigen Nachricht eine neue ab. /compact fasst den bisherigen Verlauf zusammen.
Neuartig aus Claude-Code-Perspektive ist /tree: Das Kommando stellt die Session als Baum dar, in dem Sie navigieren und zwischen Zweigen wechseln können. Wenn Sie einen Prompt zurücknehmen und anders formulieren, geht der alte Ast nicht verloren; Sie können jederzeit dorthin zurückspringen und beide Varianten vergleichen. Das ist deutlich mächtiger als eine lineare Rewind-Funktion.
Für die Automatisierung gibt es Betriebsarten ohne Benutzeroberfläche: pi -p "prompt" liefert die Antwort und endet dann. --mode json gibt einen Event-Stream aus, --mode rpc erlaubt die Steuerung über stdin und stdout. Mit --export machen Sie aus einer Session eine HTML-Datei. Mit --tools bzw. -t bestimmen Sie, welche Tools aktiv sind. Beispielsweise aktiviert pi -t +codemode,-write zusätzlich codemode und deaktiviert write.
Praktische Erfahrungen
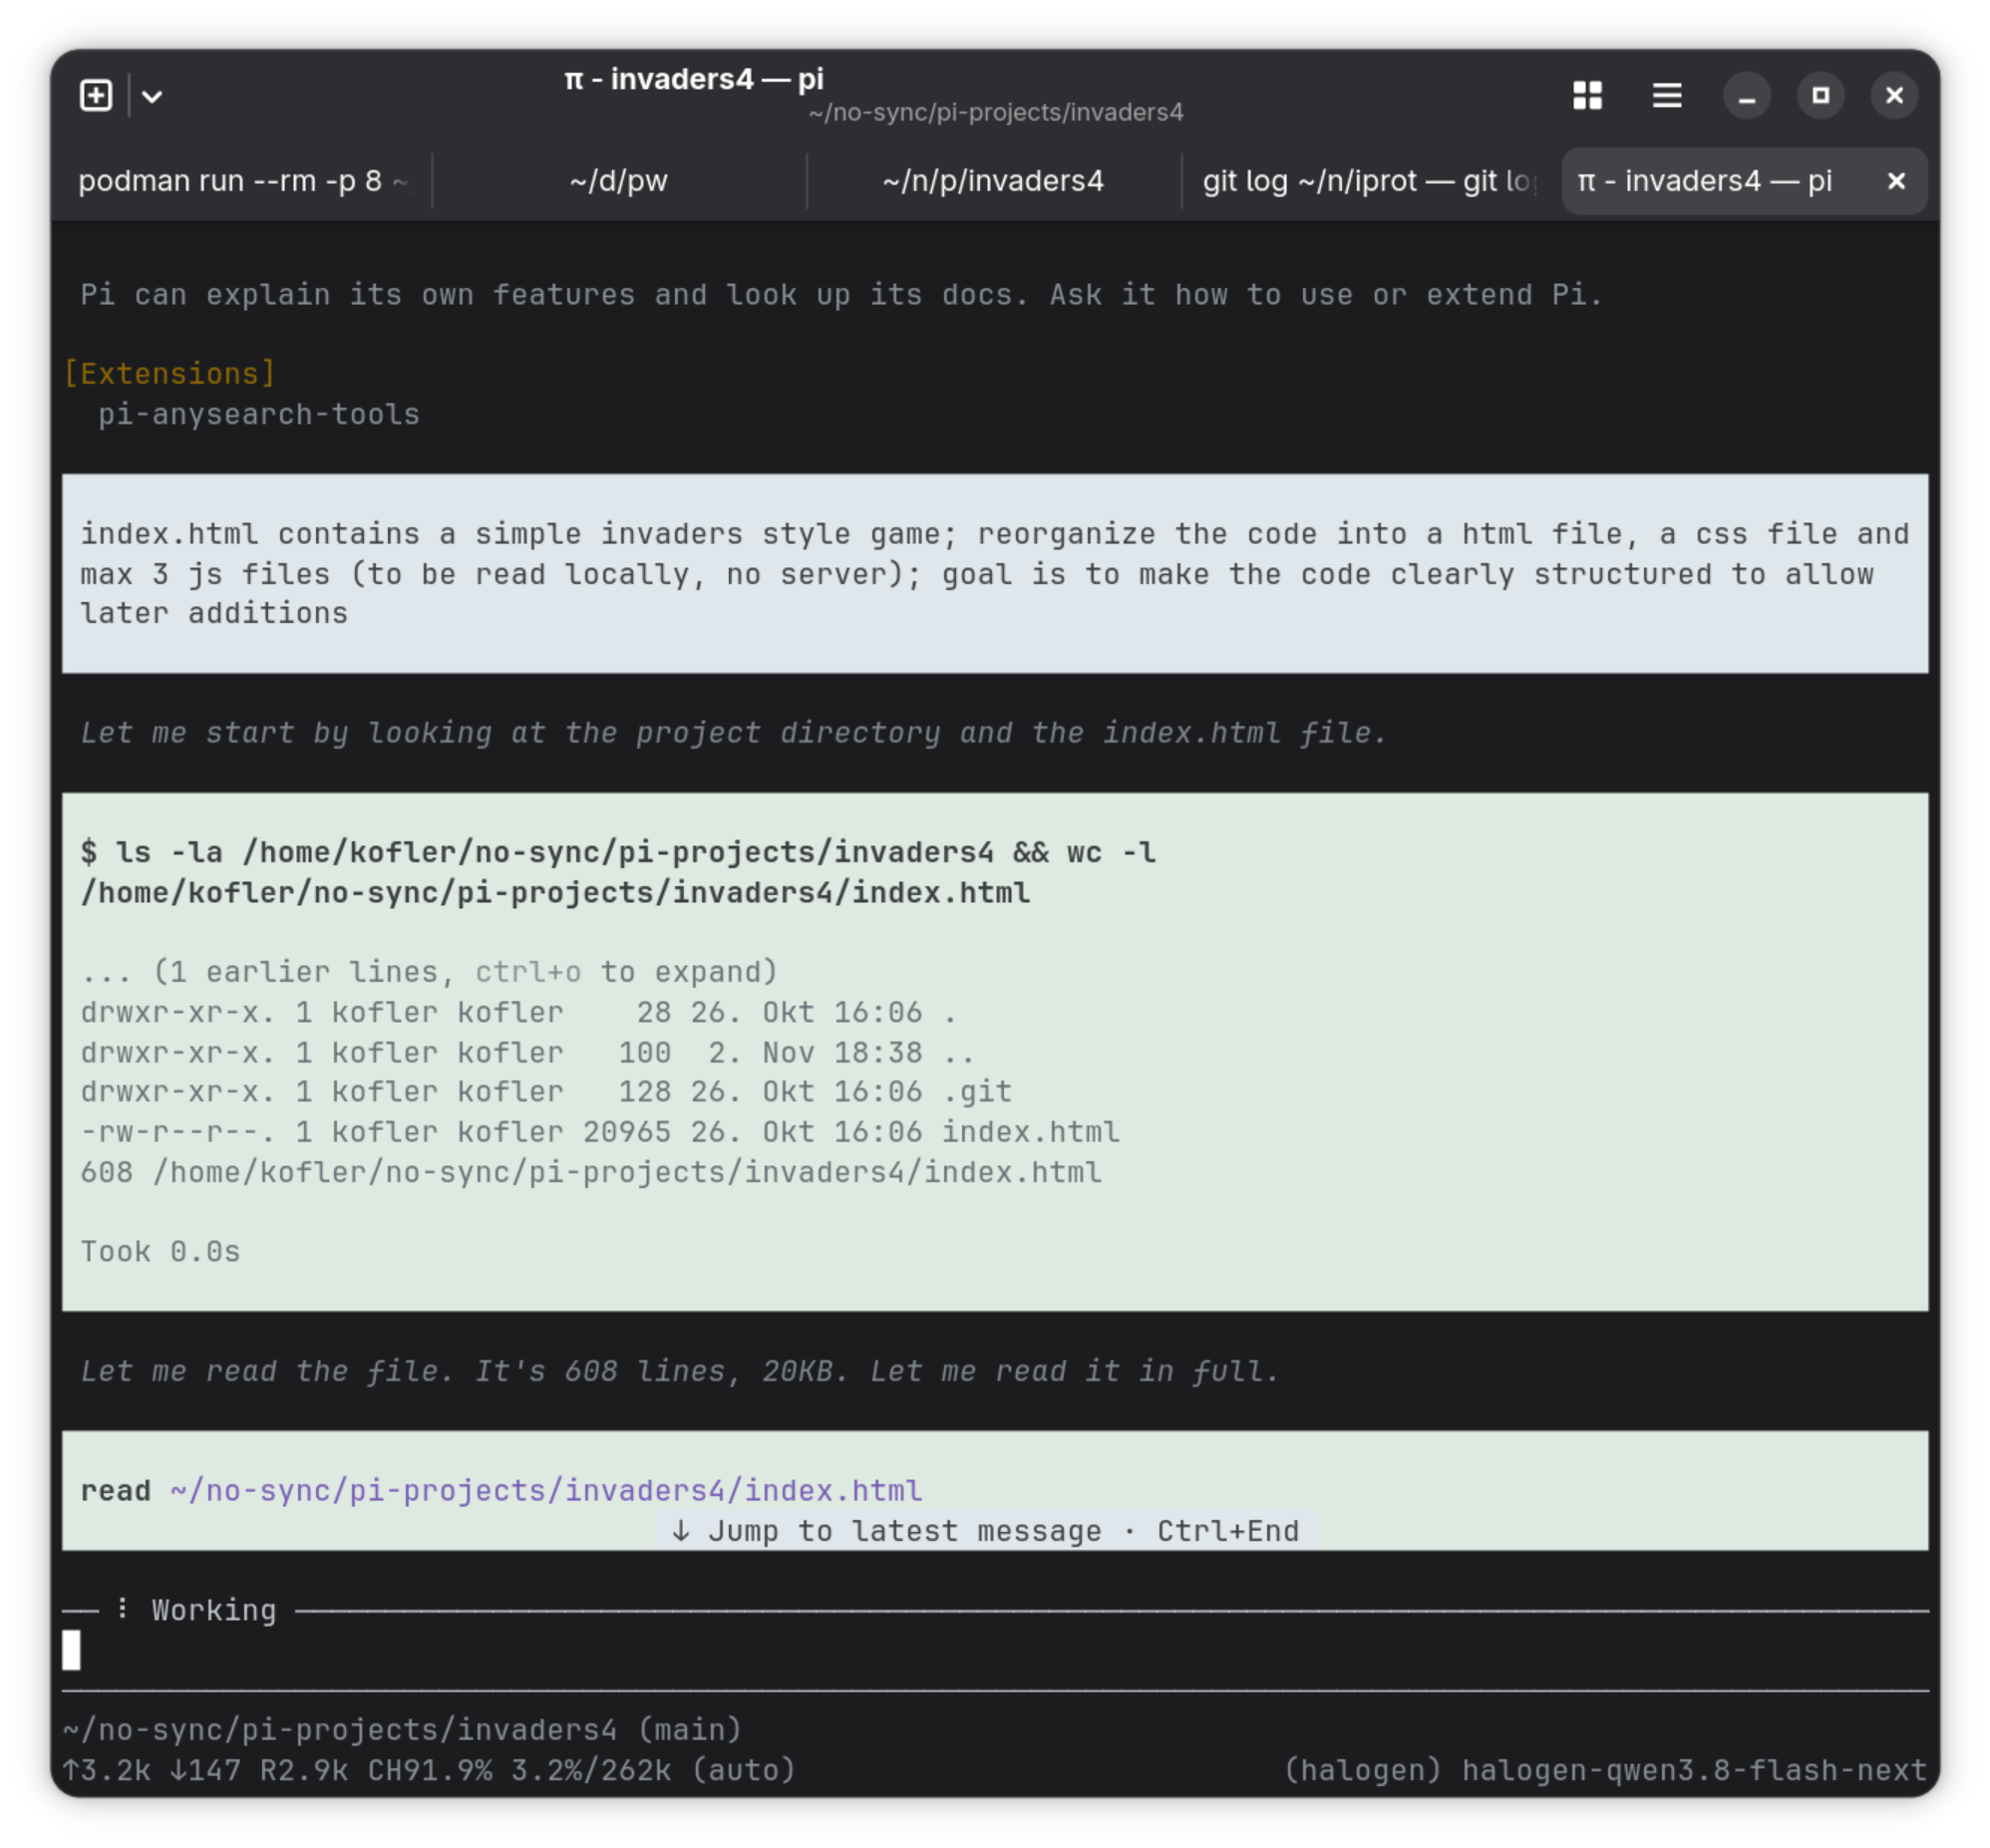
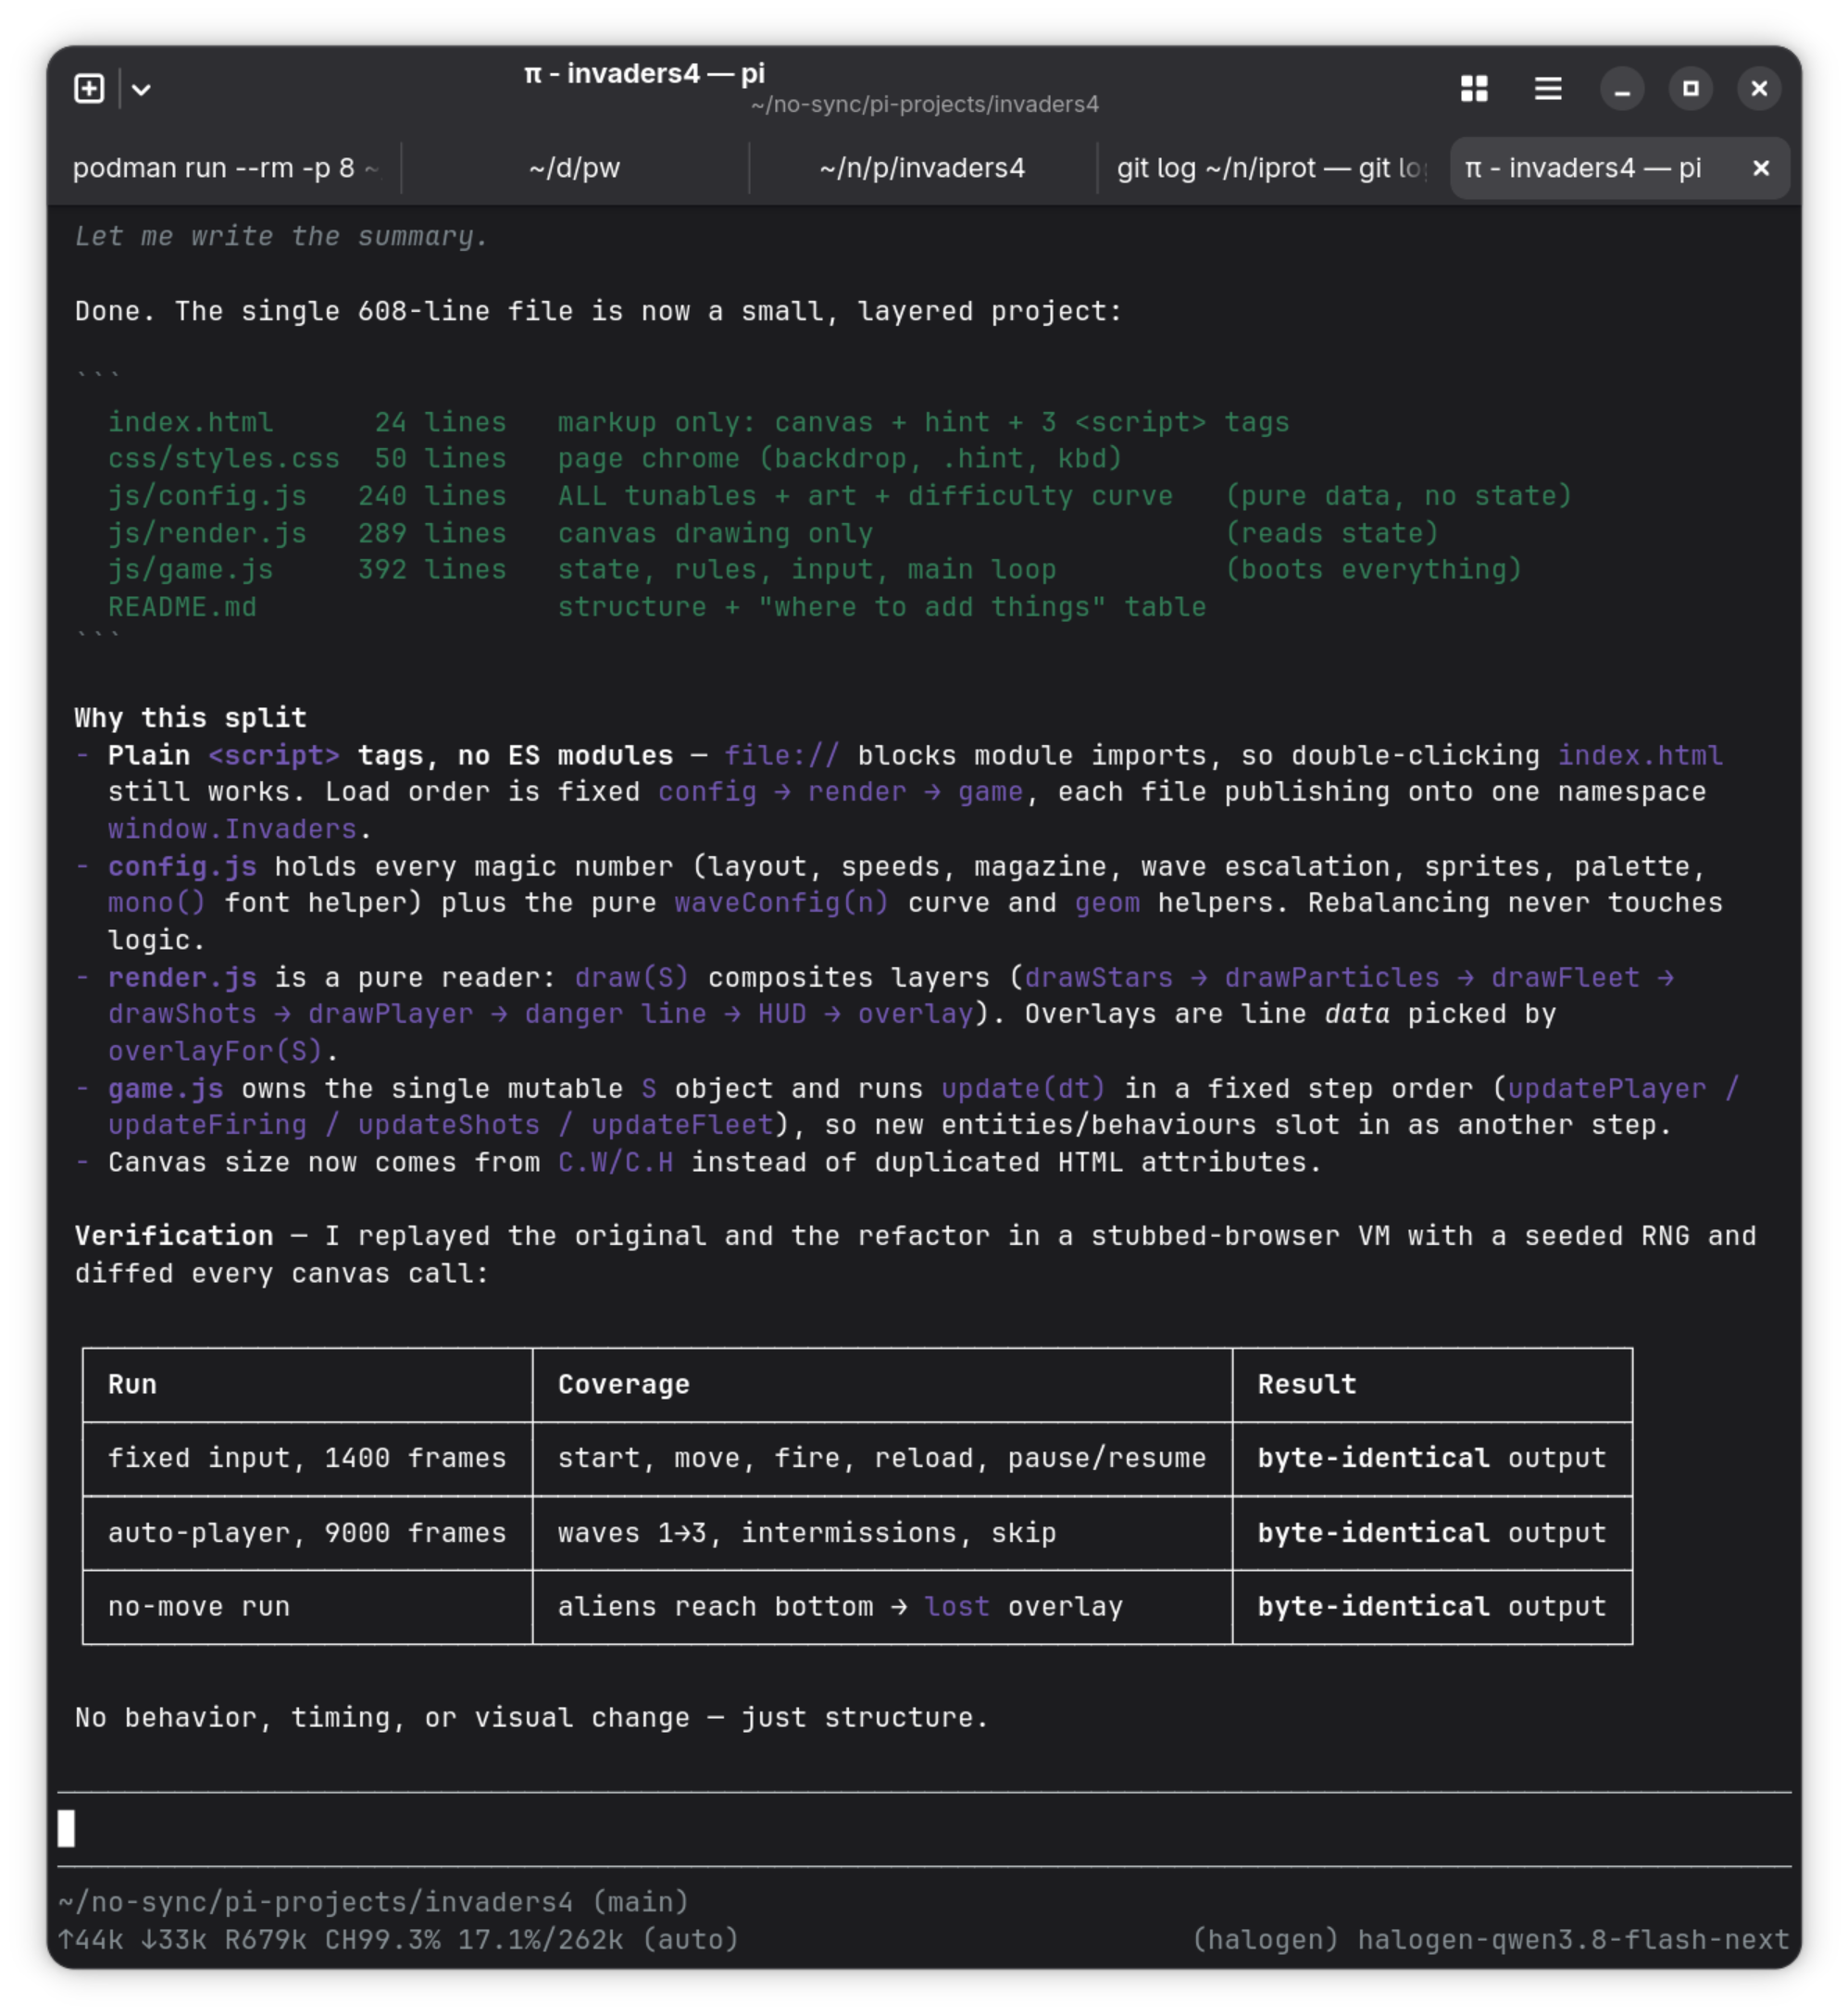
Ich habe Pi mit dem lokalen Modell Qwen 3.8 Flash Next getestet (siehe auch meinen Blog-Artikel zu Qwen 3.8 Flash Next). Als ersten Test habe ich Pi gebeten, ein Spiel in der Art von Space Invaders zu programmieren. Die erste, fehlerfrei spielbare Version war nach vier Minuten fertig. Auch meine Verbesserungswünsche samt einem größeren Refactoring wurden anstandslos und zügig ausgeführt.
Pi startet einen größeren Refactoring-ProzessDas abgeschlossene Refactoring
Ein einfaches Browser-Spiel ist ein netter Test, aber wie sieht es mit realem Code aus? Pi und Qwen 3.8 Flash Next schlagen sich wacker. Heute habe ich in einer größeren PHP-Datei (ca. 2000 Zeilen / 60 kByte Code) eine Sicherheitsanalyse durchgeführt. Pi musste natürlich auch diverse verknüpfte Code-Dateien lesen. Das Ergebnis war inhaltlich exzellent und formal gut aufbereitet, aber Claude Code (oder Pi im Zusammenspiel mit kommerziellen Cloud-Modellen) wäre viel schneller fertig gewesen. Wenn Sie diesbezüglich einmal verwöhnt sind, fällt diese Gemächlichkeit schwer, zumal gleichzeitig der Lüfter hochdreht, um die CPU zu kühlen. Lokale Modelle verdeutlichen den mit der KI verbundenen Ressourcenaufwand viel spürbarer als Cloud-Modelle!
Ich verwende KI-Agenten nicht nur für das Coding, sondern auch für eine erste Korrektur meiner in Markdown-Syntax verfassten Texte (Rechtschreibfehler, Grammatik, inhaltliche Fehler, Redundanzen etc.). Die Geschwindigkeit spielt dabei eine untergeordnete Rolle; bei längeren Texten kann ich Korrekturläufe auch über Nacht ausführen. Mit dem Coding-Agent Pi hat dieser Test zugegebenermaßen wenig zu tun, vielmehr betreffen die Ergebnisse das von mir genutzte Sprachmodell.
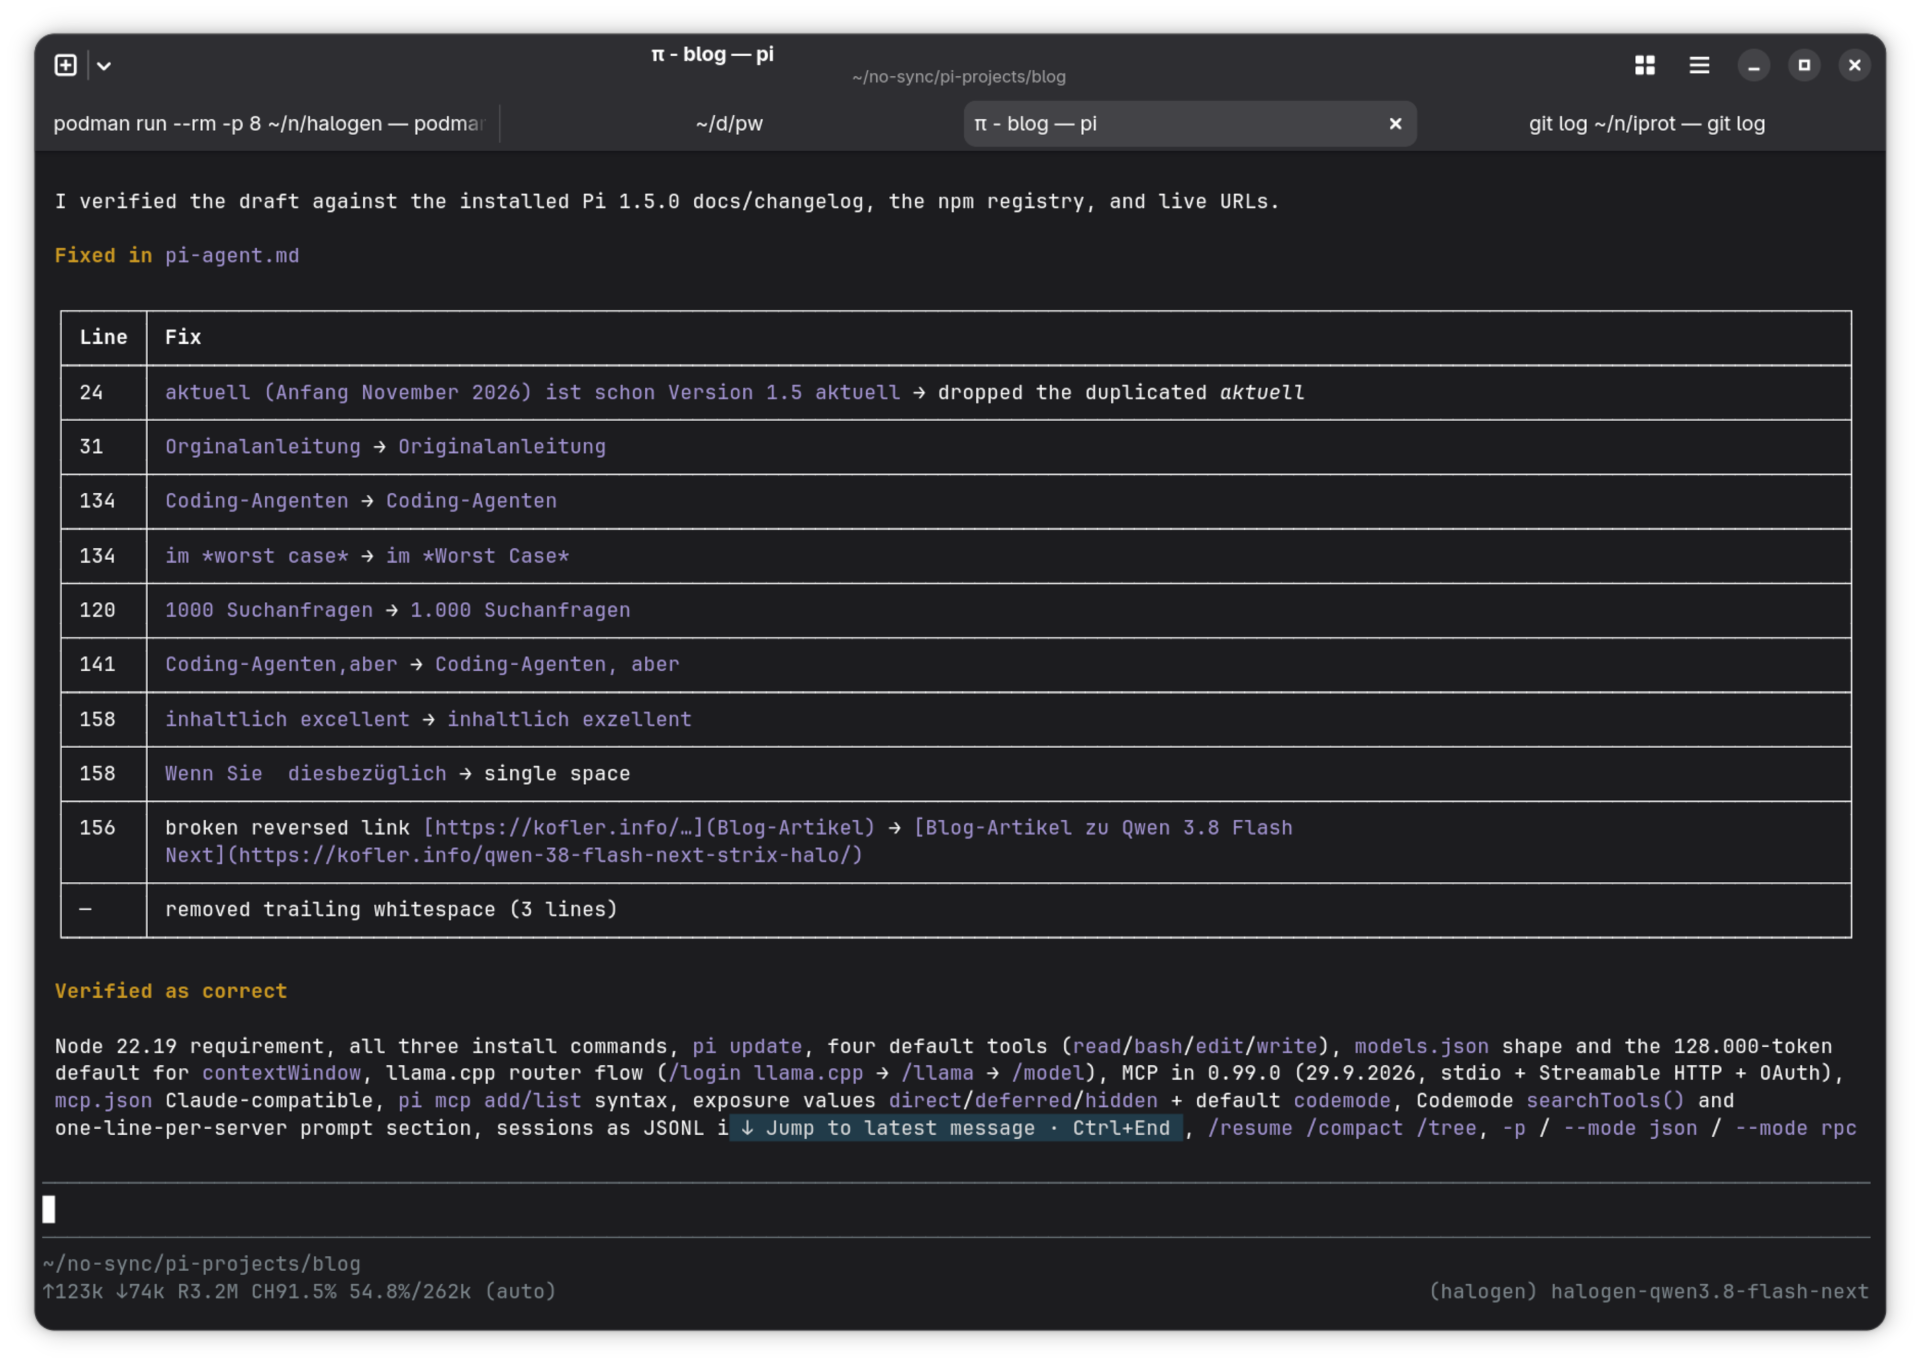
Das Korrekturlesen für diesen Text samt einer inhaltlichen Kontrolle hat mehr als eine Viertelstunde gedauert. Qwen-3.8-flash-next ist dabei übertrieben pingelig vorgegangen. In Pi können Sie dem Sprachmodell beim »Denken« zusehen. Qwen hat immer wieder dieselben Dinge überprüft und viele — aus meiner Sicht — komplett sinnlose Doppel- und Dreifachkontrollen durchgeführt. (Hinterlassen Sie einen Kommentar, wenn Sie doch noch einen Fehler finden!) Mein Prompt war: »proofread @pi-agent.md: fix obvious typos or grammar errors; list everything else; also check content on factual errors«
Korrektur dieses Artikels mit Pi und Qwen-3.8-flash-next
Um es zusammenzufassen: Pi mit Qwen 3.8 Flash Next funktioniert ausgezeichnet, aber kommerzielle Coding-Agenten bzw. Pi in Kombination mit kommerziellen Modellen arbeiten eben noch besser.
Fazit
Für mich kann Pi plus ein lokales Modell Claude Code noch nicht vollständig ersetzen. Das habe ich zu Beginn meiner Tests auch nicht erwartet. Für große Software-Projekte bieten kommerzielle CLIs von Anthropic, OpenAI oder Mistral mehr Qualität, Geschwindigkeit und Arbeitskomfort.
Aber Pi zeigt, wie wenig ein Coding-Agent braucht. Pi glänzt da, wo kommerzielle Agenten schwächeln: im Zusammenspiel mit lokalen Modellen mit begrenztem Kontext und begrenzter Rechenleistung. Wenn Sie aus Gründen des Datenschutzes oder der Unabhängigkeit mit einem lokalen Modell arbeiten möchten, ist Pi die erste Wahl.
Von der geringeren Geschwindigkeit und Qualität lokaler Modelle einmal abgesehen, empfand ich die fehlende Websuche als das größte Hindernis für produktives Arbeiten: Für mich ist ein Coding-Agent auch ein Hilfsmittel zur Recherche. Bei Bugs im Zusammenspiel mit modernen Bibliotheken oder bei Setup-Problemen mit neuen Tools erwarte ich, dass der Agent aktuelle Infos aus dem Internet beschaffen kann. Bei Open-Source-Coding-Agenten wie Pi ist dazu die Anbindung an einen externen Suchdienst notwendig, die zumindest bei intensiver Nutzung zusätzliche Kosten verursacht.
In dem neuen, schweren KI-Benchmark GDPx, der sich auf Ausgaben aus den Branchen konzentriert, die den höchsten Anteil am Bruttoinlandsprodukt (GDP) haben, erreicht das beste System gerade einmal…
Wiki.js ist eine quelloffene und selbst hostbare Wiki-Software auf Basis von Node.js. Gerade ist Wiki.js 3.0 erschienen, das im Backend wie auch im Frontend vollständig neu geschrieben wurde.
Eine kritische Sicherheitslücke im TCP-Stack des Linux-Kernels sorgt für Handlungsbedarf bei Linux Distrtros und Admins. Die als CVE-2026-98432 geführte Schwachstelle erhält vom Kernel-Team einen CVSS-Wert von 9,8. Während die Kernel Entwickler die Sache dringlich erachten, stufen einige Distros die Kritikalität geringer ein. Besondere Aufmerksamkeit erhielt die Lücke, nachdem Anthropic am 27. Oktober demonstrierte, dass das […]
Generative KI verändert die Entwicklung von Open-Source-Software und stellt Maintainer vor neue Herausforderungen. Eine aktuelle Studie von LF Research, der Forschungsabteilung der Linux Foundation, kommt zu dem Ergebnis, dass schätzungsweise 25 Prozent der eingereichten Pull Requests qualitativ minderwertige, KI-generierte Beiträge enthalten. Bei größeren Projekten mit mehr als 50 Entwicklern steigt dieser Anteil laut den Befragten […]
Zusammengeschlossen in der Association for Human Mathematics (AHM) stellen die Mathematiker fest, Mathematik sei ein menschliches Unterfangen, dass sie gegen die Bedrohung durch KI schützen…
Neu auf den Spitzenplatz des Artificial Analysis Index rückt Googles Gemini 4 Carbon, das mit 59 Punkten Claude Opus 5.5 (Anthropic) um einen Punkt übertrifft.
Artificial Analysis hat seine vielzitierte Benchmark-Suite entscheidend überarbeitet und damit die Rangfolge der Modelle teilweise auf den Kopf gestellt.
Die Inhaber der Urheberrechte an 274 Elvis-Presley-Songs – darunter weltbekannte Titel wie “Return To Sender” oder “Can’t Help Falling In Love” – fordern…
Das Problem minderwertiger KI-Beiträge ist real. Die Moderation auf Reddit führt aber einen Rundumschlag auch gegen langjährig gepflegte Projekte und Menschen mit geringen Englischkenntnissen durch.
Nach den Speicherchips, deren Produktionskapazität größtenteils in riesige KI-Projekte fließt, vereinnahmt KI nun die nächste Schlüsselressource aller Elektronik: die Leiterplatte.
KI verändert die Software-Entwicklung. Das lässt sich nicht wegdiskutieren. Einen ausgewogenen Umgang damit lassen Communities und Social Media häufig vermissen.
Linus Torvalds’ erste mit Claude Code erstellten Kernel-Patches führen zu engagierten Diskussionen und viel Kritik an der von der Kernel-Entwicklung eingeschlagenen Richtung.
Laut einer Umfrage von Washington Post, ABC News und Ipsos lehnt eine deutliche Mehrheit der Amerikaner den Bau neuer Rechenzentren in den Vereinigten Staaten ab, glaubt, dass künstliche…
Eine Untersuchung des spanischen Forschungsinstituts Imdea Networks zeigt, dass mehrere bekannte KI-Chatbots Informationen aus Nutzergesprächen an externe Tracking- und Analysedienste übermitteln. Von neun untersuchten Webversionen waren sechs betroffen. Zu den Anbietern gehörten ChatGPT, Claude und Gemini. Die Weitergabe umfasste unter anderem Chat-Titel, Links zu Unterhaltungen und eingegebene Fragen. In einzelnen Fällen gelangten auch Screenshots an […]
Grundlage der neuen Chips ist Googles Neural Processing Unit (NPU) Coral, deren Accelerator-Design im vergangenen Jahr unter Apache-2.0-Lizenz veröffentlicht wurde, was es anderen Firmen…
Anthropic hat still und heimlich einen Gesetzentwurf erarbeitet, der regeln soll, wie Frontier-KI-Modelle künftig reguliert werden können, berichtet das amerikanische Nachrichtenportal Politico.
Linus Torvalds spricht sich deutlich gegen Einschränkungen beim Einsatz von KI-Werkzeugen in der Linux-Kernel-Entwicklung aus. In einer Diskussion auf der Kernel-Mailingliste kritisierte er den Versuch, bestimmte Hilfsmittel für Entwickler zu verbieten. Entscheidend sei nicht, womit ein Beitrag erstellt wurde, sondern ob der Entwickler seinen Code versteht und die Verantwortung dafür übernimmt. Ausgangspunkt der Debatte ist […]
In einem weiteren Urteil hat nun das Landgericht Aachen in einem Eilverfahren festgestellt, dass Google für die Inhalte seiner KI-gestützten Suche verantwortlich ist, und ihm untersagt, dort…
Die Bundesregierung distanziert sich offenbar von einer geplanten Zusammenarbeit mit dem französischen KI-Unternehmen Mistral AI und dem Softwarekonzern SAP. Ein im November 2025 vereinbarter Rahmenvertrag für den Einsatz entsprechender KI-Technologie beim Bund ist vorerst vom Tisch. Während SAP und Mistral ihre Entwicklung zunächst eigenständig fortsetzen sollen, könnte das deutsche KI-Unternehmen Aleph Alpha mit seinem Modell […]
Der Browser Brave erweitert seinen integrierten KI-Assistenten Leo um Ende-zu-Ende-Verschlüsselung. Gemeinsam mit NEAR AI will das Unternehmen sicherstellen, dass Anfragen und Antworten nicht einfach von den beteiligten Dienstleistern eingesehen werden können. Statt auf bloße Vertrauensversprechen zu setzen, soll ein technisch überprüfbares Verfahren den Schutz der Kommunikation gewährleisten. Die neue Funktion ist zunächst für das Modell […]

 Anmelden