
 Anmelden

Qwen 3.8 Flash Next auf Strix-Halo-Rechnern ausführen
Im Rahmen meiner Arbeit für unser Claude-Code-Buch habe ich wieder einmal durchgetestet, wie weit man mit lokalen Modellen und Open-Source-Tools kommt. Als Coding-Agent habe ich das Programm Pi verwendet, das ich demnächst hier näher vorstellen will. Pi habe ich zusammen mit diversen lokalen Modellen ausprobiert, unter anderem Gemma 4, Qwen-3.6-35b-a3b, Qwen-3.8-27b sowie Qwen-3.8-Flash-Next. Der Testrechner ist mit 128 GB RAM und einer Strix-Halo-CPU ausgestattet.
Um es kurz zu machen: Gemma 4 und Qwen-3.6-35b-a3b sind für agentisches Programmieren einfach zu schwach. Qwen-3.8-27b ist spürbar besser, aber als »dichtes« Modell (dense, immer alle Parameter im Einsatz) mit meiner Hardware definitiv zu langsam. Richtig spannend ist dagegen Qwen-3.8-Flash-Next! Es ist mit 125 Milliarden Parametern das größte und neueste Modell in meinem Testparcours. Dank MoE (Mixture of Experts) sind aber stets »nur« 6 Milliarden Parameter aktiv. Das Modell enthält außerdem eine Look-up-Tabelle für Token-Kombinationen mit weiteren 51 Milliarden Parametern (N-gram Embedding Layer). Die Gesamtmodellgröße wird daher oft mit 180 Milliarden Parametern angegeben. Der Platzbedarf beträgt bei 4-Bit-Quantisierung ca. 110 GB auf der SSD sowie ca. 90 GB im RAM (weniger, weil nur Teile der Look-up-Tabelle tatsächlich im RAM landen). Bei meinen Tests liefert das Modell bessere Ergebnisse als Qwen-3.8-27b und ist gleichzeitig schneller. Eine sehr angenehme Kombination.
Der Rest dieses Artikels beschäftigt sich mit der Frage, welche Möglichkeiten es gibt, Qwen-3.8-Flash-Next auf Strix-Halo-Rechnern auszuführen. Um es vorwegzunehmen: Mein für Testzwecke beliebtes LM Studio ist ungeeignet. Dafür gibt es zwei Projekte, die speziell für die AMD-CPU optimierte Engines anbieten und einen Output von über 40 Token/s erreichen.
LM Studio
LM Studio ist prinzipiell meine erste Wahl, um ein neues Sprachmodell erstmalig auszuprobieren. Tatsächlich gelingt damit die Ausführung von Qwen3.8-Flash-Next-GGUF mit ca. 24 Token/s. Das ist OK, aber weit weg vom theoretischen Maximum. Der Hauptgrund besteht darin, dass es mir (mit meiner Hardware) nicht gelungen ist, MTP zum Laufen zu bringen. Es gibt zwar auf Hugging Face mehrere Qwen-3.8-Flash-Next-Varianten mit inkludierten MTP-Daten, aber die eine Variante läuft gar nicht, bei der nächsten funktioniert MTP nicht und die Token-Rate sinkt auf 12 Token/s etc.
Die Ursache: Diverse Qwen-3.8-Flash-Next-Varianten setzen speziell gepatchte llama.cpp-Versionen voraus. Das Experimentieren damit ist eine Frickelei, die mich an die ersten Linux-Jahre zurückdenken lässt.
Erfreulicherweise gibt es einige Projekte, die sich darauf spezialisiert haben, moderne Sprachmodelle auf Strix-Halo-Hardware bestmöglich auszuführen. Einen guten Überblick gibt dieses YouTube-Video von Donato Capitella. Ich konzentriere mich hier auf Gufo und Halogen.
Gufo
Das Open-Source-Projekt Gufo will einen einfachen Weg anbieten, speziell für die Strix-Halo-CPU optimierte Engines und Sprachmodelle so zu kombinieren, dass diese mit minimalem Aufwand installiert und so effizient wie möglich ausgeführt werden können.
Die Projektseite enthält Anleitungen, wie Gufo als Podman-Container ausgeführt oder mit nix lokal installiert und kompiliert werden kann. Ich habe mich für die Podman-Variante entschieden und setze dieses Container-System im Folgenden voraus. (Unter Fedora ist Podman per Default installiert.)
Die folgenden Kommandos kombinieren Infos aus dem Gufo-Quickstart und dem Qwen-3.8-Flash-Next-Readme mit ein paar Detailkorrekturen. Der Kontext ist auf die Maximalgröße eingestellt. --sessions 2 ermöglicht zwei parallele Sessions. Das kostet zusätzlichen Arbeitsspeicher; außerdem sind zwei parallele Sessions natürlich langsamer. Wenn Sie nur eine Session brauchen, ist --sessions 1 sicherer.
# hf-Kommando installieren
sudo dnf install python3-huggingface-hub

# aktuellen Benutzer zu den Gruppen render
# und video hinzufügen; wird erst in einer
# neuen Shell wirksam
sudo usermod -aG render,video "$USER"

# Arbeitsverzeichnis erstellen
mkdir ~/gufo
cd ~/gufo

# Qwen-3.8-Flash-Next herunterladen (ca. 110 GB); die Dateien
# landen in ~/gufo/models/qwen3.8-flash-next
hf download unsloth/Qwen3.8-Flash-Next-GGUF \
  --revision 38bb39ee97821de2c9009abb7e93950eec396e66 \
  --include "UD-Q4_K_XL/*" \
  --include "MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf" \
  --include "mmproj-BF16.gguf" \
  --local-dir models/qwen3.8-flash-next

# Pfade zu den Modellen in Variablen speichern
export MODEL="$PWD/models/qwen3.8-flash-next/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf"
export MTP="$PWD/models/qwen3.8-flash-next/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf"

# Gufo-Runtime-Image herunterladen (ca. 5,5 GB)
podman pull ghcr.io/gufo-org/toolboxes/gufo-runtime:latest

# LLM ausführen und auf Port 8080 anbieten
podman run --rm \
  --userns=keep-id:uid=1000,gid=1000 \
  --security-opt label=disable \
  --device /dev/kfd \
  --device /dev/dri \
  --group-add keep-groups \
  --ulimit memlock=-1 \
  -p 127.0.0.1:8080:8080 \
  -v "$(dirname "$(dirname "$MODEL")")":/models:ro \
  ghcr.io/gufo-org/toolboxes/gufo-runtime:latest \
  gufo serve --host 0.0.0.0 --port 8080 llm \
  --model "/models/UD-Q4_K_XL/$(basename "$MODEL")" \
  --speculative mtp \
  --mtp-model "/models/MTP/$(basename "$MTP")" \
  --sessions 2 \
  --context 262144
Mit curl können Sie ausprobieren, ob das Sprachmodell funktioniert:
curl -s http://127.0.0.1:8080/v1/chat/completions \
     -H "Content-Type: application/json" \
     -d '{
           "model": "Qwen3.8 Flash Next",
           "messages": [{"role": "user",
                         "content": "Write a Python function that checks if a string is a palindrome."}],
           "max_tokens": 1000,
           "reasoning_effort": "low"
         }' | jq -r '.choices[0].message.content'

  (Antwort gekürzt ...)
  # Palindrome Checker in Python
  def is_palindrome(s: str) -> bool:
      # Remove non-alphanumeric characters and convert to lowercase
      cleaned = ''.join(ch.lower() for ch in s if ch.isalnum())

      # Compare the string with its reverse
      return cleaned == cleaned[::-1]
Damit der Coding-Agent Pi das Sprachmodell verwendet, tragen Sie den Server in ~/.pi/agent/models.json ein:
{
  "providers": {
    "qwen-38-flash-next-gufo": {
      "baseUrl": "http://localhost:8080/v1",
      "api":     "openai-completions",
      "apiKey":  "not necessary",
      "models": [
        { "id": "Qwen3.8 Flash Next",
          "contextWindow": 262144 }
      ]
    }
  }
}
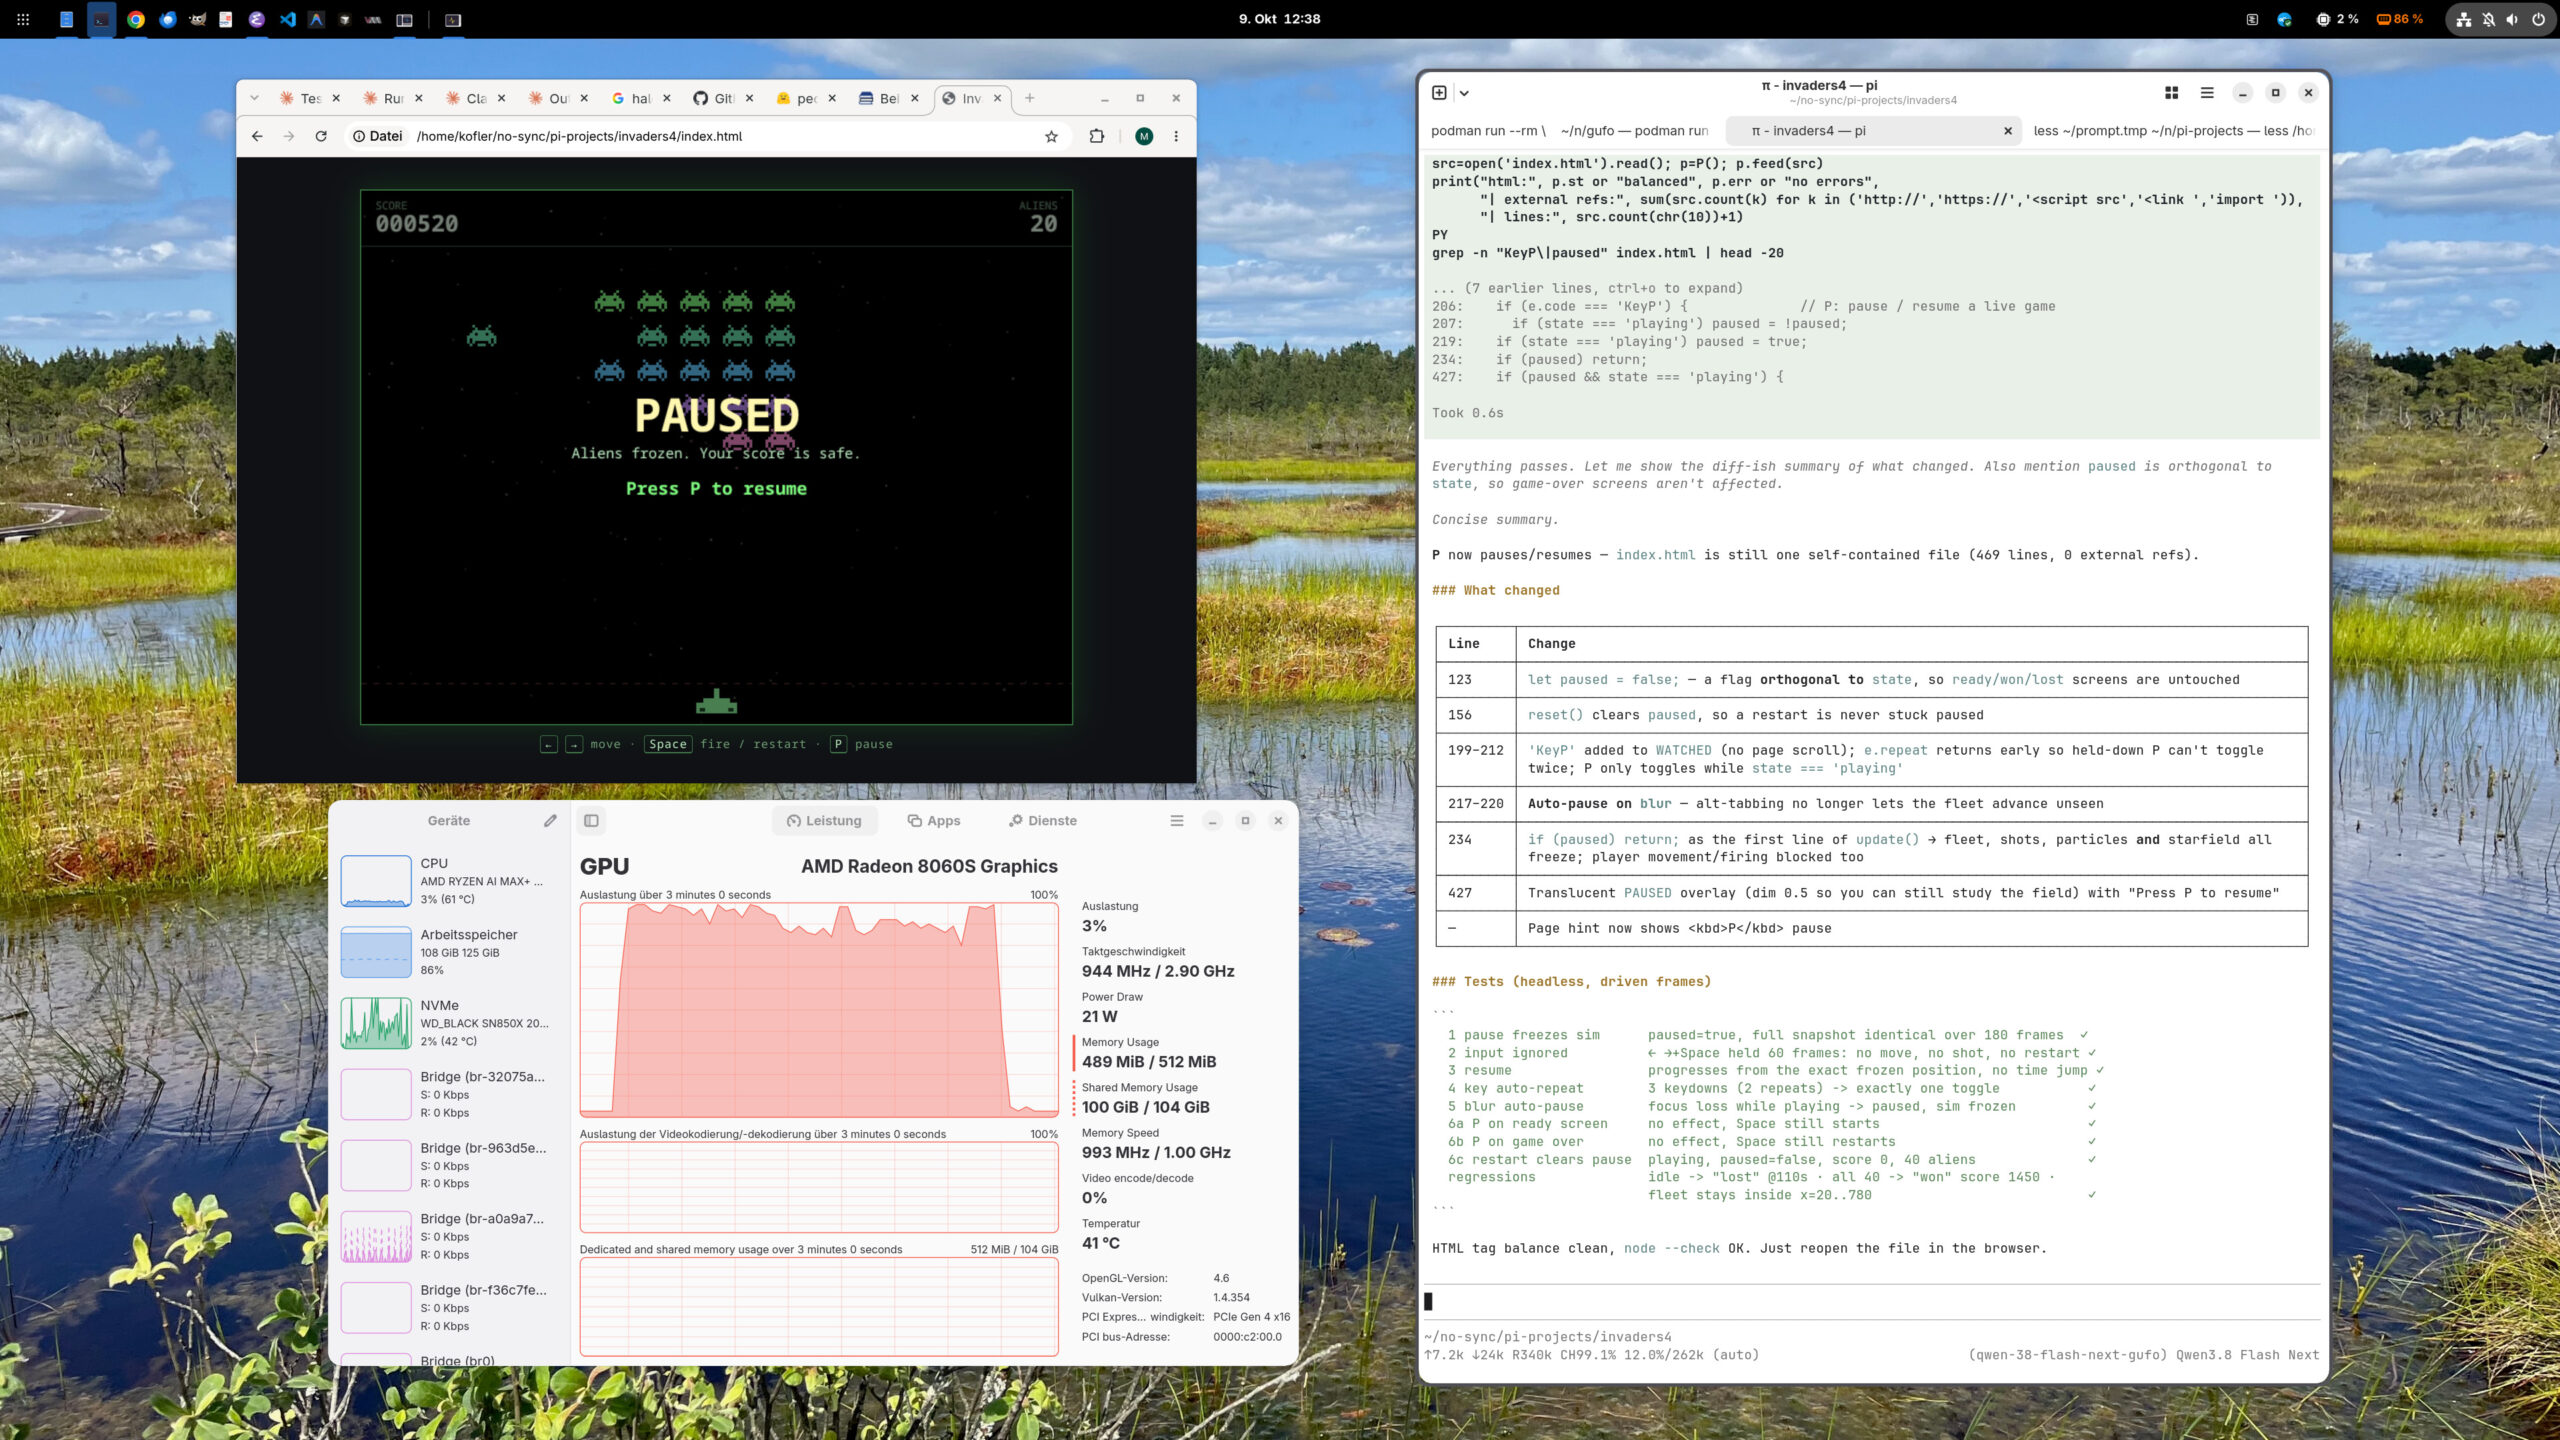
Als Test habe ich Pi aufgefordert, zuerst einen Space-Invaders-Klon zu programmieren und danach eine Pause-Funktion zu implementieren. Dazu waren diese beiden Prompts und ca. 10 Minuten Geduld erforderlich. Der Terminal-Tab mit dem Podman-Container protokollierte Output-Token-Raten zwischen 35 und 50 Token/s, meistens ca. 40 Token/s.
Create a browser game called Invaders in a single file
index.html. Plain HTML, CSS and JavaScript, no frameworks, no build step, no dependencies. Use a canvas size of 800×600. The player controls a ship at the bottom edge with the left and right arrow keys and fires with the space bar. Five rows of eight aliens move sideways as a block, step down one row when they reach an edge, and disappear when a shot hits them. The game ends when all aliens are destroyed or an alien reaches the bottom row. Show the score in the top left corner. Do not start a web server.Implement a pause key (P).
Halogen
Der Halogen-Flash-Server ist in seiner Zielrichtung noch fokussierter. Als einziges Modell wird Qwen-3.8-Flash-Next unterstützt. Die Projektseite verspricht die höchste Token-Rate für dieses Modell auf Strix-Halo-CPUs. Der Nachteil: Teile der Software sind nicht Open Source und damit eine Black Box.
Die Installation bzw. Inbetriebnahme ist einfacher als bei Gufo. Auch Halogen setzt auf Podman. Ein einziges Kommando reicht aus, um das Halogen-Image und das Modell herunterzuladen. Weil Halogen eine anders optimierte Variante von Qwen-3.8-Flash-Next verwendet, ist neuerlich ein Download von über 110 GB notwendig (natürlich nur beim ersten Start). Das Modell wird in ~/halogen-models gespeichert. Die API verwendet standardmäßig den Port 8731. Halogen verwendet automatisch die maximale Kontextgröße (262.144 Token) und erlaubt vier parallele Sessions (einstellbar mit der Umgebungsvariablen HALOGEN_KV_SLOTS).
podman run --rm -p 127.0.0.1:8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --ipc=host --ulimit memlock=-1:-1 \
  -e HALOGEN_DOWNLOAD=peonist-ai/halogen-qwen3.8-flash-next \
  -v ~/halogen-models:/models \
  ghcr.io/peonist-ai/halogen-flash-server:0.17.3
Wiederum sollten Sie zuerst mit curl testen, ob alles funktioniert:
curl -s http://127.0.0.1:8731/v1/chat/completions \
     -H "Content-Type: application/json" \
     -d '{
           "model": "halogen-qwen3.8-flash-next",
           "messages": [{"role": "user",
                         "content": "Write a Python function that checks if a string is a palindrome."}],
           "max_completion_tokens": 4096,
           "reasoning_effort": "low"
         }' | jq -r '.choices[0].message.content'
Die Konfigurationszeilen für Pi sehen so aus:
{
  "providers": {
    "halogen": {
      "baseUrl": "http://127.0.0.1:8731/v1",
      "api":     "openai-completions",
      "apiKey":  "halogen",
      "models": [
        { "id": "halogen-qwen3.8-flash-next",
          "contextWindow": 262144 }
      ]
    }
  }
}
Bei meinen Tests habe ich mit Halogen tatsächlich eine spürbar höhere Geschwindigkeit erreicht (Output zwischen 50 und 60 Token/s). Ich habe einen sehr simplen Benchmarktest durchgeführt und dazu die ersten 40 Aufgaben von HumanEval+ aus EvalPlus 0.3.1 mit Greedy-Decoding und reasoning_effort: low ausgeführt. Halogen brauchte 356 s (61,6 Tokens/s), Gufo 407 s (52,2 Tokens/s), also rund 12 % weniger Zeit bzw. 18 % mehr Durchsatz. Bei der Qualität lagen beide gleichauf: 39 von 40 Aufgaben mit den Original-Tests, mit den erweiterten Tests 37 (Halogen) bzw. 38 (Gufo). Der Test ist zu wenig spezifisch, um echte Qualitätsunterschiede für agentisches Coding festzustellen. Mir fehlt die Zeit, um weitere Tests laufen zu lassen. Immerhin lässt sich sagen: Beide Modelle tun, was sie sollen, und Halogen macht es ein wenig schneller.
Wenn Ihnen der Closed-Source-Black-Box-Charakter von Halogen egal ist, ist Halogen also eine gute Wahl und aktuell vermutlich der schnellste Weg, um Qwen-3.8-Flash-Next auf Strix-Halo-Geräten auszuführen. Gegen das Projekt spricht neben dem fehlenden Quellcode der Umstand, dass keine anderen Sprachmodelle unterstützt werden.
Fazit
Es ist immer wieder überraschend, wie viel Bastelarbeit erforderlich ist, um moderne Sprachmodelle mit offenen Gewichten tatsächlich auszuführen. (Um es noch einmal zu betonen: »Freie« Sprachmodelle sind nicht mit Open-Source-Software zu vergleichen. Zwar ist bei vielen derartigen Modellen immerhin dokumentiert, wie die Gewichte zustande kommen; die Basis des Modells, insbesondere die Trainingsdaten und die genauen Trainingsbedingungen, ist aber nicht zugänglich.)
Um die positiven Aspekte zu nennen: Die real erzielbaren Ergebnisse lokaler Modelle werden von Monat zu Monat besser. Das in diesem Beitrag vorgestellte Modell ist ein gutes Beispiel dafür. Qwen-3.8-Flash-Next schlägt sich in Benchmark-Tests ausgezeichnet. In Kombination mit einer dafür optimierten Engine sind die erzielbaren Token-Raten so hoch, dass ein produktives Arbeiten auf Consumer-Hardware möglich ist.
Die Qualität, Geschwindigkeit und Kontextgröße lokaler Modelle auf Consumer-Hardware kommen natürlich bei weitem nicht an die kommerziellen Modelle auf Cloud-Servern von OpenAI oder Anthropic heran; aber je nach Aufgabenstellung sind freie Modelle mittlerweile gut genug für praktische Arbeiten, z.B. zur Software-Entwicklung mit dem CLI Pi. Das sind gute Nachrichten für alle, die sich Unabhängigkeit und Datenschutz wünschen.
Ehrlicherweise muss ich sagen: Ein Claude-Pro-Abo kostet auch über Jahre gerechnet viel weniger als die für diese Tests erforderliche Hardware. (Mein Testrechner hat Ende 2025 knapp 2500 € gekostet. Mittlerweile ist der Rechner leider fast doppelt so teuer.) Gleichzeitig bieten Claude Code, Codex, Vibe CLI oder andere kommerzielle Angebote mehr Komfort, eine viel höhere Coding-Geschwindigkeit und natürlich, und das ist am wichtigsten, eine deutlich höhere Coding-Qualität. Wenn ich es mir aussuchen darf, werde ich für professionelle Software-Entwicklung also weiter bei den kommerziellen Anbietern bleiben.
Quellen/Links
- https://pi.dev
- https://lmstudio.ai
- https://kofler.info/llm-mtp-apex-qwopus
- https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
- https://youtu.be/Nm_zN6RQ_eE (Qwen3.8-Flash-Next auf AMD Strix Halo, Video von Donato Capitella)
- https://github.com/evalplus/evalplus
Gufo
- https://github.com/gufo-org/gufo
- https://github.com/gufo-org/gufo/blob/main/docs/models/qwen3.8-flash-next/README.md
Halogen
