Normale Ansicht

ChatGPT Power-Prompting

15. April 2025 um 08:25

Das Buch „ChatGPT Power-Prompting“ von Ulrich Engelke ist in der 1. Auflage 2025 im mitp-Verlag erschienen und umfasst 336 Seiten. Es trägt den Untertitel Profi-Strategien für den erfolgreichen Einsatz von KI und richtet sich vor allem an Menschen, die kreativ mit einem Chatbot wie ChatGPT arbeiten möchten.

Ich denke, mittlerweile hat fast jeder, der aktiv im Internet unterwegs ist, in irgendeiner Form bereits Kontakt mit Künstlicher Intelligenz (KI) bzw. Artificial Intelligence (AI) gehabt – sei es über Gemini, Krok oder ChatGPT. Spätestens seit 2022, als ChatGPT den KI-Bereich revolutionierte, ist das Thema in aller Munde. Dabei existiert Künstliche Intelligenz schon deutlich länger. Doch mit ChatGPT hat die Firma OpenAI unter der Leitung von CEO Sam Altman ein Tool geschaffen, das erstmals einer breiten Öffentlichkeit zugänglich ist – und das Nutzerinnen und Nutzern erlaubt, KI sowohl im privaten als auch im beruflichen Kontext einzusetzen. Das zugrunde liegende Large Language Model (LLM) funktioniert nach dem Prinzip „Finde das nächste Wort“ und verarbeitet Anfragen mit einer bemerkenswert hohen Relevanz. Wie man solche Anfragen – sogenannte Prompts – optimal formuliert, damit die Ergebnisse möglichst präzise und hilfreich sind, genau darum geht es in dem Buch „ChatGPT Power-Prompting“ von Ulrich Engelke.

Inhalt und Stärken des Buches

Das Buch ist sehr gut strukturiert und folgt einer logischen, durchdachten und nachvollziehbaren Abfolge. Zunächst erklärt der Autor anschaulich, wie KI-Chatbots funktionieren. Ich hatte bereits den Algorithmus „Finde das nächste Wort“ erwähnt, auf dem das Sprachmodell basiert. Darüber hinaus geht das Buch ausführlich auf das Thema Datenschutz ein – ein Aspekt, der für viele Leserinnen und Leser im Umgang mit dieser neuen Technologie von großer Bedeutung sein dürfte. Um ChatGPT nutzen zu können, benötigt man ein OpenAI-Konto. Wie man dieses einrichtet, wird im Buch detailliert erklärt. Ebenso werden die wichtigsten Unterschiede zwischen der kostenlosen Version und den kostenpflichtigen Pro-Modellen erläutert. Zentrale Begriffe wie Machine Learning, Deep Learning, Kohärenz, Kohäsion oder Halluzinieren werden verständlich erklärt, um Nutzerinnen und Nutzern zu helfen, möglichst präzise und hochwertige Ergebnisse vom Chatbot zu erhalten. Im weiteren Verlauf des Buches geht es dann gezielt um die Kunst der richtigen Eingabe – das sogenannte Prompting. Der Bogen spannt sich vom einfachen Prompt bis hin zum komplexen Power-Prompting. Dabei werden die wichtigsten Eingabeparameter erläutert. Man lernt, wie man mit dem Chatbot in einen interaktiven Dialog eintaucht oder durch präzise Prompts direkt das gewünschte Ergebnis erzeugt. Auf solche Techniken geht der Autor sehr detailliert ein. Außerdem wird erklärt, wie man mit dem GPT-Builder einen angepassten GPT (Generative Pre-trained Transformer) erstellt, um bestimmte Prompts immer wieder automatisch nutzen zu können. Zahlreiche praxisnahe Beispiele – etwa zur Erstellung von Rezepten, Trainings- und Ernährungsplänen oder sogar von Meta-Descriptions für suchmaschinenoptimierte Beiträge – machen das Buch besonders nützlich. Die sogenannte Fünf-Absatz-Essay-Struktur wird beispielsweise als hilfreiches Werkzeug für Blogger vorgestellt. Ulrich Engelke zeigt eindrucksvoll, wie sich mit ChatGPT komplexe Ausgaben für nahezu jeden Anwendungsbereich erzeugen lassen.

Kapitelübersicht

Das Buch gliedert sich in folgende Kapitel:

Teil I Grundlagen

  • Wie funktionieren KI-Chatbots?
  • Datenschutz, Urheberrecht und Einschränkungen
  • Erste Schritte mit ChatGPT


Teil II Professionelle Strategien für bessere Prompts

  • Prompting-Techniken für Einsteiger
  • Power-Prompting für Profis
  • Custom GPTs


Teil III ChatGPT für Alltag und Beruf

  • ChatGPT im Alltag
  • ChatGPT in der Arbeitswelt
  • Lernen mit KI
  • Kreativität

Besonderheiten

  • Das Buch ist sowohl als Printausgabe als auch als E-Book erhältlich.

Leseproben und Downloads

Fazit

„ChatGPT Power-Prompting“ ist ein gut strukturiertes, verständlich geschriebenes Buch, das sowohl Einsteigern als auch Fortgeschrittenen einen fundierten Einstieg in die Arbeit mit KI-Chatbots bietet. Besonders die vielen praktischen Beispiele und klaren Erklärungen machen es zu einer wertvollen Hilfe im Alltag. Der Autor vermittelt nicht nur technisches Wissen, sondern auch den verantwortungsvollen Umgang mit KI. Wer ChatGPT effizient nutzen möchte, findet in diesem Buch einen umfassenden Leitfaden. Es ist sowohl als Printausgabe als auch als E-Book erhältlich.

Der Beitrag ChatGPT Power-Prompting erschien zuerst auf intux.de.

SUSECON 2025: SUSE setzt auf KI und erweiterte SLE -Unterstützung

Von: MK
16. März 2025 um 13:00

SUSE hat auf der diesjährigen SUSECON in Orlando klargestellt, dass es bei der KI-Revolution mitmischen will. Neben einer Reihe von Anwendungsfällen für künstliche Intelligenz gab es auch spannende Neuerungen für Admins im Hinblick auf die verschiedene Linux-Distributionen. Seit 33 Jahren existiert SUSE und brachte im Jahr 2000 mit SUSE Linux Enterprise Server (SLES) seine erste […]

Der Beitrag SUSECON 2025: SUSE setzt auf KI und erweiterte SLE -Unterstützung erschien zuerst auf fosstopia.

DeepSeek kämpft mit schweren Vorwürfen

Von: MK
02. Februar 2025 um 09:00

Ein chinesisches Unternehmen sorgt derzeit für Aufsehen in der Tech-Welt. DeepSeek behauptet, ein KI-Modell entwickelt zu haben, das mit ChatGPT mithalten kann. Das ganze zu einem Bruchteil der üblichen Kosten. Statt Hunderte Millionen Dollar habe man lediglich fünf Millionen investiert. Zudem soll das Modell ohne die teuren Nvidia-Chips auskommen. Diese Ankündigung ließ die Nvidia-Aktie einbrechen. […]

Der Beitrag DeepSeek kämpft mit schweren Vorwürfen erschien zuerst auf fosstopia.

Deepseek: Chinas Antwort auf ChatGPT. Wo ist Europa?

Von: MK
29. Januar 2025 um 07:00

Eine chinesische KI namens Deepseek zieht aktuell weltweite Aufmerksamkeit auf sich. Ihre App stürmte an die Spitze von Apples App Store, was gleichzeitig die Aktienkurse führender US-Tech-Unternehmen ins Wanken brachte. Doch hinter dem Hype steckt mehr – und weniger –, als viele glauben. Die Aufregung dreht sich um die Behauptung, Deepseek habe für nur rund […]

Der Beitrag Deepseek: Chinas Antwort auf ChatGPT. Wo ist Europa? erschien zuerst auf fosstopia.

Künstliches Scheitern: Technische Diagramme mit KI-Tools zeichnen

19. Dezember 2024 um 18:34

Unser Buch Coding mit KI wird gerade übersetzt. Heute musste ich diverse Fragen zur Übersetzung beantworten und habe bei der Gelegenheit ein paar Beispiele aus unserem Buch mit aktuellen Versionen von ChatGPT und Claude noch einmal ausprobiert. Dabei ging es um die Frage, ob KI-Tools technische Diagramme (z.B. UML-Diagramme) zeichnen können. Die Ergebnisse sind niederschmetternd, aber durchaus unterhaltsam :-)

UML-Diagramme

Vor einem halben Jahr habe ich ChatGPT gebeten, zu zwei einfachen Java-Klassen ein UML-Diagram zu zeichnen. Das Ergebnis sah so aus (inklusive der falschen Einrückungen):

+-------------------------+
|         Main            |
+-------------------------+
| + main(args: String[]): void |
| + initializeQuestionPool(): List<Question> |
+-------------------------+

+-------------------------+
|        Question         |
+-------------------------+
| - text: String          |
| - answers: List<Answer> |
| - correctAnswers: List<Answer> |
+-------------------------+
| + Question(text: String, answers: List<Answer>, 
|            correctAnswers: List<Answer>) |
| + askQuestion(): void   |
| - validateAnswer(userInput: String): boolean |
+-------------------------+

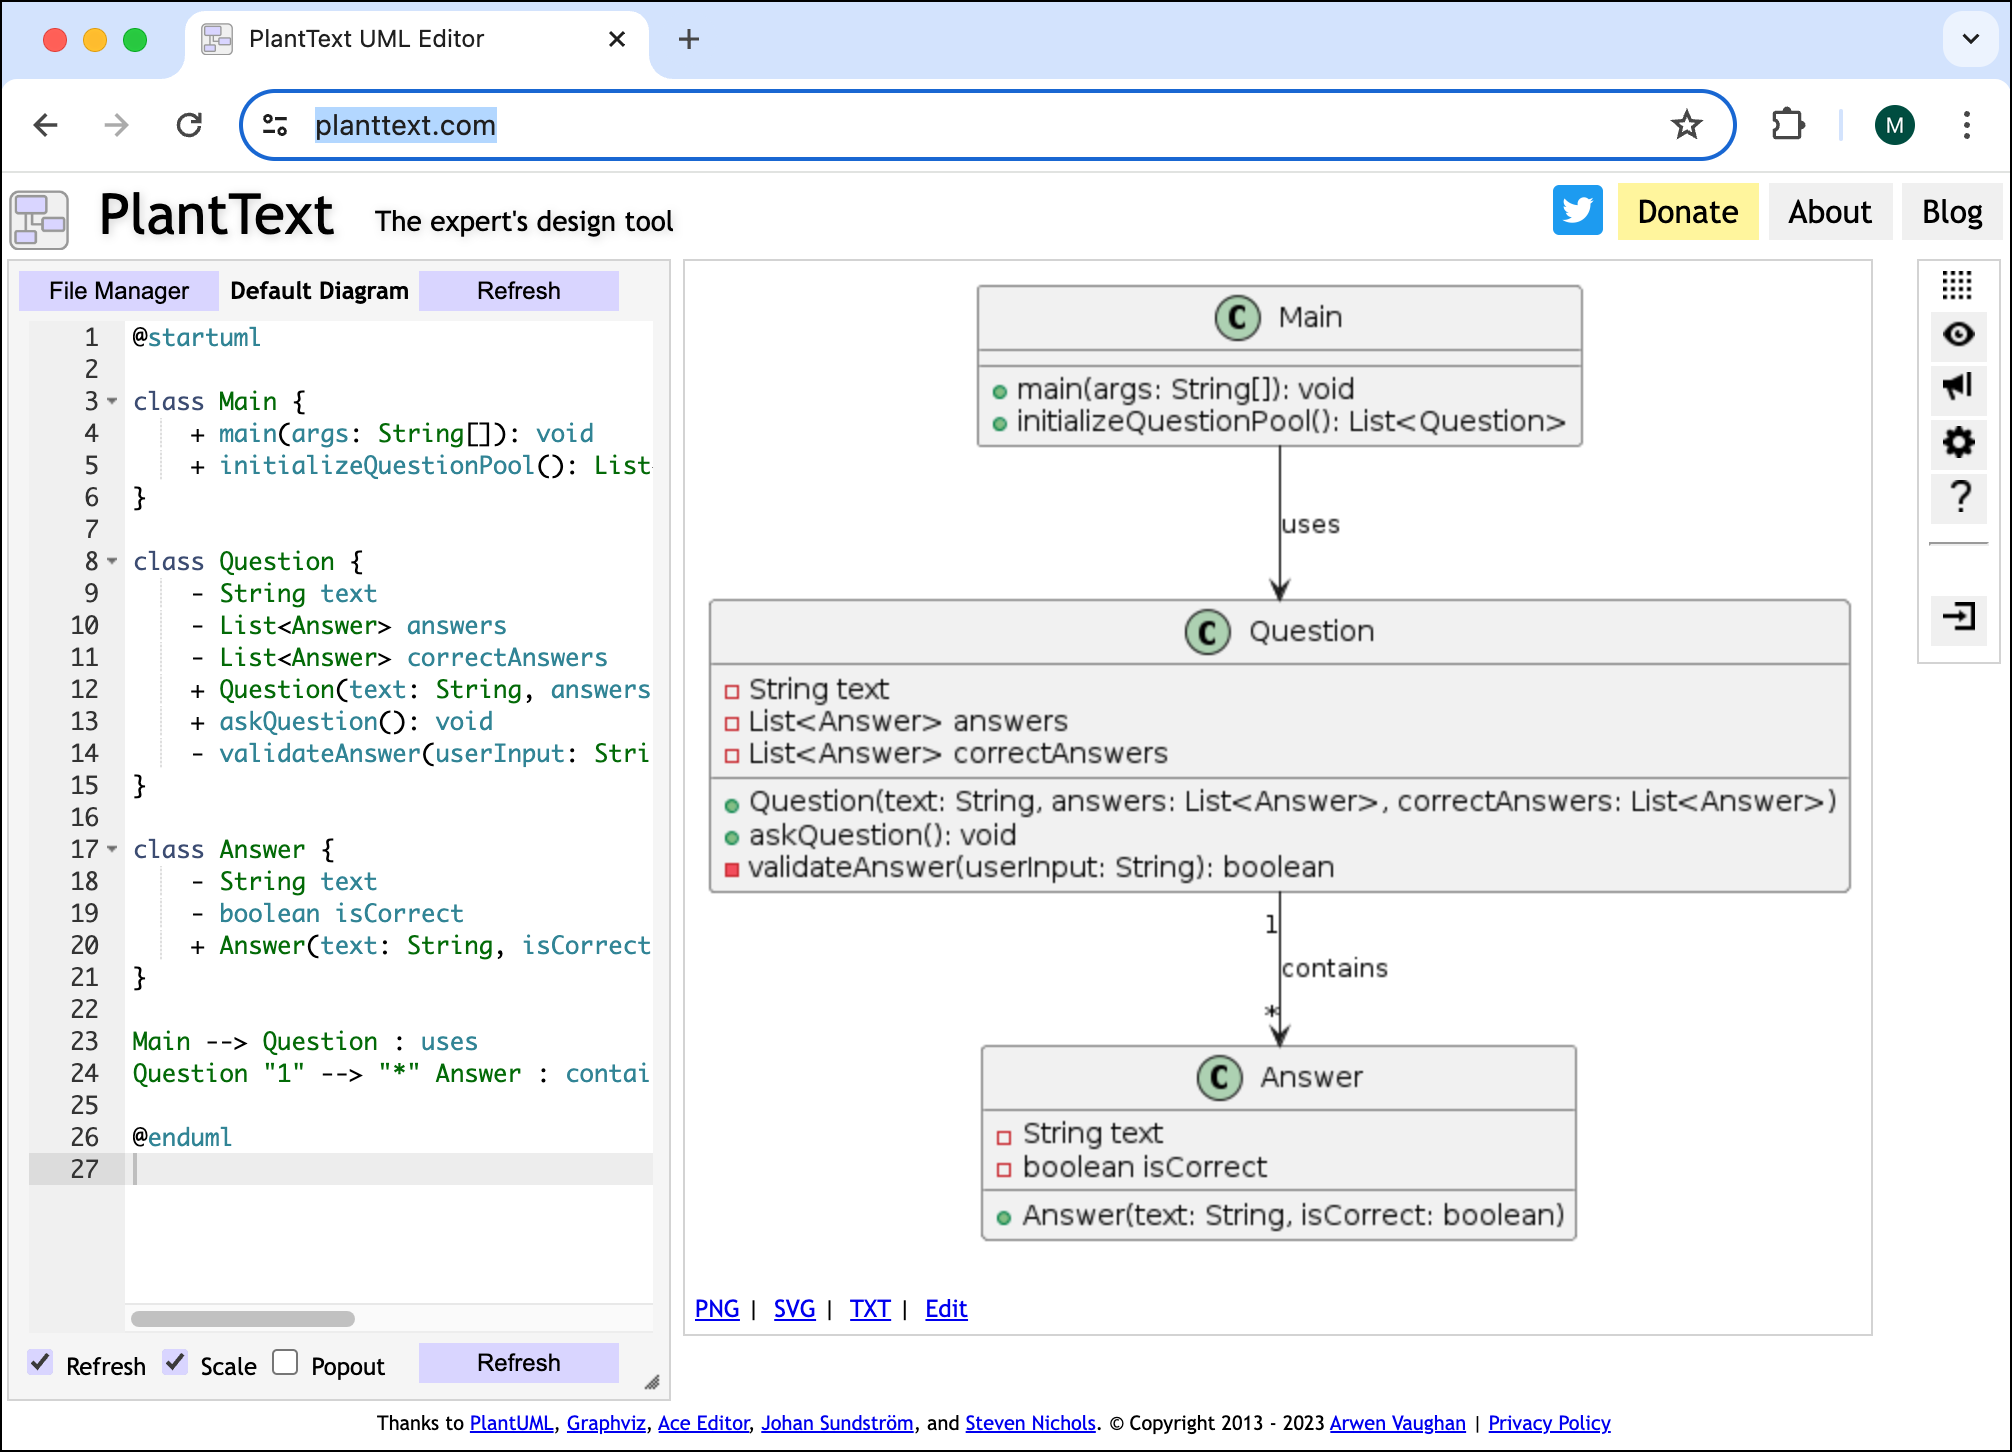
Dabei war ChatGPT schon damals in der Lage, PlantUML- oder Mermaid-Code zu liefern. Der Prompt Please generate PlantUML code instead liefert brauchbaren Code, der dann in https://www.planttext.com/ visualisiert werden kann. Das sieht dann so aus:

ChatGPT lieferte den Code für das UML-Diagramm, planttext.com visualisiert ihn

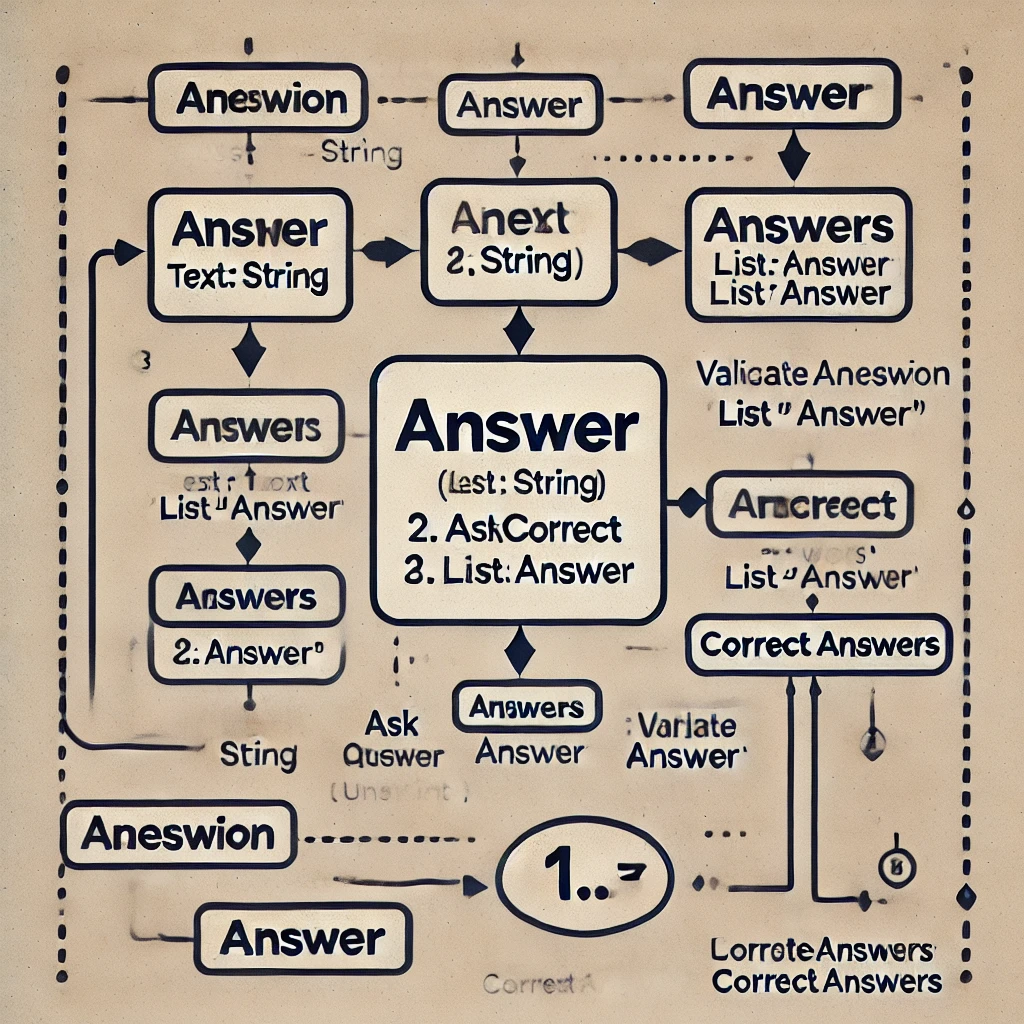
Heute habe ich das ganze Beispiel noch einmal ausprobiert. Ich habe also den Java-Code für zwei Klassen an ChatGPT übergeben und um ein UML-Diagramm gebeten. Vorbei sind die ASCII-Zeiten. Das Ergebnis sieht jetzt so aus:

ChatGPT nennt diesen von DALL-E produzierten Irrsinn ein »UML-Diagramm«
Etwas mehr Kontext zum obigen Diagramm

Leider kann ich hier keinen Link zum ganzen Chat-Verlauf angeben, weil ChatGPT anscheinend nur reine Text-Chat-Verläufe teilen kann.

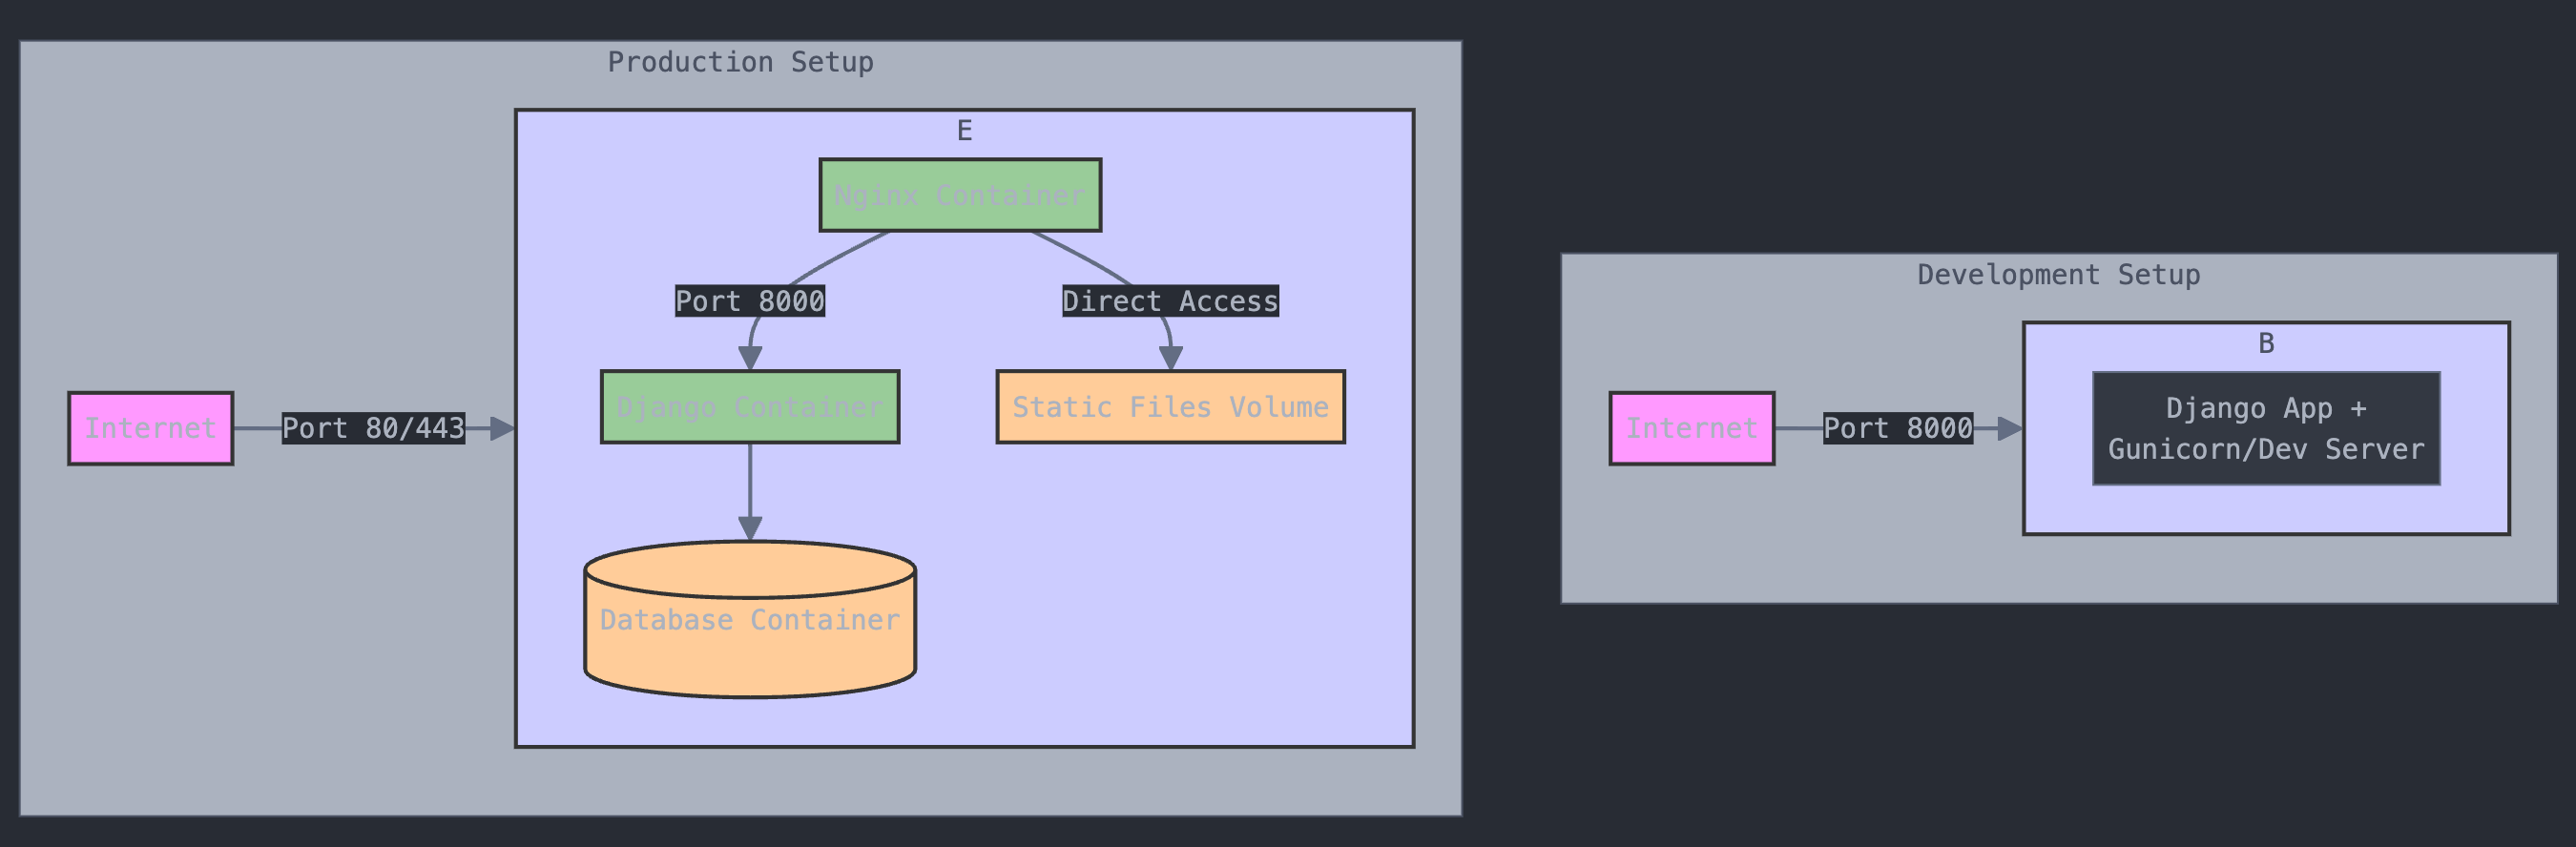
Visualisierung eines Docker-Setups

Beispiel zwei ergibt sich aus zwei Prompts:

Prompt: I want to build a REST application using Python and Django. The application will run in a Docker container. Do I need a proxy server in this case to make my application visible to the internet?

Prompt: Can you visualize the setup in a diagram?

In der Vergangenheit (Mitte 2024) lieferte ChatGPT das Diagramm als ASCII-Art.

+---------------------------+
|      Client Browser       |
+-----------+---------------+
            |
            v
+-----------+---------------+
|       Nginx Reverse Proxy |
|  (Handles SSL, Load       |
|   Balancing, etc.)        |
+-----------+---------------+
            |
            v
+-----------+----------------+
| Docker Container Network   |
|                            |
|  +----------+   +---------+|
|  |  Web     |   |  DB     ||
|  | Container|   |Container||
|  +----------+   +---------+|
|   (Django)       (Postgres)|
+----------------------------+

Erst auf die explizite Bitte liefert es auch Mermaid-Code, der dann unter https://mermaid.live/ gezeichnet werden kann.

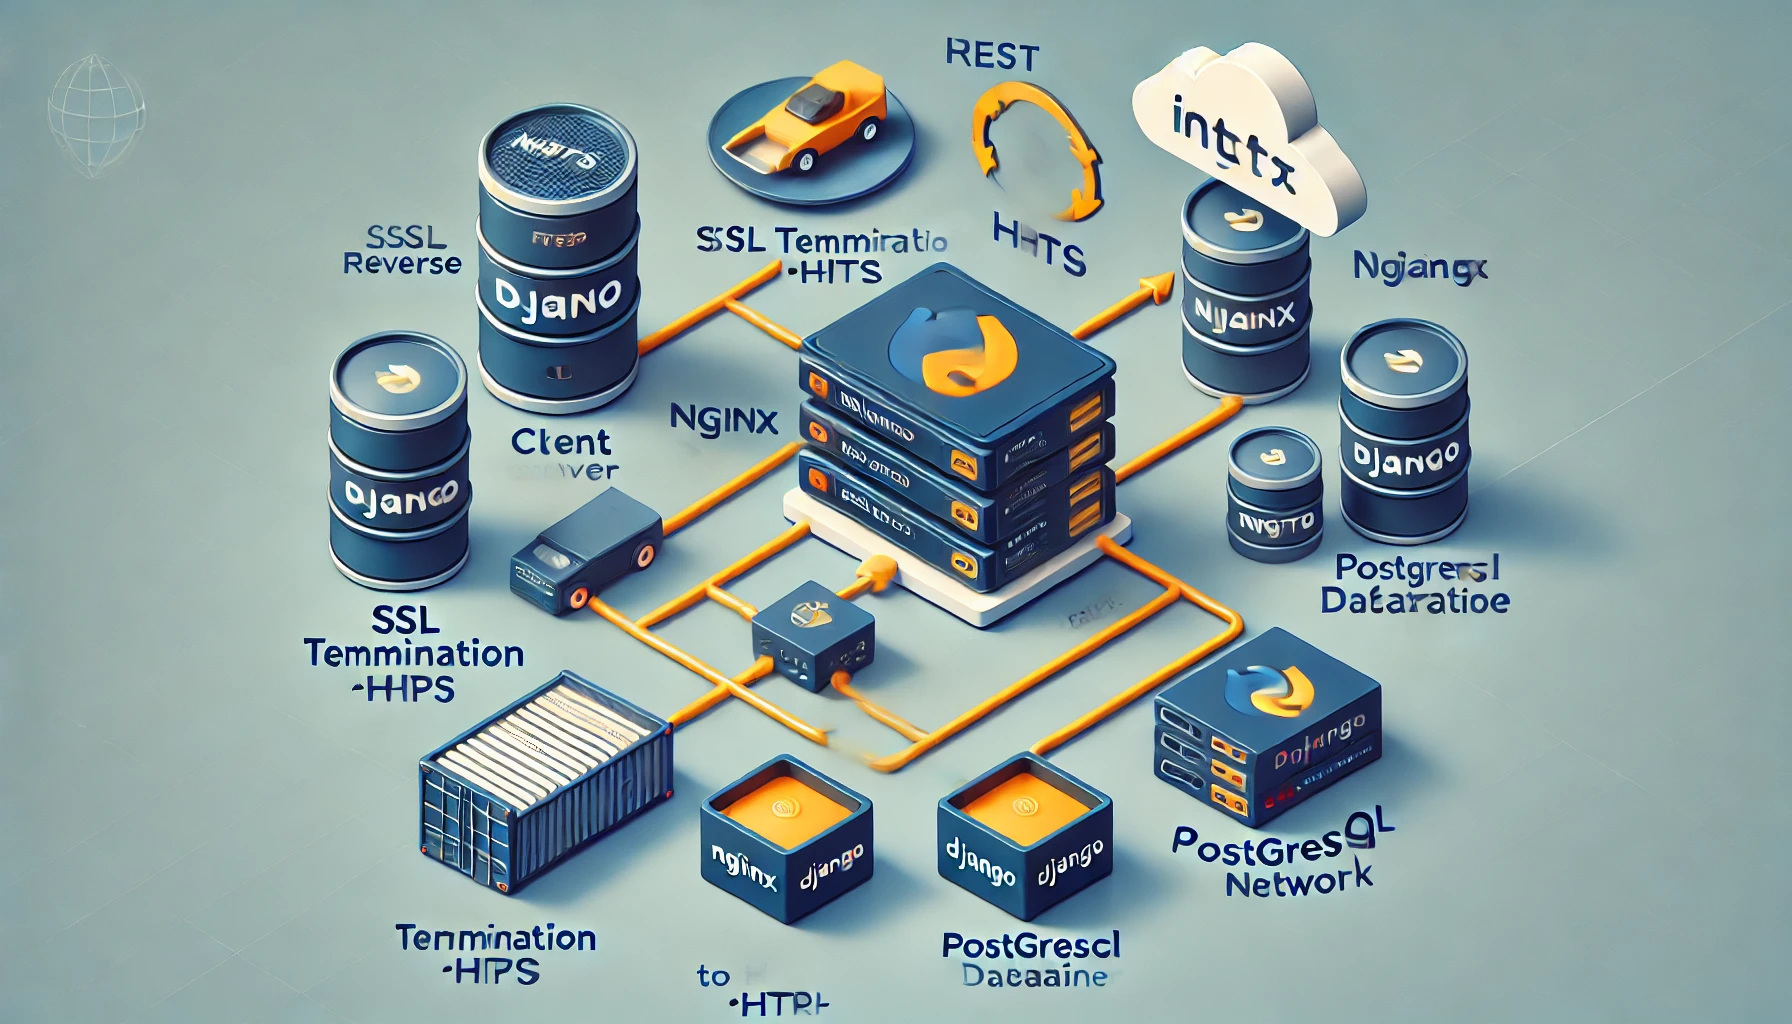
Heute (Dez. 2024) gibt sich ChatGPT nicht mehr mit ASCII-Art ab sondern leitet den Diagrammwunsch an DALL-E weiter. Das Ergebnis ist eine Katastrophe.

ChatGPT’s jämmerlicher Versuch, ein einfaches Docker-Setup zu visualisieren

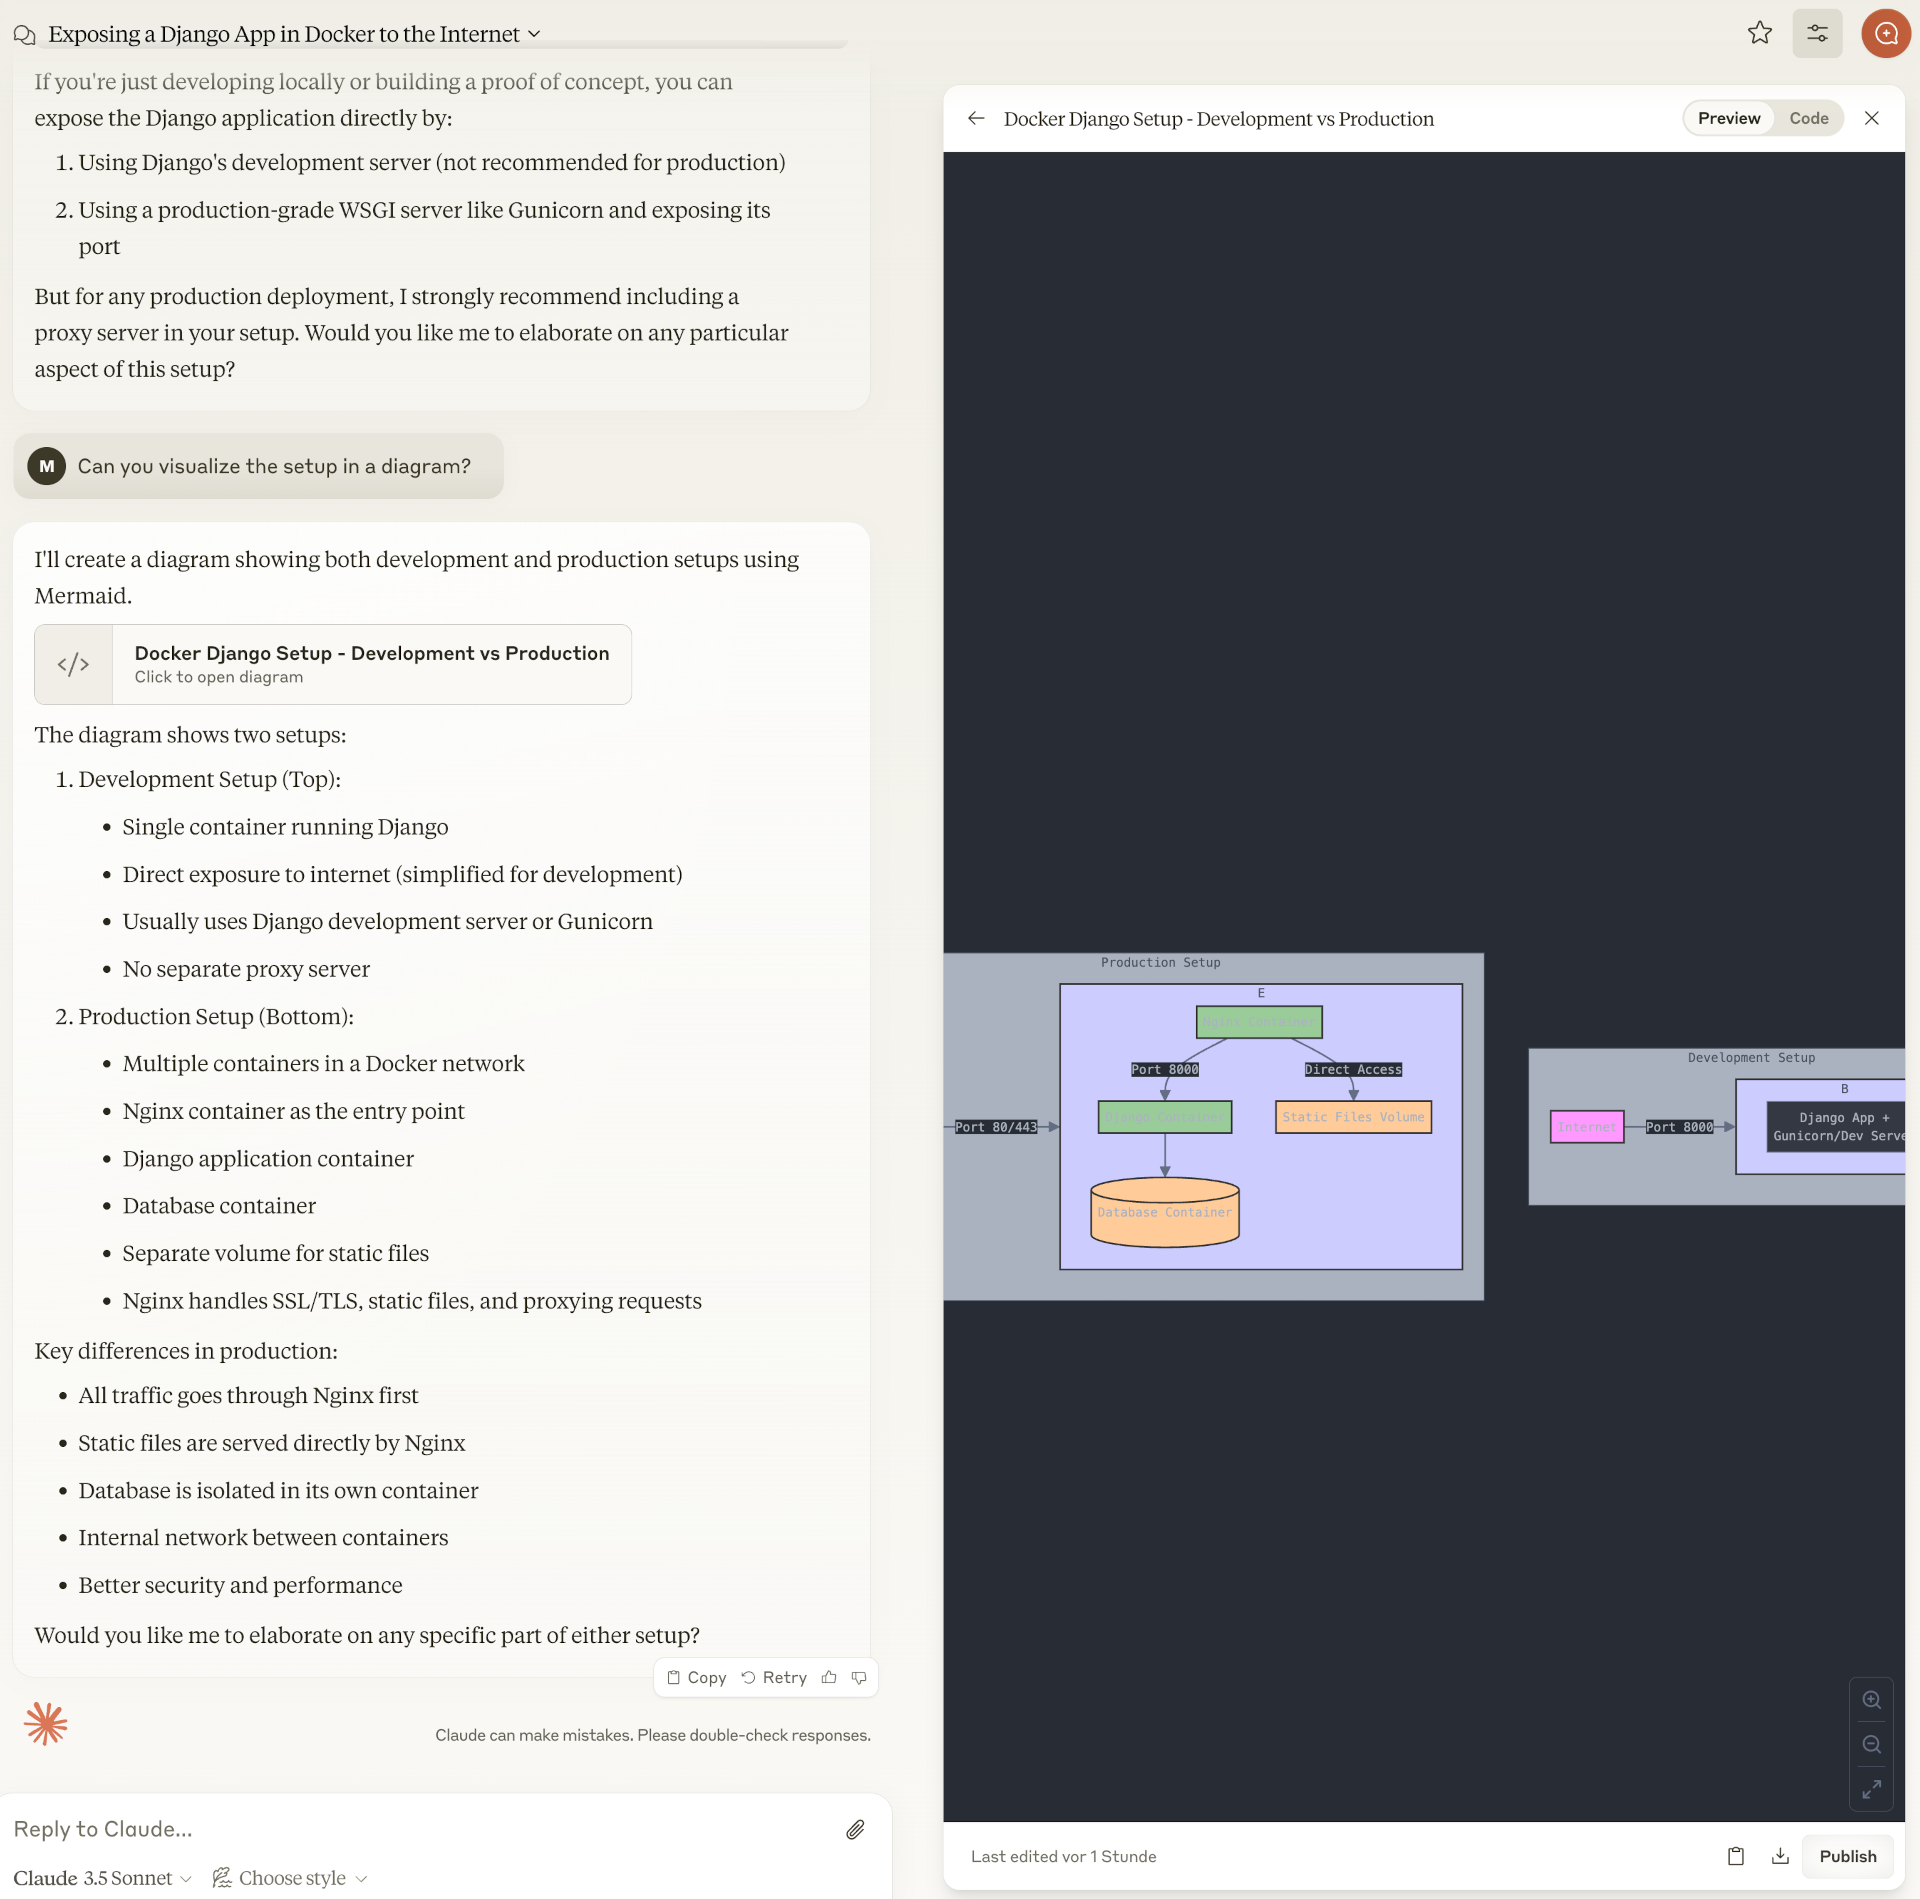
Auch Claude.ai zeichnet selbstbewusst ein Diagramm des Docker-Setups. Dabei wird intern Mermaid verwendet.

Claude leidet offensichtlich unter bedrohlichen Farbstörungen, aber inhaltlich ist das Ergebnis besser als bei ChatGPT
Hier der relevante Teil des Chat-Verlaufs mit Claude

Fazit

Die Diagramme haben durchaus einen hohen Unterhaltungswert. Aber offensichtlich wird es noch ein wenig dauern, bis KI-Tools brauchbare technische Diagramme zeichnen können. Der Ansatz von Claude wirkt dabei erfolgsversprechender. Technische Diagramme mit DALL-E zu erstellen wollen ist doch eine sehr gewagte Idee von OpenAI.

Die besten Ergebnisse erzielen Sie weiterhin, wenn Sie ChatGPT, Claude oder das KI-Tool Ihrer Wahl explizit um Code in PlantUML oder Mermaid bitten. Den Code können Sie dann selbst visualisieren und bei Bedarf auch weiter optimieren.

InstructLab: Das erste Training ist beendet

10. Juni 2024 um 05:00

Dies ist die Fortsetzung von „Mit InstructLab zu Large Language Models beitragen“. Hier beschreibe ich, wie es nach dem Training weitergeht.

Das Training auf einer virtuellen Maschine mit Fedora 40 Server, 10 CPU-Threads und 32 GB RAM dauerte 180 Std. 44 Min. 7 Sek. Ich halte an dieser Stelle fest, ohne GPU-Beschleunigung fehlt es mir persönlich an Geduld. So macht das Training keinen Spaß.

Nach dem Training mit ilab train findet man ein brandneues LLM auf dem eigenen System:

(venv) tronde@instructlab:~/src/instructlab$ ls -ltrh models
total 18G
-rw-r--r--. 1 tronde tronde 4.1G May 28 20:34 merlinite-7b-lab-Q4_K_M.gguf
-rw-r--r--. 1 tronde tronde  14G Jun  6 12:07 ggml-model-f16.gguf

Test des neuen Modells

Den Chat mit dem LLM starte ich mit dem Befehl ilab chat -m models/ggml-model-f16.gguf. Das folgende Bild zeigt zwei Chats mit jeweils unterschiedlichem Ergebnis:

Das Bild zeigt zwei Chats mit dem neuen LLM. Es ist zu sehen, dass es zu zwei unterschiedlichen Ausgaben kommt, von denen keine die richtige Antwort liefert.
Zwei Chats mit dem frisch trainierten LLM. Beide Male erhalte ich nicht die erhoffte Antwort.

Fazit

Schade, das hat nicht so funktioniert, wie ich mir das vorgestellt habe. Es kommt weiterhin zu KI-Halluzinationen und nur gelegentlich gesteht das LLM seine Unkenntnis bzw. seine Unsicherheit ein.

Für mich sind damit 180 Stunden Rechenzeit verschwendet. Ich werde bis auf Weiteres keine Trainings ohne Beschleuniger-Karten mehr durchführen. Jedoch werde ich mir von Zeit zu Zeit aktualisierte Releases der verfügbaren Modelle herunterladen und diesen Fragen stellen, deren Antworten ich bereits kenne.

Wenn sich mir die Gelegenheit bietet, diesen Versuch auf einem Rechner mit entsprechender GPU-Hardware zu wiederholen, werde ich die Erkenntnisse hier im Blog teilen.

Jahresrückblick 2023: Open Source in einer neuen Dimension

31. Dezember 2023 um 22:30

Es ist der 31.12.2023 und somit wird es wieder Zeit für den traditionellen Jahresrückblick. Dieses Jahr dominierten zwei Buchstaben: KI. Die Veröffentlichung von ChatGPT erfolgte zwar kurz vor 2023, in diesem Jahr wurden allerdings die Auswirkungen sichtbar. Ich muss sagen, dass es lange kein Werkzeug gab, an dem ich so viel Experimentierfreude erleben konnte.

Dabei ist die Mensch-Maschine-Schnittstelle besonders spannend. Die natürlichsprachliche Interaktion verbessert nicht nur die Zugänglichkeit, sondern erhöht auch die Interoperabilität: Das Werkzeug kann nicht nur die Aufgabe verstehen, sondern die Ergebnisse in der gewünschten Form darstellen. Schreibe ich eine Software, erfüllt sie nur einen Zweck. ChatGPT kann besonders einfach an neue Aufgabenbereiche angepasst werden. Man muss nicht einmal im klassischen Sinne "programmieren". Somit wird die Arbeit mit dem Computer auf eine ganz neue Stufe gehoben.

Auf die technische Ebene möchte ich heute gar nicht direkt eingehen, das haben wir das Jahr schon im Detail in diesem Blog ergründet. Diskussionen über Technik und Innovationen stellen nur eine Augenblickaufnahme dar. Im Rückblick auf eine größere Zeitepisode wie ein mindestens Jahr werden allerdings gesellschaftliche Entwicklungen deutlich. Und hier gab es einiges zu beobachten.

KI für die Massen

ChatGPT hat eine große Nutzerbasis erreicht, die zumindest ein Mal das Werkzeug ausprobiert hat. Im deutschsprachigen Raum, der sonst sich so "datenschutzorientiert" und innovationskritisch gibt, ist das schon bemerkenswert. Diskussionen über Datenschutz waren zweitrangig, die Menschen waren von der Innovation durch das Werkzeug fasziniert. Natürlich kam über das Jahr die Erkenntnis, dass in der aktuellen Form die Technologie je nach Branche noch nicht weit genug ausgereift ist, trotzdem wollte jeder einmal schauen, was es damit auf sich hat und ob es den Alltag erleichtern kann.

Und doch hat OpenAIs Werkzeug in meinen Augen ein wenig den Blick verengt: Durch das schnelle Wachstum wurde ChatGPT zum Sinnbild von "KI" und hat Ängste geschürt. Denn einerseits will jeder, dass KI ihm das Leben einfacher macht, jedoch nicht, dass andere mit KI ihm seine Lebenssituation verschlechtern bzw. ihn zu einem Umdenken zwingen. Ein Zeitungsredakteur möchte gerne KI für die Verbesserung seiner Texte einsetzen, fürchtet jedoch um seine Jobzukunft, wenn andere ihn durch automatische Generierung ganzer Zeitungsbeiträge drohen, überflüssig zu machen.

Dieser Umstand hat die Diskussion rund um den europäischen AI Act noch einmal deutlich angeheizt. An Large Language Models wurden auf einmal hohe Anforderungen gestellt, um subjektiven Ängsten entgegenzutreten. Dann war man sich aufgrund der Innovationsgeschwindigkeit auf einmal nicht sicher, ob es jetzt schon Zeit für eine starre Regulierung ist. Und schlussendlich zeichnet sich eine politische Entwicklung ab, jetzt lieber irgendeinen Kompromiss als später eine gut ausgearbeitete Fassung präsentieren zu können. Wie der AI Act kommt, werden wir dann im nächsten Jahr sehen.

Das alles war aber nicht das, was dieses Jahr in meinen Augen besonders gemacht hat. Es ist etwas anderes: die neue Rolle von Open Source.

Neue Hürden für Technologie?

Anfang des Jahres sah es so aus, als setzt eine besondere Kommerzialisierung in der Technikwelt ein: die Kommerzialisierung von Basistechnologie. Über die verschiedenen Jahre haben wir gesehen, dass es für verschiedene Produkte in der IT proprietäre und freie Lösungen gibt. Zwar sind erstere gerne technologisch mitunter überlegen, da die Profitorientierung Anreize setzt, für bestimmte Anwendungszwecke besonders passende Lösungen zu entwickeln. Kostet eine Software Geld, kann der Hersteller Programmierer anstellen, die auch die Features entwickeln, die man ungern freiwillig programmiert. Auf diese Weise entstehen runde Produkte für einen Anwendungszweck.

Freie bzw. zumindest quelloffene Software ermöglicht zumindest aber der Öffentlichkeit, einen Blick in die Funktionsweise zu werfen, um zu sehen, wie etwas funktioniert. Das ist die Grundlage, um Technologie zu verbessern.

In der Welt des maschinellen Lernens entstand allerdings durch die benötigte Compute Power eine hohe Eintrittshürde. Es sah so aus, als wären die Large Language Models nur noch großen Konzernen bzw. gut finanzierten Start-ups vorbehalten, die sich die Trainingspower leisten können. Während die Vorgängersysteme wie GPT-2 noch öffentlich zugänglich waren, wurden gerade Systeme wie GPT-3 und GPT-4, bei denen das Produkt endlich richtig nutzbar wurde, zurückgehalten.

Im Laufe des Frühlings habe ich allerdings vermutet, dass freie Modelle die proprietären outperformen können, weil die öffentliche Zugänglichkeit die Chance eröffnet, dass Experten weltweit mit ihren eigenen Erfahrungen, Eindrücken und ihrem Domänenwissen eine Technologie entwickeln können, die verschlossenen Produkten überlegen ist.

Überraschend war, dass es gerade das AI-Team von Facebook war, das den Stein mit LLaMA ins Rollen gebracht hat. Es folgten zahlreiche weitere Abkömmlinge, Weiterentwicklungen oder gänzliche Alternativansätze, die eines gemein hatten: ihr Kern mit den Gewichten war zugänglich.

Wie es aussieht, könnte die Dominanz proprietärer Systeme gebrochen werden, sodass auch die Möglichkeit gewahrt bleibt, einen wissenschaftlichen Diskurs zu führen. Technische Berichte proprietärer Modelle sind zwar nett, aber die Forschungsarbeiten, in denen reproduzierbare Fortschritte aufgezeigt werden, bringen uns tatsächlich eher voran.

Um die rasante Entwicklung im Frühling, als scheinbar jedes KI-Team großer Konzerne und Forschungseinrichtungen alle in der Schublade angesammelten LLM-Projekte zu veröffentlichen versuchte, im Auge zu behalten, habe ich die LLM-Timeline entwickelt. Sie wurde vor einigen Tagen wieder aktualisiert und zeigt besonders, wie sehr LLaMA als eines der ersten praktisch verwertbaren Modelle mit offenen Gewichten die Entwicklung beeinflusst hat.

Ein weiteres Projekt, das ich in der Zusammenarbeit mit der Fachhochschule Kiel realisiert habe, war der Podcast KI & Kultur, der generative Modelle aus der Perspektive Kulturschaffender beleuchtet hat.

Was bleibt

Das Jahr hat den 70 Jahre alten Begriff der KI wieder mal in die Massen gebracht. Dabei wird ChatGPT dem Begriff eigentlich gar nicht gerecht, weil es streng genommen relativ dumm ist. Insbesondere beschränkt es die Zustandsfähigkeit nur auf eine Prompt und lernt nicht, während es denkt. Training und Inferenz sind entkoppelt.

Und trotzdem ist es diese natürlichsprachliche Schnittstelle, die es so faszinierend macht. Allerdings ist auch diese Erkenntnis nicht neu und wurde schon vor 55 Jahren mit ELIZA diskutiert.

Erfreulich ist es, dass "Open Source" nicht mehr nur bei Software, sondern in neuen Technologien Anwendung findet. Der Gedanke, dass Technologie zugänglich sein muss, kann so erhalten werden. Und dass es hilft, wenn Wissenschaftler auf der ganzen Welt mit ihrem Wissen beitragen können, sehen wir weiterhin auch in dieser Thematik.

LLMs ermöglichen es, dass wir uns endlich wieder der Mensch-Maschine-Schnittstelle widmen können, die Technologie nutzbar macht. Menschen wollen, dass Technik das Leben einfacher macht. Die bisher begrenzte Rechenleistung hat uns zu Hilfsmitteln wie Displays, Touchscreens oder Tastaturen gezwungen. In den nächsten Jahren können wir schauen, wie wir das überwinden können, um endlich nutzbare Computer zu erhalten, die wirklich was bringen.

Und so ist es schon fast ironisch, dass die naheliegendste Technologie, die in den 2010er-Jahre euphorisch gefeiert wurde, von den LLMs noch wenig profitiert hat: Sprachassistenten. Sie sind überwiegend noch genau so begrenzt und unflexibel wie früher. Hier gibt es einiges zu tun.

Frohes Neues

Abschließend möchte ich meinen Lesern des Blogs und Zuhörern des Podcasts Risikozone sowie KI & Kultur danken, dass ihr den Blog lest, den Podcast hört und regelmäßig Feedback gebt. Ich wünsche euch einen guten Rutsch in das neue Jahr 2024.

Im nächsten Jahr werden wir wieder gemeinsam neue Technologien ergründen und die aktuellen Nachrichten diskutieren. Es wird auch mehr um Grundlagen und Visualisierungen gehen, hierauf freue ich mich schon besonders!

Viel Glück, Gesundheit und Erfolg!

Mistral veröffentlicht freies Sparse-Mixture-of-Experts-LLM

11. Dezember 2023 um 11:22

Das Interessante an den Open-Source-Modellen ist ja, dass sie das umsetzen, was bei den proprietären Modellen gemunkelt wird, aber nicht nachgewiesen werden kann. Mein aktuelles Highlight: Mixture of Experts (MoE).

Im Sommer kamen Behauptungen auf, dass OpenAIs GPT-4 eigentlich aus acht kleineren Modellen besteht, die zusammengeschaltet werden. Dieses Verfahren nennt man auch Ensemble Learning.

Das klassische Beispiel dafür ist Random Forest, wo mehrere Decision Trees parallel zu so einem Ensemble zusammengeschaltet werden. Soll das Ensemble dann eine Klassifikation vornehmen, nimmt jeder Decision Tree mit seinen eigenen Gewichten die Klassifikation vor. Anschließend entscheidet die Mehrheit der Decision Trees im Ensemble, wie das Gesamtmodell nun klassifizieren soll. Analog würde auch eine Regression umgesetzt werden können, als Aggregierungsfunktion kommt dann statt Mehrheitswahl eben sowas wie Mittelwert o. ä. zum Einsatz. Das besondere ist, dass mit Random Forest üblicherweise bessere Vorhersagen erzielt werden können, als mit einem einfachen Decision Tree.

MoE funktioniert in den groben Zügen ähnlich. Es gibt "Experten" (ähnlich wie die Decision Trees bei Random Forest), die dann gewichtet aggregiert werden (Gating). Die Technik ist eigentlich recht alt und viele waren überrascht, dass OpenAI genau so etwas einsetzen soll.

Umso besser, dass Mistral als das europäische LLM-Startup sich der Sache angenommen hat. Anfang des Wochenendes schwirrte schon ein Torrent durchs Netz, heute gibt es dann auch eine offizielle Pressemitteilung zu Mixtral 8x7B. Hierbei handelt es sich um ein "Sparse Mixture of Experts"-Modell (SMoE). Die Gewichte sind wieder offen und unter der Apache 2.0 lizenziert.

Kurz zu den Eckdaten: 32k Token Kontextlänge können verarbeitet werden. Dabei spricht das Modell Englisch, Französisch, Italienisch, Deutsch und Spanisch und wurde auch auf Codegenerierung optimiert. Fine-tuning ist ebenfalls möglich - so wurde bereits eine instruction-following-Variante trainiert.

Im Vergleich zu Llama 2 70B soll es in einer Vielzahl von Benchmarks bessere Ergebnisse abliefern und dabei schneller arbeiten. Die einzelnen Ergebnisse können der Pressemitteilung entnommen werden.

Einen klassischen Downloadlink konnte ich auf die schnelle nicht finden, das Twitter-Profil verweist nur auf die Torrents. Parallel kündigt das Start-up an, einen eigenen Dienst für API-Endpoints anzubieten, sodass ein Deployment auf eigener Infrastruktur nicht mehr zwangsläufig notwendig ist.

Mistral 7B: Fortschrittliches Open-Source-LLM aus Europa

30. September 2023 um 21:20

Das Wettrennen um die Technologieführerschaft der Large Language Models lief größtenteils bisher auf dem amerikanischen Kontinent ab. OpenAI hat das Produkt populär gemacht und Meta AI veröffentlicht den Konkurrenten mit den freien Gewichten. Mit Falcon 40B und 180B gab es allerdings schon Konkurrenz aus Abu Dhabi, zumal mit der gewählten Apache-2.0-Lizenz ein deutlich offenerer Ansatz gewählt wurde.

Als kurz vor dem Sommer das Start-up Mistral aus Paris 105 Millionen Euro eingesammelt hat, waren die Medienberichte zumindest leicht kritisch, da nicht nur das Start-up mit einer gigantischen Finanzierungssumme aus der Taufe gehoben wurde, sondern das Produkt auch noch gar nicht fertig war. Aus der LLM-Sicht ist dies allerdings verständlich, da solche großen Summen schlicht die Voraussetzung sind, um an den Start zu gehen. Schließlich benötigt Training leistungsfähige GPUs und die sind teuer.

Mit dem veröffentlichten Modell Mistral 7B zeigt das Start-up, was es kann. Dabei handelt es sich um ein LLM, das über 7 Mrd. Parameter verfügt und Llama 2 13B in allen und LLaMa 34B in vielen üblichen Benchmarks überbietet: Commonsense Reasoning, World Knowledge, Reading Comprehension, Math, Code, Popular aggregated results. In Codingaufgaben kann die Leistung von CodeLlama 7B erreicht werden.

Das Beste am LLM ist, dass es unter der Apache-2.0-Lizenz steht. Als klassische Open-Source-Lizenz gibt es nicht nur den Forschern und Entwicklern viele Freiheiten, sondern auch eine gewisse Lizenzsicherheit, dass das Modell in freier Software verwendet werden kann.

Ich hatte bereits vor Wochen geschrieben, dass freie Modelle eine gute Möglichkeit sind, um sich als neuer Player auf dem Markt zu profilieren. Diesen Plan verfolgt nicht nur Falcon, sondern nun auch offenbar Mistral. Es ist trotzdem davon auszugehen, dass die 105 Millionen Euro keine "Forschungsspende" waren und kommerzielle Produkte zeitnah folgen werden.

Für die Forscher und Entwickler von LLMs hat die aktuelle Veröffentlichung nichtsdestotrotz Vorteile. Meta AI hat mit der Lizenzgebung von Llama 2 auf die Open-Source-Bewegung in der LLM-Welt reagiert und sein aktuelles Modell unter eine permissive, aber trotzdem proprietäre Lizenz gestellt. Mistral geht allerdings noch einen Schritt weiter und setzt eine "klassische" Open-Source-Lizenz ein. Das hat nicht nur Signalwirkung, sondern ermöglicht, dass Unternehmen ihre LLM-Lösungen zunehmend privat hosten können, da die Parameteranzahl mit 7 Mrd. so dimensioniert ist, dass auch kleinere Datacenter-GPUs für die Ausführung bzw. Inferenz ausreichen. Es bleibt also weiterhin spannend im Umfeld der LLMs.

Die Mistral-7B-Modelle sind in Version 0.1 auf HuggingFace als normales Modell und als auf Chats spezialisiertes Modell (Instruct) verfügbar.

❌