Bevor LineageOS, eine auf Android basierende Distribution für Mobilgeräte, im Dezember sein zehnjähriges Jubiläum feiert, ist das Release LineageOS 24 für die Entwickler ein weiterer Schritt nach…
Flathub erlaubt wieder Anwendungen, die mit KI-generierten Inhalten entwickelt wurden. Statt eines pauschalen Verbots müssen Entwickler künftig offenlegen, welche Bestandteile ihrer Einreichung mithilfe künstlicher Intelligenz entstanden sind und welchen Umfang diese haben. Über die Aufnahme entscheidet weiterhin das Flathub-Team, das Anwendungen bei Qualitätsbedenken oder erschwerter Wartbarkeit ablehnen kann. Noch im Mai hatte das Flatpak-Repository eine […]
Der Linux-Kernel könnte künftig auch im sogenannten Lockdown-Modus den Ruhezustand unterstützen. Derzeit ist die Funktion aus Sicherheitsgründen deaktiviert, wenn der Kernel über UEFI Secure Boot gestartet wurde oder der Administrator den Lockdown-Modus manuell aktiviert hat. Neue, von Matthew Garrett bei NVIDIA vorgeschlagene Patches sollen diese Einschränkung überwinden, ohne die damit verbundenen Sicherheitsanforderungen aufzugeben. Der Hintergrund […]
Das Stellaris 16 vereint höchste Leistung für CAD, anspruchsvolle Local-AI-Modelle, Simulationsberechnungen und Gaming mit einer hervorragenden Triple-Fan-Kühlung in einem elegant-robusten Vollaluminiumgehäuse für eine galaktische Balance aus Leistung, Geräuschkomfort und Mobilität.
KI droht, das Geschäftsmodell für proprietäre Software zu verändern. Anhaltspunkte dafür sind Projekte wie ArtCraft, das versucht, Anwendungen wie Photoshop, Premiere Pro oder Microsoft Word durch freie Alternativen zu ersetzen.
Die openDesk-Komponentenhersteller Collabora Productivity, Element, Nordeck, Open-Xchange, Univention und XWiki haben die Open Productivity Software GmbH gegründet.
Wenige Monate nach Veröffentlichung des „Technological Sovereignty Package“ der Europäischen Kommission legt das European Open-Source Consortium (EOSC) den EOS-Bericht zum alternativen Arbeitsplatz vor.
Riga, 12.10.2026 – Die quelloffene Cloud-Office-Lösung ONLYOFFICE veröffentlicht Version 10.0 ihrer Dokumenteneditoren. Zu den wichtigsten Neuerungen zählen integrierte KI-Werkzeuge sowie vier zusätzliche Apps für Wissensmanagement, Formularverarbeitung, Dateiverwaltung und geschützte Zusammenarbeit.
Mozilla hat Firefox Enterprise vorgestellt. Damit können Unternehmen und andere Organisationen Firefox zentral verwalten, die Weitergabe von Daten einschränken und Regeln für die Nutzung von KI festlegen. Professioneller Support ist ebenfalls enthalten.
Mit Firefox Enterprise erweitert Mozilla sein Angebot für Unternehmen und andere Organisationen. Dieses richtet sich vor allem an diejenigen, die besondere Anforderungen an Sicherheit und Datenschutz haben und mehr Kontrolle darüber benötigen, wie der Browser im Arbeitsalltag genutzt wird.
Firefox auf eigener Infrastruktur verwalten
Herzstück von Firefox Enterprise ist eine Verwaltungskonsole, welche auf der eigenen IT-Infrastruktur betrieben wird. Darüber können Administratoren Einstellungen und Zugriffsrechte für die gesamte Organisation, einzelne Gruppen oder bestimmte Nutzer festlegen. Auch Erweiterungen und deren Zugriffsrechte lassen sich zentral steuern.
Dabei entscheidet die Organisation selbst, wo Verwaltungsdaten, Richtlinien und Telemetrie gespeichert werden und welche externen Dienste Firefox kontaktieren darf. Für die Verwaltung ist sie damit nicht auf eine von Mozilla betriebene Infrastruktur angewiesen.
Vorhandene Systeme zur Anmeldung und Sicherheitsüberwachung können eingebunden werden. Beispielsweise lässt sich der Zugriff davon abhängig machen, wer sich anmeldet und ob das verwendete Gerät die Sicherheitsanforderungen erfüllt. Browserereignisse und Änderungen durch Administratoren können an bestehende SIEM-Systeme zur zentralen Sicherheitsüberwachung übermittelt werden.
Auch Mitarbeiter und externe Partner können von firmeneigenen oder privaten Geräten auf bestimmte interne Webanwendungen zugreifen. Dabei lässt sich der Zugriff auf einzelne Anwendungen begrenzen, ohne das gesamte Unternehmensnetzwerk zugänglich zu machen. Für solche Anwendungsfälle soll Firefox Enterprise den Bedarf an VPN-Verbindungen oder virtuellen Desktops reduzieren.
Datenweitergabe und KI-Nutzung einschränken
Firefox Enterprise enthält Funktionen zur sogenannten Data Loss Prevention, kurz DLP. Damit lässt sich beispielsweise festlegen, dass auf bestimmten Domains keine Dateien hochgeladen oder Inhalte per Kopieren und Einfügen übertragen werden dürfen. Je nach Regel kann Firefox eine Warnung anzeigen oder die Aktion blockieren. Auch Downloads lassen sich auf diese Weise kontrollieren. Bereits eingesetzte DLP-Lösungen können ebenfalls eingebunden werden.
Für KI-Dienste können Organisationen festlegen, welche erlaubt, eingeschränkt oder gesperrt sind. Die KI-Funktionen des Browsers lassen sich auch vollständig deaktivieren. So können Unternehmen beispielsweise verhindern, dass vertrauliche Informationen über nicht freigegebene KI-Dienste weitergegeben werden.
Über den „Lockdown Mode” können festgelegte Websites in einer besonders abgesicherten Browserumgebung geöffnet werden. Dabei lassen sich unter anderem Downloads, die Zwischenablage, Entwicklerwerkzeuge und bestimmte Web-APIs einschränken. Die Verarbeitung erfolgt direkt im Browser, ohne die Inhalte auf einem entfernten Server rendern zu müssen. Außerdem nennt Mozilla zentral verwaltete Sicherheitsupdates als Bestandteil des Angebots.
Abonnement inklusive Support
Firefox Enterprise ist ein kostenpflichtiges Angebot im Abonnement. Enthalten ist der Standard-Tarif von Firefox Professional Support. Darüber erhalten IT-Teams direkten Zugang zu Firefox-Experten bei Mozilla, definierte Reaktionszeiten und Unterstützung bei Einrichtung, Richtlinien und Updates.
Ein optionaler Premium-Tarif bietet unter anderem einen festen technischen Ansprechpartner und regelmäßige Abstimmungstermine. Wer den regulären Firefox im Unternehmen einsetzt, kann Firefox Professional Support auch separat buchen.
Konkrete Preise nennt Mozilla nicht. Interessierte Organisationen können eine Demo anfordern oder den Vertrieb kontaktieren.
Zum Start ist Firefox Enterprise europaweit verfügbar. Der Vertrieb konzentriert sich zunächst auf Deutschland, Österreich, die Schweiz und Frankreich. Weitere Märkte sollen folgen.
Auch Thunderbird Enterprise geplant
Mozilla arbeitet außerdem an Thunderbird Enterprise. Darüber sollen künftig auch E-Mails, Kalender und Kontakte über die Verwaltungskonsole von Firefox Enterprise zentral verwaltet werden können. Einen Veröffentlichungstermin gibt es dafür noch nicht.
Canonical erweitert die Unterstützung für die offene Prozessorarchitektur RISC-V: Mit Ubuntu 26.10 „Stonking Stingray“ stehen erstmals offiziell angekündigte Desktop-Images für diese Plattform bereit. Zusätzlich gibt es experimentelle Minimal-Images von Xubuntu, die auf die schlanke Desktop-Umgebung Xfce setzen. Die Veröffentlichung markiert einen weiteren Schritt, um Ubuntu auch auf Rechnern jenseits der etablierten x86- und ARM-Plattformen nutzbar […]
KDE hat Frameworks 6.31 veröffentlicht. Das monatliche Update der auf Qt basierenden Bibliothekssammlung bringt zahlreiche Fehlerkorrekturen und Verbesserungen für KDE Plasma sowie Anwendungen wie Kate und KWrite. Im Mittelpunkt stehen eine zuverlässigere Dateiverwaltung, eine verbesserte Erkennung von Textkodierungen und Anpassungen an verschiedenen Benutzeroberflächen. Besonders umfangreich fallen die Änderungen bei KIO aus, das für Dateioperationen zuständig […]
Wolvic, der Browser für Virtual und Mixed Reality, wurde in der Version 1.10 veröffentlicht und aktualisiert unter anderem die verwendete Version der GeckoView-Engine von Mozilla.
Igalia hat Wolvic 1.10 veröffentlicht. Bei Wolvic handelt es sich um einen Browser für Virtual und Mixed Reality, welcher auf dem eingestellten Firefox Reality basiert.
Neuerungen von Wolvic 1.10
Wolvic 1.10 aktualisiert die verwendete GeckoView-Engine von Mozilla von GeckoView ESR 140 auf GeckoView ESR 153. Nutzer profitieren vor allem durch eine verbesserte Webkompatibilität.
Verbessert wurde die Wiedergabe von VR-Videos. Stereoskopische 180- und 360-Grad-Videos werden nun korrekt mit unterschiedlichen Ansichten für beide Augen dargestellt. Außerdem werden 3D-Videos im Full-SBS-Format unterstützt. Bei 180-Grad-Videos befindet sich die Bildfläche jetzt mittig vor dem Nutzer. Der Speicherverbrauch bei immersiven 4K-Videos wurde nach Angaben von Igalia um ungefähr 60 Prozent reduziert.
Auch das Verschieben von Fenstern funktioniert jetzt zuverlässiger. Ungewollte Positionssprünge wurden behoben und der Mauszeiger wird während des Verschiebens ausgeblendet. Außerdem lässt sich der Abstand eines Fensters wieder durch das Vor- und Zurückbewegen des Controllers verändern.
Die Tab-Übersicht bietet eine neue Schaltfläche zum Schließen aller anderen Tabs. Downloads von derselben URL sind jetzt mehrfach möglich. Ein abgebrochener Download verhindert nicht länger den Start weiterer Downloads.
Weitere Verbesserungen betreffen die Anmeldung mit einem Mozilla-Konto sowie die Barrierefreiheit der Einstellungs- und Sprachdialoge. Außerdem wurde ein Fehler behoben, durch den die eingestellte Suchmaschine ignoriert werden konnte. Auf Lynx-Geräten lässt sich Wolvic nun auch per Sideloading installieren.
Dies war nur eine Auswahl der größten Highlights. Dazu kommt wie immer eine Reihe weiterer Korrekturen und Verbesserungen unter der Haube sowie zusätzliche Umgebungen.
Die digitale Transformation der Kommunen ist eine zentrale Voraussetzung für eine leistungsfähige, resiliente und souveräne öffentliche Verwaltung. Open Source, offene Standards und interoperable Architekturen können dazu beitragen, Abhängigkeiten von einzelnen Anbietern zu reduzieren, Innovation und Nachnutzung zu fördern und Wettbewerb und lokale Wertschöpfung zu stärken. Die Working Group „Open Source in Kommunen“ innerhalb der Open […]
System76 hat COSMIC Desktop 1.10 veröffentlicht. Das Update der in Rust entwickelten und auf Wayland ausgerichteten Desktop-Umgebung bringt Verbesserungen bei der Leistung, der Anwendungsverwaltung und den Systemeinstellungen. Auch der Fenstermanager, das Terminal und die Ersteinrichtung erhalten neue Funktionen und Fehlerkorrekturen. Besonders deutlich fällt die Überarbeitung des COSMIC Launchers aus. Dieser verwendet nun standardmäßig GPU-beschleunigtes Rendering […]
KDE bereitet die Veröffentlichung von Plasma 6.8 vor, die zeitlich mit dem 30-jährigen Bestehen des KDE-Projekts zusammenfällt. Kurz vor dem Start haben die Entwickler noch mehrere Fehlerkorrekturen umgesetzt. Dazu gehören eine verbesserte Tastaturnavigation im Anwendungsstarter KRunner, zuverlässigere automatische Updates für Flatpak-Anwendungen und eine wichtige Korrektur für Grafiksysteme mit proprietären NVIDIA-Treibern. Besonders relevant ist die Behebung […]
KDE hat mit Gear 26.08.2 ein weiteres Wartungsupdate für seine Anwendungssammlung veröffentlicht. Die zweite Aktualisierung der 26.08-Reihe konzentriert sich auf Fehlerkorrekturen und Stabilitätsverbesserungen. Betroffen sind unter anderem der Videoeditor Kdenlive, der Dateimanager Dolphin, der Dokumentenbetrachter Okular und der Matrix-Client NeoChat. In Kdenlive wurden mehrere Probleme bei der Arbeit mit Proxy-Clips behoben. Ein fehlerhafter Parameter konnte […]
Flatpaks haben sich neben Distributionspaketen als feste Größe im Linux-Ökosystem etabliert. Das gilt im Besonderen für Immutable-Distributionen. Ganz wartungsfrei ist die Alternative jedoch nicht.
Mozilla hat Firefox 157 für Apple iOS veröffentlicht. Dieser Artikel beschreibt die Neuerungen von Firefox 157.
Die Neuerungen von Firefox 157 für Apple iOS
Mozilla hat Firefox 157 für das iPhone, iPad sowie iPod touch veröffentlicht. Die neue Version steht im Apple App Store zum Download bereit. Das Update bringt keine größeren Highlights und beschränkt sich auf Detail-Verbesserungen, Fehlerbehebungen sowie Optimierungen unter der Haube.
Die selbst gehostete Fotoverwaltung Immich bringt in Version 3.3.0 Verbesserungen bei der gemeinsamen Verwaltung erkannter Personen, neue Geburtstagserinnerungen sowie eine effizientere Bilderkennung.
Im Rahmen meiner Arbeit für unser Claude-Code-Buch habe ich wieder einmal durchgetestet, wie weit man mit lokalen Modellen und Open-Source-Tools kommt. Als Coding-Agent habe ich das Programm Pi verwendet, das ich demnächst hier näher vorstellen will. Pi habe ich zusammen mit diversen lokalen Modellen ausprobiert, unter anderem Gemma 4, Qwen-3.6-35b-a3b, Qwen-3.8-27b sowie Qwen-3.8-Flash-Next. Der Testrechner ist mit 128 GB RAM und einer Strix-Halo-CPU ausgestattet.
Um es kurz zu machen: Gemma 4 und Qwen-3.6-35b-a3b sind für agentisches Programmieren einfach zu schwach. Qwen-3.8-27b ist spürbar besser, aber als »dichtes« Modell (dense, immer alle Parameter im Einsatz) mit meiner Hardware definitiv zu langsam. Richtig spannend ist dagegen Qwen-3.8-Flash-Next! Es ist mit 125 Milliarden Parametern das größte und neueste Modell in meinem Testparcours. Dank MoE (Mixture of Experts) sind aber stets »nur« 6 Milliarden Parameter aktiv. Das Modell enthält außerdem eine Look-up-Tabelle für Token-Kombinationen mit weiteren 51 Milliarden Parametern (N-gram Embedding Layer). Die Gesamtmodellgröße wird daher oft mit 180 Milliarden Parametern angegeben. Der Platzbedarf beträgt bei 4-Bit-Quantisierung ca. 110 GB auf der SSD sowie ca. 90 GB im RAM (weniger, weil nur Teile der Look-up-Tabelle tatsächlich im RAM landen). Bei meinen Tests liefert das Modell bessere Ergebnisse als Qwen-3.8-27b und ist gleichzeitig schneller. Eine sehr angenehme Kombination.
Der Rest dieses Artikels beschäftigt sich mit der Frage, welche Möglichkeiten es gibt, Qwen-3.8-Flash-Next auf Strix-Halo-Rechnern auszuführen. Um es vorwegzunehmen: Mein für Testzwecke beliebtes LM Studio ist ungeeignet. Dafür gibt es zwei Projekte, die speziell für die AMD-CPU optimierte Engines anbieten und einen Output von über 40 Token/s erreichen.
LM Studio
LM Studio ist prinzipiell meine erste Wahl, um ein neues Sprachmodell erstmalig auszuprobieren. Tatsächlich gelingt damit die Ausführung von Qwen3.8-Flash-Next-GGUF mit ca. 24 Token/s. Das ist OK, aber weit weg vom theoretischen Maximum. Der Hauptgrund besteht darin, dass es mir (mit meiner Hardware) nicht gelungen ist, MTP zum Laufen zu bringen. Es gibt zwar auf Hugging Face mehrere Qwen-3.8-Flash-Next-Varianten mit inkludierten MTP-Daten, aber die eine Variante läuft gar nicht, bei der nächsten funktioniert MTP nicht und die Token-Rate sinkt auf 12 Token/s etc.
Die Ursache: Diverse Qwen-3.8-Flash-Next-Varianten setzen speziell gepatchte llama.cpp-Versionen voraus. Das Experimentieren damit ist eine Frickelei, die mich an die ersten Linux-Jahre zurückdenken lässt.
Erfreulicherweise gibt es einige Projekte, die sich darauf spezialisiert haben, moderne Sprachmodelle auf Strix-Halo-Hardware bestmöglich auszuführen. Einen guten Überblick gibt dieses YouTube-Video von Donato Capitella. Ich konzentriere mich hier auf Gufo und Halogen.
Gufo
Das Open-Source-Projekt Gufo will einen einfachen Weg anbieten, speziell für die Strix-Halo-CPU optimierte Engines und Sprachmodelle so zu kombinieren, dass diese mit minimalem Aufwand installiert und so effizient wie möglich ausgeführt werden können.
Die Projektseite enthält Anleitungen, wie Gufo als Podman-Container ausgeführt oder mit nix lokal installiert und kompiliert werden kann. Ich habe mich für die Podman-Variante entschieden und setze dieses Container-System im Folgenden voraus. (Unter Fedora ist Podman per Default installiert.)
Die folgenden Kommandos kombinieren Infos aus dem Gufo-Quickstart und dem Qwen-3.8-Flash-Next-Readme mit ein paar Detailkorrekturen. Der Kontext ist auf die Maximalgröße eingestellt. --sessions 2 ermöglicht zwei parallele Sessions. Das kostet zusätzlichen Arbeitsspeicher; außerdem sind zwei parallele Sessions natürlich langsamer. Wenn Sie nur eine Session brauchen, ist --sessions 1 sicherer.
# hf-Kommando installieren
sudo dnf install python3-huggingface-hub

# aktuellen Benutzer zu den Gruppen render
# und video hinzufügen; wird erst in einer
# neuen Shell wirksam
sudo usermod -aG render,video "$USER"

# Arbeitsverzeichnis erstellen
mkdir ~/gufo
cd ~/gufo

# Qwen-3.8-Flash-Next herunterladen (ca. 110 GB); die Dateien
# landen in ~/gufo/models/qwen3.8-flash-next
hf download unsloth/Qwen3.8-Flash-Next-GGUF \
  --revision 38bb39ee97821de2c9009abb7e93950eec396e66 \
  --include "UD-Q4_K_XL/*" \
  --include "MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf" \
  --include "mmproj-BF16.gguf" \
  --local-dir models/qwen3.8-flash-next

# Pfade zu den Modellen in Variablen speichern
export MODEL="$PWD/models/qwen3.8-flash-next/UD-Q4_K_XL/Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf"
export MTP="$PWD/models/qwen3.8-flash-next/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf"

# Gufo-Runtime-Image herunterladen (ca. 5,5 GB)
podman pull ghcr.io/gufo-org/toolboxes/gufo-runtime:latest

# LLM ausführen und auf Port 8080 anbieten
podman run --rm \
  --userns=keep-id:uid=1000,gid=1000 \
  --security-opt label=disable \
  --device /dev/kfd \
  --device /dev/dri \
  --group-add keep-groups \
  --ulimit memlock=-1 \
  -p 127.0.0.1:8080:8080 \
  -v "$(dirname "$(dirname "$MODEL")")":/models:ro \
  ghcr.io/gufo-org/toolboxes/gufo-runtime:latest \
  gufo serve --host 0.0.0.0 --port 8080 llm \
  --model "/models/UD-Q4_K_XL/$(basename "$MODEL")" \
  --speculative mtp \
  --mtp-model "/models/MTP/$(basename "$MTP")" \
  --sessions 2 \
  --context 262144
Mit curl können Sie ausprobieren, ob das Sprachmodell funktioniert:
curl -s http://127.0.0.1:8080/v1/chat/completions \
     -H "Content-Type: application/json" \
     -d '{
           "model": "Qwen3.8 Flash Next",
           "messages": [{"role": "user",
                         "content": "Write a Python function that checks if a string is a palindrome."}],
           "max_tokens": 1000,
           "reasoning_effort": "low"
         }' | jq -r '.choices[0].message.content'

  (Antwort gekürzt ...)
  # Palindrome Checker in Python
  def is_palindrome(s: str) -> bool:
      # Remove non-alphanumeric characters and convert to lowercase
      cleaned = ''.join(ch.lower() for ch in s if ch.isalnum())

      # Compare the string with its reverse
      return cleaned == cleaned[::-1]
Damit der Coding-Agent Pi das Sprachmodell verwendet, tragen Sie den Server in ~/.pi/agent/models.json ein:
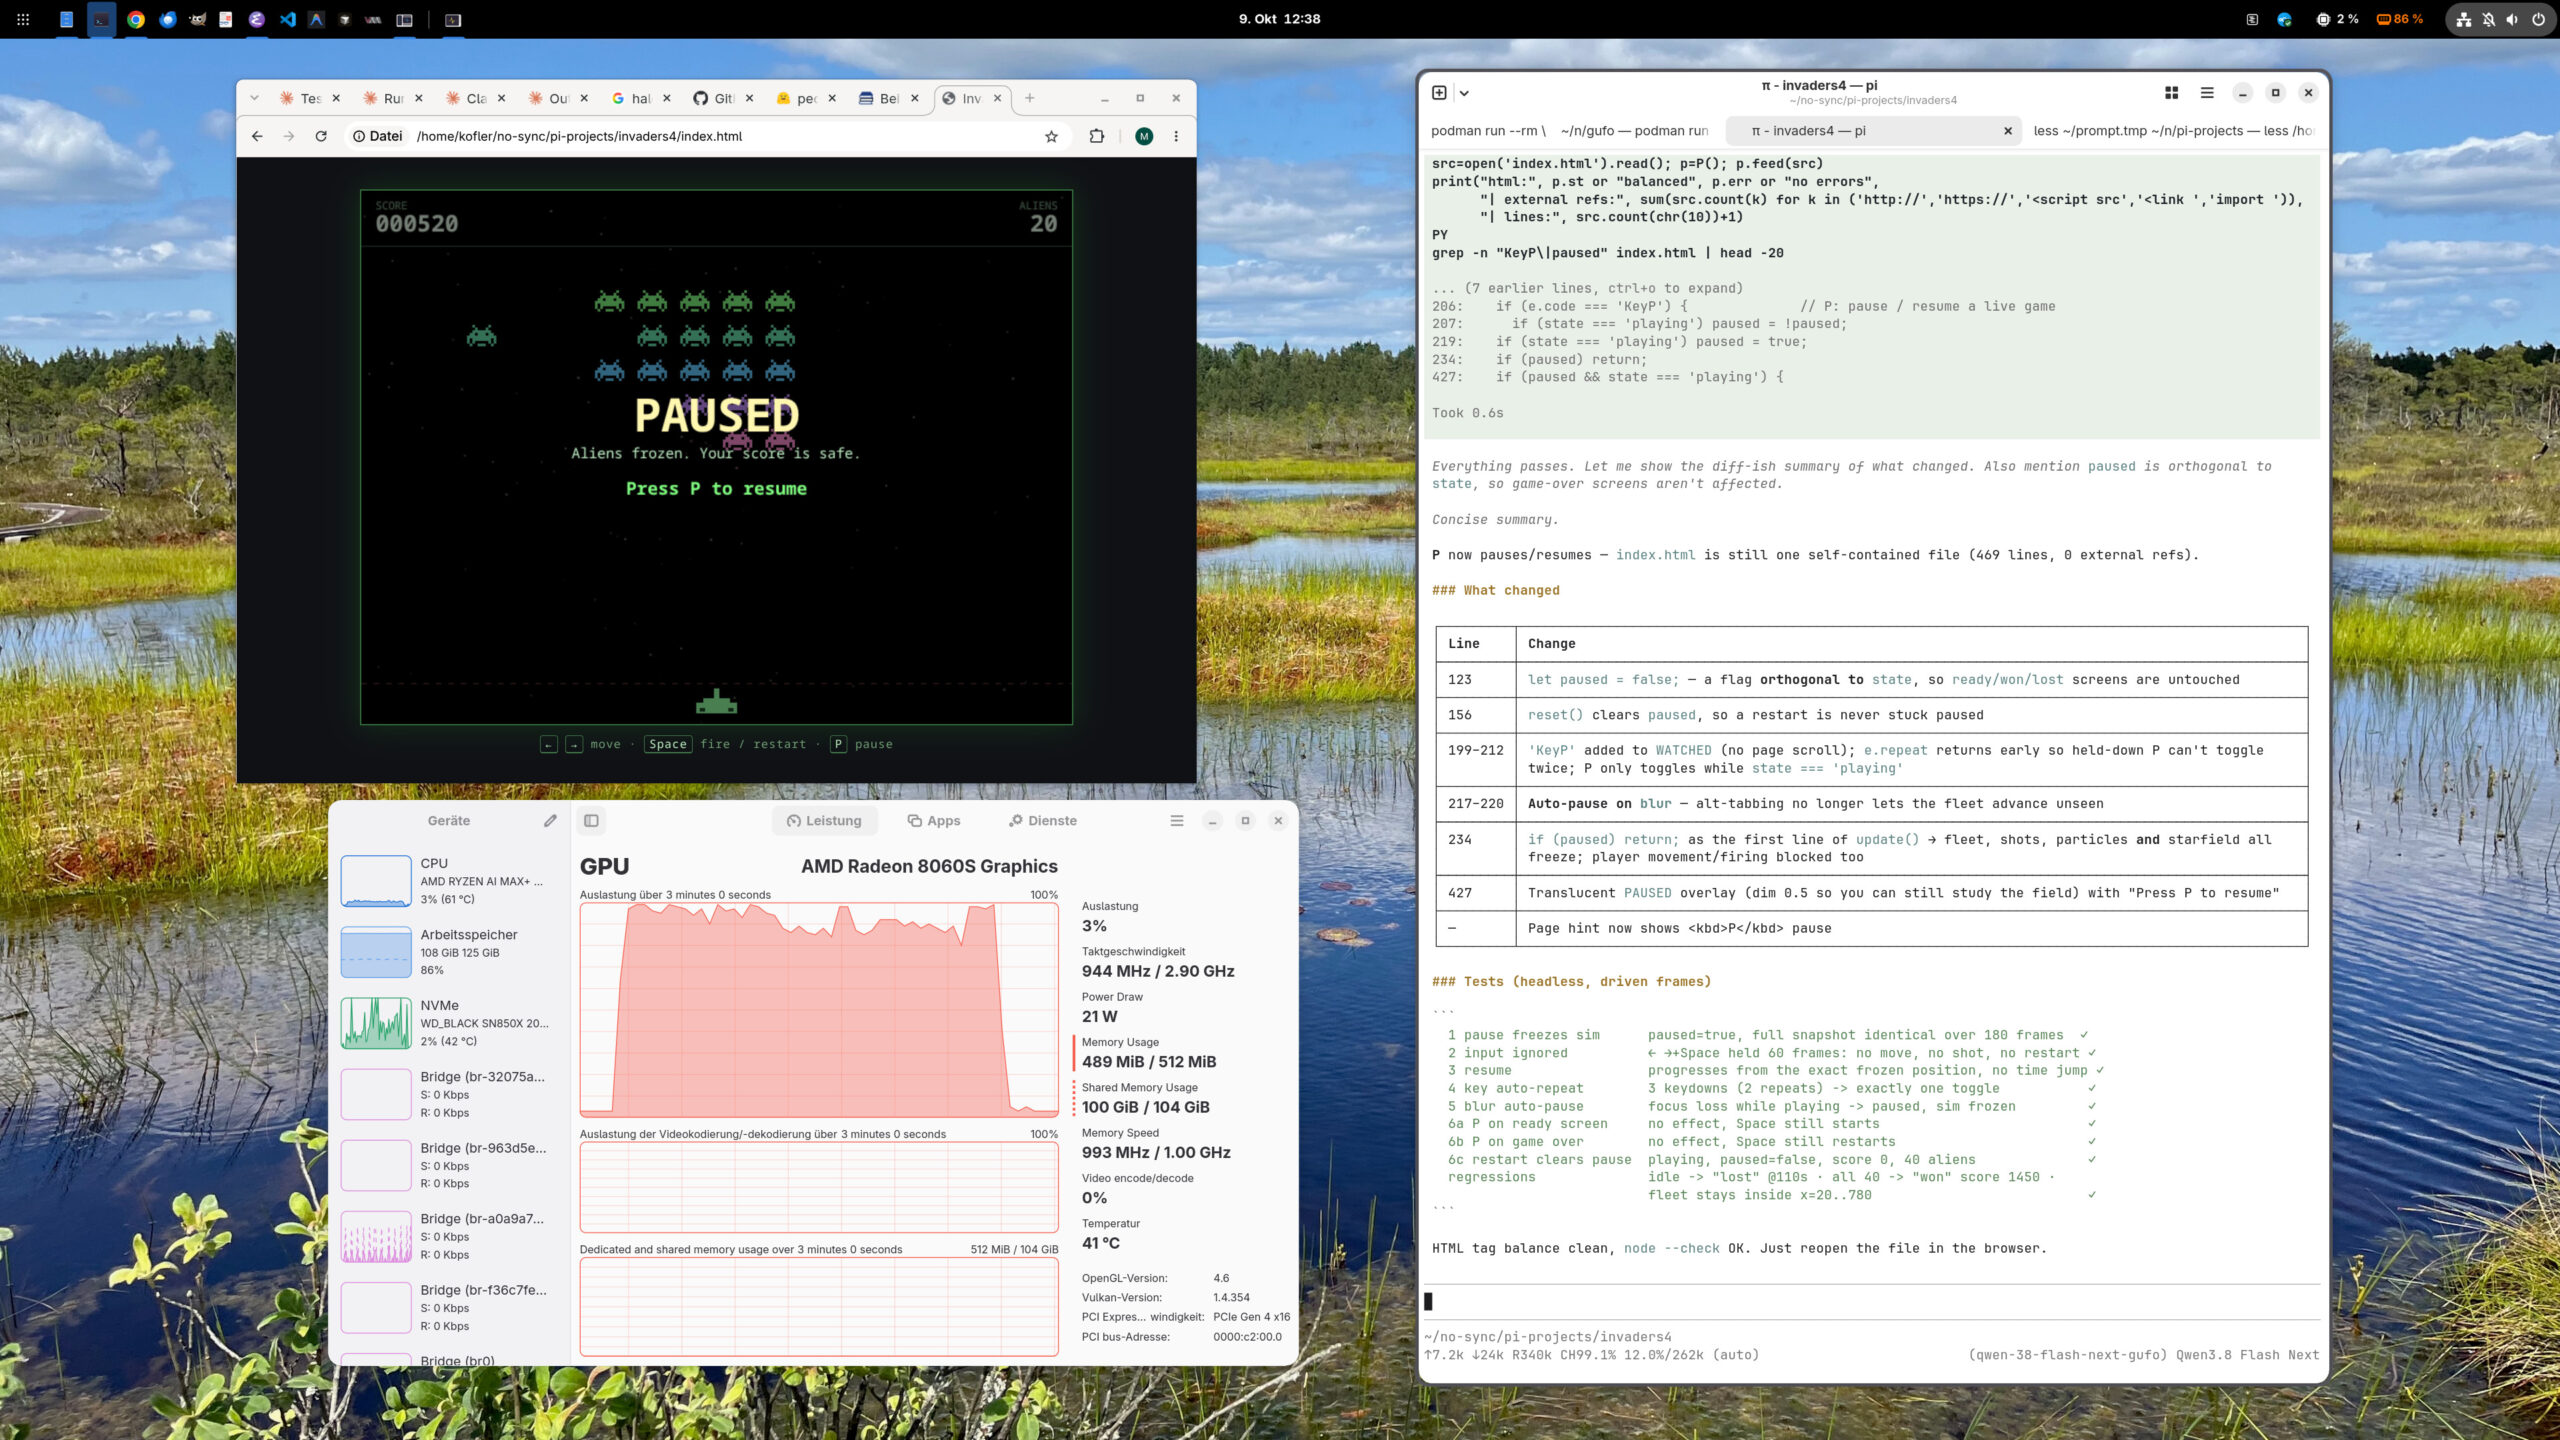
Als Test habe ich Pi aufgefordert, zuerst einen Space-Invaders-Klon zu programmieren und danach eine Pause-Funktion zu implementieren. Dazu waren diese beiden Prompts und ca. 10 Minuten Geduld erforderlich. Der Terminal-Tab mit dem Podman-Container protokollierte Output-Token-Raten zwischen 35 und 50 Token/s, meistens ca. 40 Token/s.
Create a browser game called Invaders in a single file index.html. Plain HTML, CSS and JavaScript, no frameworks, no build step, no dependencies. Use a canvas size of 800×600. The player controls a ship at the bottom edge with the left and right arrow keys and fires with the space bar. Five rows of eight aliens move sideways as a block, step down one row when they reach an edge, and disappear when a shot hits them. The game ends when all aliens are destroyed or an alien reaches the bottom row. Show the score in the top left corner. Do not start a web server.
Implement a pause key (P).
Zwei Prompts und ca. 10 Minuten Geduld reichen aus, um einen spielfähigen Space-Invaders-Klon zu programmieren
Halogen
Der Halogen-Flash-Server ist in seiner Zielrichtung noch fokussierter. Als einziges Modell wird Qwen-3.8-Flash-Next unterstützt. Die Projektseite verspricht die höchste Token-Rate für dieses Modell auf Strix-Halo-CPUs. Der Nachteil: Teile der Software sind nicht Open Source und damit eine Black Box.
Die Installation bzw. Inbetriebnahme ist einfacher als bei Gufo. Auch Halogen setzt auf Podman. Ein einziges Kommando reicht aus, um das Halogen-Image und das Modell herunterzuladen. Weil Halogen eine anders optimierte Variante von Qwen-3.8-Flash-Next verwendet, ist neuerlich ein Download von über 110 GB notwendig (natürlich nur beim ersten Start). Das Modell wird in ~/halogen-models gespeichert. Die API verwendet standardmäßig den Port 8731. Halogen verwendet automatisch die maximale Kontextgröße (262.144 Token) und erlaubt vier parallele Sessions (einstellbar mit der Umgebungsvariablen HALOGEN_KV_SLOTS).
Bei meinen Tests habe ich mit Halogen tatsächlich eine spürbar höhere Geschwindigkeit erreicht (Output zwischen 50 und 60 Token/s). Ich habe einen sehr simplen Benchmarktest durchgeführt und dazu die ersten 40 Aufgaben von HumanEval+ aus EvalPlus 0.3.1 mit Greedy-Decoding und reasoning_effort: low ausgeführt. Halogen brauchte 356 s (61,6 Tokens/s), Gufo 407 s (52,2 Tokens/s), also rund 12 % weniger Zeit bzw. 18 % mehr Durchsatz. Bei der Qualität lagen beide gleichauf: 39 von 40 Aufgaben mit den Original-Tests, mit den erweiterten Tests 37 (Halogen) bzw. 38 (Gufo). Der Test ist zu wenig spezifisch, um echte Qualitätsunterschiede für agentisches Coding festzustellen. Mir fehlt die Zeit, um weitere Tests laufen zu lassen. Immerhin lässt sich sagen: Beide Modelle tun, was sie sollen, und Halogen macht es ein wenig schneller.
Wenn Ihnen der Closed-Source-Black-Box-Charakter von Halogen egal ist, ist Halogen also eine gute Wahl und aktuell vermutlich der schnellste Weg, um Qwen-3.8-Flash-Next auf Strix-Halo-Geräten auszuführen. Gegen das Projekt spricht neben dem fehlenden Quellcode der Umstand, dass keine anderen Sprachmodelle unterstützt werden.
Fazit
Es ist immer wieder überraschend, wie viel Bastelarbeit erforderlich ist, um moderne Sprachmodelle mit offenen Gewichten tatsächlich auszuführen. (Um es noch einmal zu betonen: »Freie« Sprachmodelle sind nicht mit Open-Source-Software zu vergleichen. Zwar ist bei vielen derartigen Modellen immerhin dokumentiert, wie die Gewichte zustande kommen; die Basis des Modells, insbesondere die Trainingsdaten und die genauen Trainingsbedingungen, ist aber nicht zugänglich.)
Um die positiven Aspekte zu nennen: Die real erzielbaren Ergebnisse lokaler Modelle werden von Monat zu Monat besser. Das in diesem Beitrag vorgestellte Modell ist ein gutes Beispiel dafür. Qwen-3.8-Flash-Next schlägt sich in Benchmark-Tests ausgezeichnet. In Kombination mit einer dafür optimierten Engine sind die erzielbaren Token-Raten so hoch, dass ein produktives Arbeiten auf Consumer-Hardware möglich ist.
Die Qualität, Geschwindigkeit und Kontextgröße lokaler Modelle auf Consumer-Hardware kommen natürlich bei weitem nicht an die kommerziellen Modelle auf Cloud-Servern von OpenAI oder Anthropic heran; aber je nach Aufgabenstellung sind freie Modelle mittlerweile gut genug für praktische Arbeiten, z.B. zur Software-Entwicklung mit dem CLI Pi. Das sind gute Nachrichten für alle, die sich Unabhängigkeit und Datenschutz wünschen.
Ehrlicherweise muss ich sagen: Ein Claude-Pro-Abo kostet auch über Jahre gerechnet viel weniger als die für diese Tests erforderliche Hardware. (Mein Testrechner hat Ende 2025 knapp 2500 € gekostet. Mittlerweile ist der Rechner leider fast doppelt so teuer.) Gleichzeitig bieten Claude Code, Codex, Vibe CLI oder andere kommerzielle Angebote mehr Komfort, eine viel höhere Coding-Geschwindigkeit und natürlich, und das ist am wichtigsten, eine deutlich höhere Coding-Qualität. Wenn ich es mir aussuchen darf, werde ich für professionelle Software-Entwicklung also weiter bei den kommerziellen Anbietern bleiben.
Microsoft hat WSLC offiziell freigegeben. Die neue Funktion ermöglicht den Betrieb von Linux-Containern unter Windows und soll dabei stärker voneinander getrennte Umgebungen schaffen. Nach der öffentlichen Vorschau steht WSLC nun allgemein zur Verfügung. Im Mittelpunkt steht das neue Kommando wslc.exe. Damit lassen sich Linux-Container direkt unter Windows verwalten. Microsoft verfolgt dabei einen anderen Ansatz als […]
Gentoo ist bei seiner technischen Infrastruktur auf Unterstützung von außen angewiesen. Mehrere langjährige Sponsoren haben ihre Unterstützung eingestellt, weshalb die unabhängige Linux-Distribution nun nach neuen Partnern sucht, die Server, Rechenzentrumskapazitäten, virtuelle Maschinen oder finanzielle Mittel bereitstellen. Die source-basierte Distribution nutzt den Paketmanager Portage und betreibt verschiedene wichtige Dienste auf eigener Infrastruktur. Da Gentoo nur eine […]

 Anmelden